라이온킹은 햄릿이다.
AI는 이야기를 모른다(4): 명작의 해부도로 명작을 만들 수 없는 이유
나는 2015년부터 기계에게 이야기를 가르치는 일을 해왔다. 엔씨소프트에서 8년, 지금은 KT 미디어본부에서. 직함과 회사는 바뀌었지만 붙들고 있는 질문은 같다. AI는 정말 이야기를 아는 걸까.
AI가 글을 척척 써주는 시대가 됐지만, “그럴듯한 글”과 “좋은 이야기”는 다른 말이다. 그 차이를 현장에서 직접 부딪며 10년을 보냈다. 이 연재는 그 시도와 실패, 그리고 그 과정에서 발견한 것들의 기록이다.
이 칼럼은 룰베이스 시대의 실험부터 LLM 등장 이후까지를 다룬다. AI 글쓰기 도구를 쓰면서 뭔가 부족하다고 느낀 적 있다면, 혹은 창작과 기술 사이 어딘가에 서 있다면, 이 기록이 그 감각에 말을 붙여줄 수 있을 것이다.
1. 하늘 아래 새로운 이야기는 없다
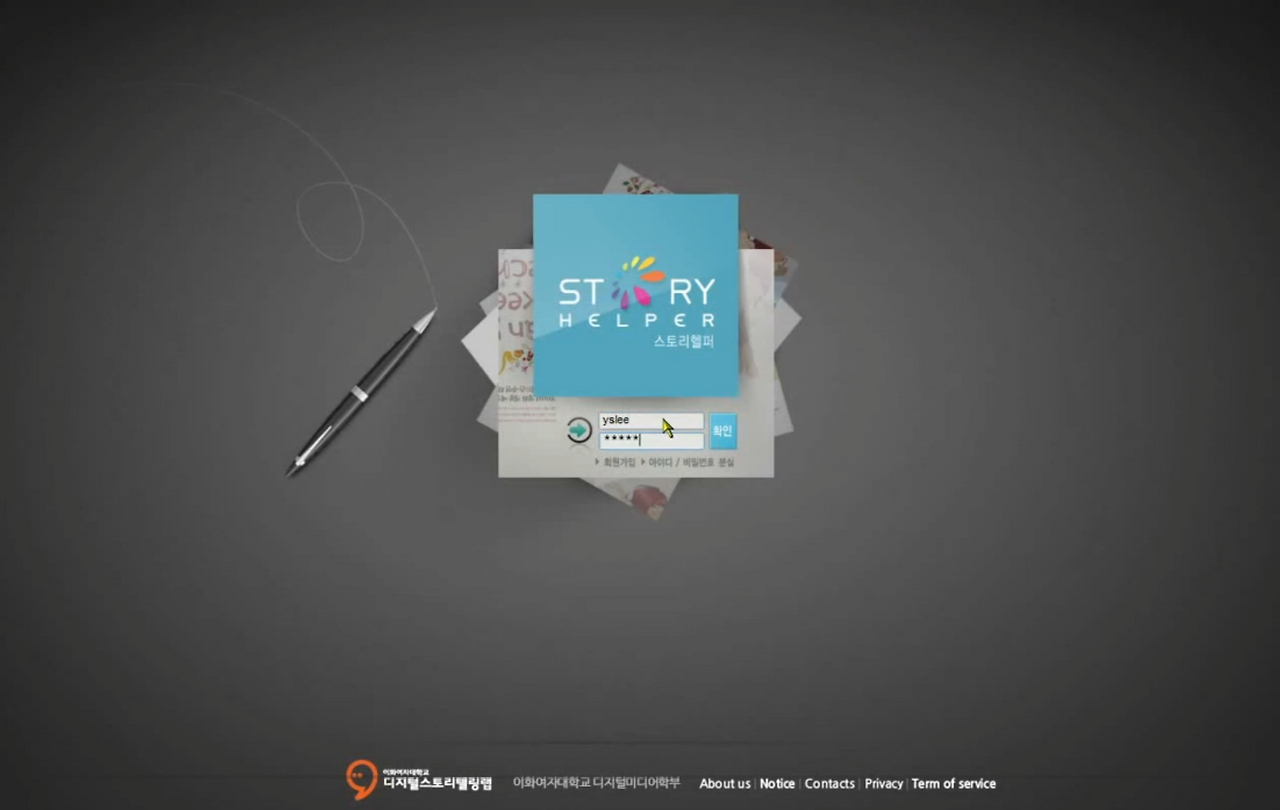 스토리헬퍼 시작 화면
2015년, 대학원 랩실에서 디지털 스토리텔링을 연구하던 시절, 창작 지원 도구인 '스토리헬퍼'를 처음 구동했을 때의 기묘한 감각을 잊지 못한다.
내가 세상에 없던 독창적인 기획이라 믿었던 시나리오를 입력하자, 시스템은 냉정하게 대답했다. 이미 데이터베이스에 존재하는 2,000여 편의 영화 어딘가에 당신의 플롯이 있다고. 화면이 보여준 진실은 명확했다. <라이온킹>의 뼈대는 <햄릿>과 완벽히 일치했다. 왕위를 노린 삼촌에게 아버지를 잃은 왕자가 방황 끝에 복수하는 구조.
그런데 기묘하게도, 나는 한 번도 <라이온킹>을 보며 <햄릿>을 떠올린 적이 없었다. 주인공이 '사자 심바'라는 그 압도적인 디테일 하나가, 내 뇌로 하여금 완전히 새로운 이야기로 인지하게 만들었기 때문이다.
실망이 아니라 흥미가 돋았다. 질문이 꼬리를 물었다.
'이야기의 본질은 보편적인 구조에 있는가,
아니면 그 구조를 채우는 낯선 디테일에 있는가.'
학부 시절부터 디지털 스토리텔링에 매료되어 있던 나에게 이 질문은 거대한 자석 같았다. 스토리를 구조화하고 데이터화해서 조립하면 흥미로운 이야기가 나오는 공식에 닿을 수 있을까. 스토리헬퍼는 그 질문에 가장 정직하고 학문적으로 응답하려 했던 시스템이었다.
2. 흥미로움과의 거리를 계산하다
스토리헬퍼의 전제는 단순하고도 강력했다.
"하늘 아래 새로운 이야기는 없다.
오직 새롭게 느껴지는 담화만 있을 뿐이다."
이 가설을 증명하기 위해 이화여대 디지털스토리텔링 연구소와 엔씨문화재단은 3년간 천재들의 변덕스러운 영감을 해부했다. 2000여 편의 명작 영화들을 3막 8장 16시퀀스 36 에피소드 110개 장면으로 쪼개고 , 장면마다 인물의 상태변수, 욕망, 모티프, 시스템 동사의 인과율 등을 촘촘히 태깅했다. 구축된 데이터베이스 요소만 11만 건이 넘는, 그야말로 콘텐츠계의 '팔만대장경'이었다.
이제 사용자가 질문에 답할 차례다. 인물의 신분, 직업, 욕망, 결혼 여부 등 29개의 항목을 채워 넣으면 시스템은 결과를 내놓는다.
"당신이 입력한 줄거리는 <늑대와 춤을>과 87% 유사합니다."
이 한 줄에 서비스의 위대함과 한계가 동시에 압축되어 있다. '이 이야기는 흥미로운가?'라는 주관적이고 답할 수 없는 질문을, '이 이야기는 검증된 명작과 얼마나 닮았는가?'라는 객관적이고 측정 가능한 질문으로 치환한 것이다. 흥미로움을 직접 정의하는 대신, 흥미로움과의 거리를 계산했다. 그 거리를 좁혀가면 언젠가 닿을 수 있다는 믿음이었다.
지금 바로 작가의 멤버십 구독자가 되어
멤버십 특별 연재 콘텐츠를 모두 만나 보세요.
기계에게 이야기를 가르치는 사람. AI가 글을 척척 써주는 시대에, "이게 좋은 이야기인가"라는 질문이 왜 여전히 인간의 몫인지를 현장의 언어로 기록한다.
오직 멤버십 구독자만 볼 수 있는,
이 작가의 특별 연재 콘텐츠
- 총 7개의 혜택 콘텐츠