가장 싸게 틀려라
2026 All-Day-Project (137/365)
5장. 가장 싸게 틀려라 (이 글)
6장: 수확은 해석이다
프롤로그: "MVP 만들자"라는 말의 함정
흔한 회의 장면입니다.
"우리 MVP 만듭시다." PM이 말합니다. 팀이 고개를 끄덕입니다. 그리고 다음 주부터 기획이 시작됩니다. 화면이 그려지고, API가 설계되고, 데이터베이스 스키마가 만들어지고, 프론트엔드가 붙고, 테스트가 돌아갑니다. 두 달이 지나고, 세 달이 지나고, 네 달이 지납니다. 런칭 날, PM은 당당하게 말합니다.
"이게 우리 MVP입니다."
문제는 이것이 MVP가 아니라는 것입니다. 그것은 그냥 기능이 조금 적은 제품입니다.
그것도 네 달 걸린 제품.
농부도 같은 함정에 빠집니다.
"올해는 신품종을 시험 파종 해봅시다." 이 말을 해놓고, 다음 날 밭 전체에 그 신품종 씨앗을 뿌립니다. 한 봉지가 아니라, 스무 봉지를. 밭 귀퉁이의 작은 모판에 먼저 키워보자는 말은 어디 갔는지 모릅니다. 수확 전까지는 아무것도 확인할 수 없고, 가을이 되어 수확을 해보니 그 품종이 이 지역 기후에 맞지 않습니다. 한 해 농사가 전부 날아갑니다.
"시험"이라는 단어는 그대로 있습니다. 그런데 시험답지 않게 진행됐습니다. 실패해도 한 이랑만 잃어야 할 일을, 밭 전체를 걸고 했기 때문입니다.
이 장에서 이야기할 것은 하나입니다. 실험은 맞히는 것이 아니라 배우는 것이고, 배우려면 가장 싸게 틀려야 한다는 것. "가장 싸게 틀리는" 농부는, 그 실패 비용이 한 이랑입니다. "가장 비싸게 맞히려는" 농부는, 실패 비용이 밭 전체입니다. 같은 정보를 얻기 위해 얼마를 쓸 것인가 — 이게 실험 설계의 전부입니다.
1. MVP의 진짜 정의 — "학습 도구"
Eric Ries는 The Lean Startup에서 MVP를 이렇게 정의했습니다.
"새 제품의 한 버전으로, 팀이 가장 적은 노력으로
가장 많은 검증된 학습을 고객으로부터 모을 수 있게 해주는 것."
이 정의에는 "작은 제품"이라는 말이 한 번도 나오지 않습니다. 대신 두 개의 축이 있습니다. 최소한의 노력과 검증된 학습. MVP는 기능의 크기가 아니라, 배움을 얻기 위한 도구의 크기를 의미합니다.
이 구분이 결정적입니다. MVP가 "기능이 적은 제품"으로 이해되면, 결과물은 대개 이렇게 됩니다. 팀이 "뭐가 최소인가"를 논쟁합니다. 기획자와 디자이너와 개발자가 각자 다른 "최소"를 가지고 있고, 결국 합의된 "최소"는 세 사람 의견의 합집합입니다. 두 달이 세 달이 됩니다.
반면 MVP가 "학습 도구"로 이해되면, 질문이 완전히 달라집니다. "우리가 배우고 싶은 건 무엇인가?" "그 배움을 얻으려면 최소한 뭐가 필요한가?" 답은 종종 놀랍게 작습니다. 랜딩 페이지 한 장. 3분짜리 비디오. 사람이 뒤에서 수동으로 처리하는 서비스. 코드 한 줄 없는 것도 많습니다.
MVP의 전제 조건은 네 가지입니다.
검증할 가설이 먼저 있어야 합니다. "사람들이 X를 원할 것이다." 이 문장이 없으면, MVP는 그냥 작은 제품이 됩니다.
그 가설을 검증하기 위한 최소한의 것을 만듭니다. 기능이 아니라, 가설에 대한 답을 줄 수 있는 가장 작은 것.
사용자 행동을 수집합니다. 설문이 아니라 행동입니다. "원하세요?"에 "네"라고 답하는 것과, 실제로 가입 버튼을 누르는 것은 다른 데이터입니다.
그 데이터를 기반으로 Pivot / Persevere / Kill 결정을 내립니다. 이건 다음 장의 주제입니다.
이 네 개가 지켜지지 않으면, MVP라는 이름이 붙어 있어도 실은 MVP가 아닙니다. 진보의 단위는 제품의 크기가 아니라 검증된 학습(validated learning) 입니다. Ries가 이 용어를 만든 이유는, 팀이 "우리가 발전하고 있다"고 착각하는 순간이 너무 많기 때문입니다. 코드를 많이 짠 것은 발전이 아닙니다. 고객에 대해 더 많이 알게 된 것이 발전입니다.
2. 루프를 거꾸로 설계하라
Ries의 Build-Measure-Learn 루프는 대부분의 PM이 이름만 알고 있습니다. Build하고, Measure하고, Learn한다. 이름 순서대로요.
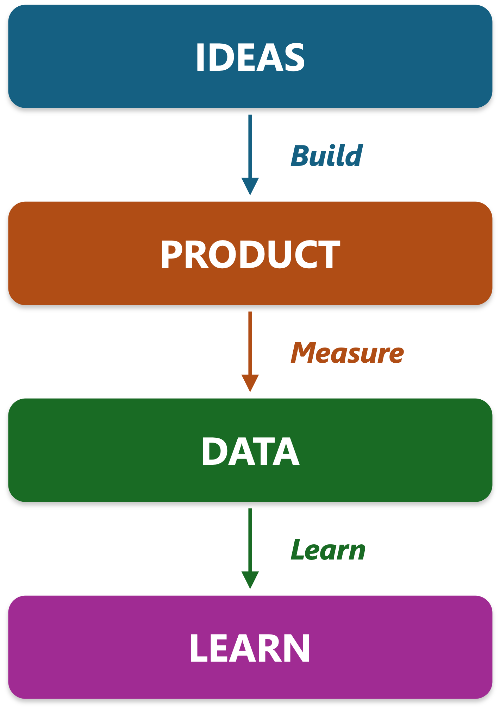
함정은 이름 순서대로 사고하는 것에 있습니다. 그러면 "뭘 만들까?"가 첫 질문이 됩니다. 그리고 우리가 이미 알고 있듯, "뭘 만들까?"에는 끝이 없습니다. 팀이 만들 수 있는 것은 언제나 만들어야 할 것보다 많습니다.
실제로는 루프를 거꾸로 설계해야 합니다. Learn → Measure → Build.
뭘 배우고 싶은가? — "사람들이 이 가격에 돈을 낼 의향이 있는가?", "이 기능이 리텐션을 움직이는가?"
어떤 데이터가 있으면 알 수 있는가? — "결제 버튼 클릭률 10% 이상", "주 2회 방문율 30% 이상"
그 데이터를 얻기 위해 최소한 뭘 만들어야 하는가? — 이때 처음으로 "빌드" 단계가 등장합니다.
이 순서로 생각하면 "만들어야 할 것"의 크기가 거의 항상 극적으로 작아집니다. 왜냐하면 학습에 필요한 것이 제품 전체가 아니기 때문입니다. 대부분의 경우, 가설 하나를 검증하는 데 필요한 건 가설 하나에 대한 답만입니다.
그리고 이 루프에는 또 하나의 핵심이 있습니다. 루프를 빨리 돌리는 것. 3개월짜리 MVP는 3개월에 한 번 배웁니다. 3일짜리 Fake Door는 3일에 한 번 배웁니다. 같은 기간 동안 전자가 한 번 배울 때 후자는 서른 번 배웁니다. 서른 번 더 많이 배운 팀이 어떤 제품을 만들지는 쉽게 상상할 수 있습니다.
학습의 속도 자체가 경쟁력입니다. 이걸 내면화한 팀은 "이번에 맞혀야 한다"는 압박에서 벗어납니다. 어차피 다음 주에 또 배울 테니까요.
3. 프리토타이핑 — 프로토타입 이전의 질문
Google 엔지니어링 디렉터였던 Alberto Savoia는 The Right It에서 이런 구분을 제시했습니다.
프리토타입(Pretotype): "이것을 만들어야 하는가?"를 검증합니다. 수요와 관심의 문제.
프로토타입(Prototype): "이것을 만들 수 있는가?"를 검증합니다. 기술적 실현 가능성.
둘의 순서가 중요합니다. 우리는 습관적으로 프로토타입부터 만듭니다. 만들 수 있다는 걸 증명한 다음, "자, 이제 사람들이 원하는지 볼까?"로 넘어갑니다. 그런데 이 순서로 가면, 만들 수 있지만 아무도 원하지 않는 것을 만들게 됩니다. Savoia의 통찰은 이것입니다.
"제대로 만들기(Build It Right) 전에,
제대로 된 것(The Right It)을 만들고 있는지 확인하라."
프리토타이핑의 기법 중 하나는 Pretend-to-Own, "소유한 척 테스트"입니다. 제품을 만들기 전에, 자기 자신이 그것을 쓰는 상황을 하루만 흉내 내봅니다. 바카라상 위에 가짜 제품 아이콘을 놓고, 하루에 몇 번이나 그걸 "쓰고 싶은지"를 세어봅니다. 대부분의 경우, 자기 자신조차 쓰지 않을 제품을 만들고 있다는 걸 깨닫게 됩니다. "나는 안 쓸 건데 누군가는 쓰겠지"는 MVP의 숨은 사망 원인 1위입니다.
4. 실험의 스펙트럼 — 가장 싼 것부터
실험은 하나가 아닙니다. 비용과 속도와 검증하는 것이 다른 여러 가지 실험이 있습니다. PM이 할 일은 가설에 맞는 가장 싼 실험을 고르는 것입니다.
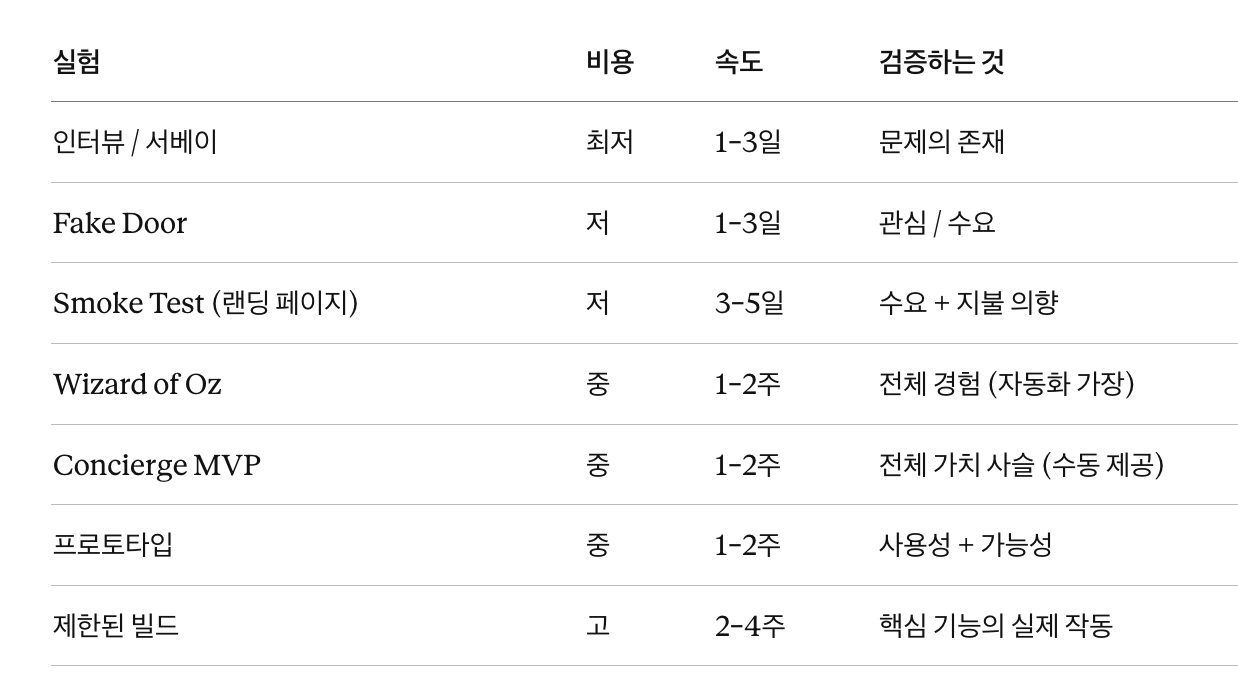
각각을 조금 더 자세히 보겠습니다.
Fake Door.
아직 존재하지 않는 기능이 있는 것처럼 UI에 버튼을 올려둡니다. 클릭하면 "준비 중입니다"와 대기자 등록 화면이 뜹니다. 측정하는 건 클릭률입니다. "이 기능 원하세요?"라는 질문보다 훨씬 신뢰할 수 있는 데이터입니다.
설문에서 "네"라고 답하는 사람과 실제로 버튼을 누르는 사람은 완전히 다른 사람들입니다.
주의할 점은 두 가지입니다. 첫째, 투명성. 클릭 후에는 "이것은 테스트 중인 기능입니다"를 반드시 공개해야 합니다. 기만과 탐색 사이에는 선이 있고, 그 선을 넘으면 신뢰를 잃습니다. 둘째, 남용 금지. 같은 사용자가 서너 번 Fake Door에 부딪히면, 제품 전체에 대한 신뢰가 흔들립니다. 한 번에 하나, 기간을 정해서.
Smoke Test (랜딩 페이지).
제품 없이 랜딩 페이지만 만들어 수요를 측정합니다. Buffer가 교과서입니다.
2010년, Joel Gascoigne는 Buffer를 만들기 전에 먼저 2페이지짜리 웹사이트를 만들었습니다.
첫 페이지에 Buffer의 설명과 "Plans and Pricing" 버튼. 누르면 이메일 등록 페이지. 트위터에 링크를 뿌렸고, 사람들이 이메일을 남겼습니다. "원하는 사람이 있다"는 1단계 검증.
하지만 Gascoigne는 여기서 멈추지 않았습니다. 두 페이지 사이에 가격표 페이지를 끼워 넣었습니다. Free와 Paid를 골라야 이메일 등록으로 넘어갈 수 있게요. 한 단계를 더 두니까, 진짜 관심 있는 사람만 남았습니다. 그리고 "Paid"를 누른 사람의 비율을 쟀습니다. "돈을 낼 의향이 있는 사람이 있다"는 2단계 검증.
두 페이지의 웹사이트로 수요와 가격을 다 검증한 뒤에야, Gascoigne는 코드를 짜기 시작했습니다. 핵심 기능(하루 5번 트윗 예약) 하나만 만들고 7주 만에 런칭했고, 런칭 4일 만에 첫 유료 고객을 확보했습니다. "만들기 전에 팔리는지 확인한다"의 가장 선명한 사례입니다.
Wizard of Oz.
사용자 눈에는 자동화된 시스템처럼 보이지만, 뒤에서 사람이 수동으로 처리하는 실험입니다. 프론트엔드는 완성된 것처럼 보이지만, 백엔드는 엑셀 스프레드시트와 사람 손입니다. 사용자는 이 사실을 모릅니다. 이것이 가능한 이유는, 검증하려는 것이 "자동화의 기술적 구현"이 아니라 "전체 사용자 경험" 이기 때문입니다. 기술이 없어도 경험은 있습니다.
Concierge MVP.
Wizard of Oz와 비슷하지만 한 가지가 다릅니다. 사용자가 수동 서비스임을 압니다. 예를 들어 "개인 비서가 직접 당신의 일정을 관리해드립니다"라고 명시적으로 말하고 시작합니다. 자동화의 환상은 없지만, 대신 사용자와 직접 대면할 수 있습니다. 설문이나 인터뷰로는 절대 알 수 없는 깊은 맥락이 드러납니다.
Food on the Table이 좋은 예입니다. CEO Manuel Rosse는 슈퍼마켓에 직접 가서 쇼핑객을 만났습니다. 월 10달러에 맞춤 레시피와 쇼핑 리스트를 손으로 만들어 제공했습니다. 고객과 함께 매장을 돌며 어떤 상품 앞에서 멈추는지, 어떤 결정을 내리는지 관찰했습니다. 그렇게 수요와 행동 패턴을 파악한 후에야 자동화로 넘어갔습니다.
이 순서가 중요합니다. 수동으로 시작하면, 자동화할 때 무엇을 자동화해야 하는지 알게 됩니다. 처음부터 자동화하면, 잘못된 것을 자동화할 수 있습니다. 그리고 자동화된 잘못은, 수동 잘못보다 훨씬 고치기 어렵습니다.
5. 실험 카드 — 기준을 먼저 정하지 않으면 실험이 아니다
실험을 "실험답게" 만드는 구조가 필요합니다. 그렇지 않으면 실험은 사후 해석의 경연장이 됩니다. "클릭률 3% 나왔어요"라는 결과를 보고, 누군가는 "와, 이 정도면 수요가 있는 거네!"라고 해석하고, 누군가는 "3%? 너무 낮은데?"라고 해석합니다. 같은 숫자에서 반대 결론이 나옵니다.
이 함정을 막는 방법은 하나입니다. 실험 시작 전에 성공 기준을 정하는 것. David Bland와 Alex Osterwalder가 Testing Business Ideas에서 정리한 Experiment Card는 이걸 구조화합니다.
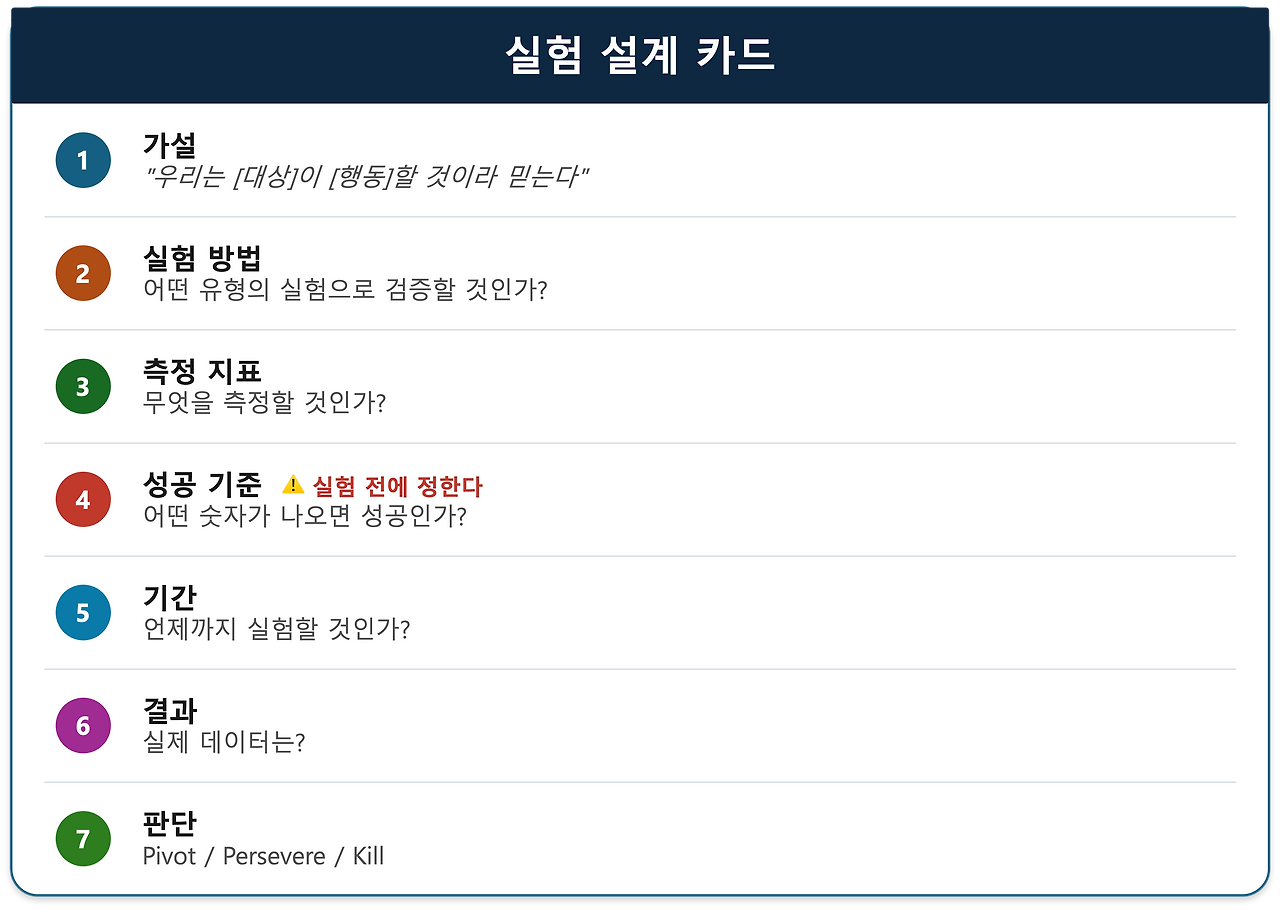
이 카드의 4번 항목이 전부입니다. "성공 기준"은 반드시 실험 시작 전에 정해야 합니다. 실험이 끝난 뒤에 기준을 만들면, 그 기준은 결과에 맞춰 조정됩니다. 인간의 뇌는 그렇게 작동합니다.
구체적인 예를 들면, "결제 의향 Fake Door를 돌린다. 성공 기준은 클릭률 8% 이상, 100명 이상의 데이터. 이 둘 중 하나라도 못 넘기면 Kill, 둘 다 넘기면 다음 실험(Smoke Test)으로 진행"이라는 식입니다. 숫자가 애매하면 정해둔 뜻이 없어지고, 팀원마다 다른 해석이 나옵니다.
실험이 끝났을 때의 판단은 세 가지입니다. Persevere(계속 간다), Pivot(방향을 튼다), Kill(접는다). 이 셋의 기준도 실험 전에 정해둬야 합니다. 다음 장에서 이 판단을 본격적으로 다룹니다.
마지막으로 빠뜨리면 안 되는 한 가지. 실험은 퍼널의 어느 단계를 검증하는지 명확해야 합니다. Dave McClure의 AARRR(Acquisition, Activation, Retention, Revenue, Referral)을 기억하세요.
Acquisition이 문제인데 Revenue 실험을 하면, 성공해도 의미가 없습니다. 사용자가 오지 않는데 사용자당 매출을 재봐야 무슨 소용인가요. 실험을 시작하기 전에 "우리 퍼널에서 가장 약한 고리가 어디인가"를 먼저 정해야 합니다.
6. 세 개의 사례: 코드보다 앞선 증거
Dropbox의 3분 비디오. 2007년, Drew Houston은 이미 작동하는 프로토타입을 가지고 있었습니다. 문제는 설명이었습니다. "파일이 자동으로 여러 기기에 동기화된다"는 개념이 당시엔 너무 생소해서, 말로 설명하면 사람들이 멍한 얼굴을 했습니다.
Houston은 코드를 더 짜지 않았습니다. 대신 3분짜리 스크린캐스트를 만들었습니다. 실제 제품 시연을 포함시키되, 사용 시나리오와 유머(팬덤들이 알아볼 만한 참조)를 섞었습니다. 2007년 4월 5일 Hacker News에 올렸습니다.
대기자 목록이 하루 만에 5,000명에서 75,000명으로 뛰었습니다. 15배. Houston이 한 일은 기술 개선이 아니라 가치를 보여주는 방법을 찾은 것이었습니다. 그리고 그 방법은 비디오였지 코드가 아니었습니다. 가설 하나("사람들이 이 가치를 원하는가")를 3분으로 검증한 것입니다.
Zappos의 신발 사진. Nick Swinmurn은 "사람들이 온라인으로 신발을 살까?"라는 질문을 갖고 있었습니다. 1999년의 일입니다. 이 질문에 답하기 위해 필요한 건 창고도, 재고 시스템도, 물류 파트너도 아니었습니다. 그 질문에 대한 답이었습니다.
그래서 그는 동네 신발 매장에 가서 이렇게 말했습니다. "사진을 찍어 온라인에 올릴게요. 팔리면 정가에 사서 고객에게 보낼게요." 그게 전부였습니다. 주문이 들어오면 직접 매장에 가서 신발을 샀고, 포장해서 보냈습니다. 사람이 모든 걸 수동으로 처리했습니다.
주문이 들어왔습니다. 가설이 검증됐습니다. 창고도 재고도 자동화도 없이 "온라인에서 신발이 팔린다"는 사실이 증명됐습니다. Zappos는 나중에 Amazon에 12억 달러에 인수됩니다. 그 12억 달러의 첫 증거는, 매장을 돌며 신발 사진을 찍던 한 사람의 발이었습니다.
Groupon의 WordPress. Andrew Mason의 첫 시도였던 The Point(집단행동 플랫폼)는 10개월 동안 만들었지만 실패했습니다. 그는 같은 집단행동 개념을 로컬 딜에 적용해보고 싶었습니다.
이번에는 다르게 했습니다. 블로그 플랫폼 WordPress를 커스터마이즈해 "Groupon"이라고 이름을 붙였습니다. 매일 하나의 딜을 포스팅했습니다. 쿠폰은 FileMaker라는 맥용 데스크톱 앱으로 만들었고, 로컬 컴퓨터의 스크립트가 메일링 리스트에 발송했습니다. 티셔츠 같은 상품은 주문 폼이 없어서, 사용자가 색상과 사이즈를 이메일로 요청해야 했습니다.
조잡했습니다. 당황스러울 정도로요. 시카고의 "2-for-1 피자" 딜로 시작해 한 달 만에 가설이 검증됐습니다. The Point을 만드는 데 10개월 걸렸는데, Groupon을 검증하는 데 1개월이 걸렸습니다. 도구의 조잡함은 가설 검증과 무관했습니다. WordPress + FileMaker + 이메일이면 충분했습니다. 중요한 건 가설이 검증됐다는 것, 그 하나였습니다.
세 사례의 공통점은 하나입니다. 엔지니어링은 증거 다음에 온다는 것. 증거가 나오기 전의 엔지니어링은 대부분 낭비입니다. 증거가 나오면, 그때 필요한 만큼만 짓습니다.
7. 오늘부터 할 수 있는 작은 실천
지금 팀에서 "만들까 말까" 고민 중인 것 하나를 꺼내봅니다. 아직 만들기 시작하지 않았거나, 이제 막 시작한 것이면 더 좋습니다.
가설을 한 문장으로 적습니다. "우리는 [누가] [무엇을] [어떤 조건에서] 할 것이라 믿는다."
구체적일수록 좋습니다. "사람들이 원할 것이다"는 가설이 아닙니다. "30대 온라인 게임인이 월 1만원에 A 기능에 가입할 것이다"는 가설입니다.
뭘 배우고 싶은지 명확히 합니다.
Desirability(원하는가)? Viability(돈을 낼 의향이 있는가)? Usability(쓸 수 있는가)? 이 세 개 중 가장 위험한 가정이 뭔지를 3장의 Assumption Mapping에서 이미 찾았을 것입니다.
가장 싼 실험을 고릅니다.
위의 스펙트럼에서 위에서부터 내려갑니다. 인터뷰로 충분하면 인터뷰. Fake Door로 충분하면 Fake Door. 스프레드시트 뒤에 사람이 있어도 되면 Wizard of Oz. "빌드"는 마지막 선택지입니다.
실험 카드를 채웁니다. 특히 4번(성공 기준)을 실험 시작 전에 정합니다.
"클릭률 5% 이상, 100명 이상의 데이터" 같은 구체적인 숫자로. 애매하면 아무 의미가 없습니다.
일정을 정하고, 기간을 엄수합니다. 1~2주를 넘기지 마세요.
넘어가면 실험이 프로젝트가 되고, 프로젝트는 기대가 되고, 기대는 매몰 비용이 됩니다. 다음 장의 주제입니다.
이 다섯 단계를 한 번만 제대로 돌려도, 팀의 "만들자"라는 말 뒤의 거리감이 확 줄어듭니다. 만들자는 말 뒤에는 반드시 "무엇을 배우려고?"가 붙게 되고, 그 질문이 붙는 순간 낭비의 90%가 사라집니다.
에필로그: 한 이랑만 잃어라
좋은 농부는 밭 전체에 새 품종을 뿌리지 않습니다. 한 이랑만 시험 파종합니다. 그 한 이랑은 귀중한 밭의 1/30이지만, 한 해의 정보를 얻기에는 충분합니다. 실패해도 1/30만 잃고, 성공하면 나머지 29/30을 다음 해에 자신 있게 씁니다.
이 계산은 단순해 보입니다. 하지만 이 계산을 PM의 회의실로 옮기면 많은 사람들이 당황합니다. "1/30만큼 만든다고요? 너무 작지 않나요? 제대로 된 테스트가 되나요?" 그런데 좋은 실험에 필요한 건 제품의 크기가 아니라, 가설에 대한 답을 줄 수 있는 최소한입니다. 가설이 "사람들이 원하는가?"라면, 답은 비디오 하나로도 나옵니다. 가설이 "돈을 낼 의향이 있는가?"라면, 답은 2페이지 웹사이트로도 나옵니다.
그리고 그 작은 실험이 한 주에 한 번, 두 주에 한 번 반복되면, 팀은 한 달에 두세 번씩 배웁니다. 한 달에 두세 번 배우는 팀은, 한 달에 한 번도 배우지 못하는 팀에게 몇 달 뒤엔 따라잡힐 수 없는 격차를 만듭니다.
"Make sure you are building The Right It before you build It right."
— Alberto Savoia
실험의 목적은 맞히는 것이 아닙니다. 배우는 것입니다. 그리고 배우는 가장 좋은 방법은, 가장 싸게 틀리는 것입니다. 싸게 틀릴수록 더 자주 틀릴 수 있고, 더 자주 틀릴수록 더 많이 배웁니다.
다음 장에서는, 실험이 끝난 뒤의 가장 어려운 일을 다룹니다.
데이터를 해석하는 것. 같은 숫자를 보고 누군가는 "가능성이 보인다"고 하고, 누군가는 "접어야 한다"고 합니다. Pivot, Persevere, Kill을 가르는 기준.
그리고 그 판단을 방해하는 확증 편향, 매몰 비용, 결과로만 판단하기의 덫.
수확은 숫자가 아니라 해석이라는 이야기입니다.