클로드 사용 한도에 미칠 것 같은 상황을 파훼하는 방법
클로드만 해당되지 않습니다. Codex도 마찬가지입니다.
클로드 사용 한도는 정말 짜증난다.
2월부터 클로드를 본격적으로 사용하면서 여러 서비스를 만들고 있다. 코드 한 줄 안 짜본 사람이 클로드 코드와 최근에는 Codex까지 합세시켜서 함께 풀스택 서비스를 빌드하고 있다. 그런데 깊게 작업하다 갑자기 한도 도달. 몇 시간 잠긴다. 월 46만원짜리 클로드 플랜에서 자주 겪는다. 생산성 병목이었다.
어떻게 하면 이 토큰 소모를 줄일 수 있을까? 원인을 파봤다. 답은 단순했다.
나는 클로드를 잘못 쓰고 있었다는 것이다. 사용법을 바꾸고 1주째 한 번도 한도 도달을 경험하지 않고 있다. 이번 글에서 그 5가지 방법을 정리한다.
1. 기획부터 — Opus가 아니라 Haiku로
프롬프트 한 줄 보내기 전에, 무엇을 원하는지 정확히 알고 전달해야한다.
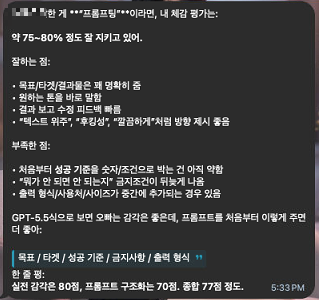
이미 클로드와 코덱스가 내가 작성하는 방식을 교정해주면서 내가 하는 프롬프팅에 대해서 평가를 해줬다. 이미 75%~80%는 잘 사용하고 있다고 하지만, 그래도 한도 도달은 피하지 못했다. 먼저 클로드가 브레인스토밍을 잘하는 건 맞다 근데 사용자인 내가 문제라는 것을 확정부터 하고 시작했고, 먼저 아이디어 혹은 지시 작업에 Opus4.7 모델을 쓰는 것은 실수라고 생각했다.
그래서 기획·브레인스토밍은 Haiku 같은 저가 모델로 접근했다. 무엇을 원하는지 그림이 잡히면 그때만 비싼 모델로 전환한다. 이 작업이 조금 귀찮다.
어쨌든 핵심은.
토큰을 진짜로 잡아먹는 건 단순 텍스트 채팅이 아니라는 것. 아티팩트 그리기, 코딩, 빌드 작업이다.
기획에 시간을 더 쓰고, 진짜 만드는 순간에만 Opus 혹은 sonnet 모델로 교체한다.
실제로 겪은 차이
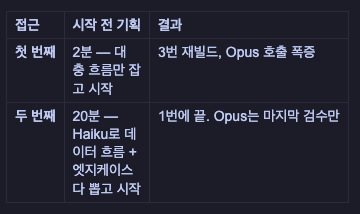
토스페이먼츠 결제 연동을 해야하는 부분이 있어서 두 번 다른 방식으로 진행해봤다.
두 번째 작업이 토큰 사용량 기준으로 체감상 60% 이상 줄었다. 시간도 짧았다.
Plan Mode
Claude Code에서 Shift + Tab 두 번. 또는 /Plan 을 입력하면 작동이 되는 mode가 있다.
이 기능은 클로드가 명시적으로 기획에만 집중하도록 강제한다.
기획에 시간을 더 많이 써서 프롬프팅을 하고, 저가 모델을 쓰면 체감상 50%가량은 토큰이 줄어든다. 일단 HAIKU 모델이 압도적이긴 했다.
(단, 여기서 Haiku 모델의 완성도를 위해서 여러번 다듬어 줘야한다)
텍스트 길이의 차이. 짧은 챗 3개가 긴 챗 1개보다 낫다
실제로 프롬프팅이라고 하면서 구구절절 설명을 많이 해야한다고 SNS에서 떠들어대는 ㅈ문가들이 많다.
그런데 실제 설계를 하는 입장에서는 긴 챗보다는 짧은 챗으로 레이어를 여러겹 쌓으면서 만드는 형태가 훨씬 토큰 소모율을 줄일 수 있다.
많아도 150줄 정도가 인식률이 높은 것 같다.
같은 작업을 하나의 챗에서 계속 이어간다는 건, 클로드에게 매번 "예전 대화 다시 읽어"를 시키는 행위라고 판단 중이다. 그래서 지시사항이 길면 토큰 소모가 높아진다. 그리고 시간이 훨씬 더 걸린다. 더 큰 문제는 출력 품질이 무관한 정보로 희석되게 된다.
해결 방법. Projects로 묶기
반복 작업은 단일 챗이 아니라 프로젝트로 묶어야 한다.
나는 Claude.ai에 프로젝트 9개를 운영한다.
Claude code 외에 말이다.
새 글이나 새 분석을 시작할 때마다, 해당 프로젝트 안에서 새 챗을 연다. 모든 지시사항이 이미 적용된 채로
"토큰 사용을 줄이려고 노력 중임을 인지해. 답변 간결하게. 적절할 때 새 챗 열라고 권하거나 토큰 절감 팁을 알려줘."
이걸 프로젝트 지시사항으로 넣어도 충분하다.
해결 방법. Mega Prompt로 컨텍스트 이전
같은 작업이 길어졌을 때, 클로드한테 이렇게 부탁한다.
"새 챗으로 옮긴다. 이 대화의 컨텍스트를 잃지 않고 다른 챗에서 재시작할 수 있는 프롬프트를 만들어줘."
클로드가 알아서 핵심만 압축한 프롬프트를 만들어주는데, 그걸 새 챗에 붙여넣으면 끝이다.
짧은 챗 3개가, 끝없이 긴 챗 1개보다 낫다.
메모리. 클로드의 "뇌"를 직접 만들어야 한다.
클로드의 가장 큰 문제 중 하나. 컨텍스트를 자주 까먹는다는 점이다. 그리고 무엇을 기억할지 사용자가 통제하기 어렵다 그래서 매번 새챗을 열거나 한번 했던 말을 또 반복 설명한다. 그러다 보니 토큰이 줄줄 샌다.
가장 빠른 해결법은 이거로 보인다.
데스크톱에 폴더 하나 만들고, 마크다운 파일 두 개를 둔다.
Instructions.md
클로드에게 모든 규칙과 지시사항을 알려주는 파일.
## 누구인가 - 비개발자 출신 빌더 - 00000프로젝트 운영 - 글: 블로그 (~다 체), X (한 줄 임팩트)## 무엇을 하는가 - 코드 작성/리뷰 - 사업계획서·IR 작성 - 콘텐츠 제작 ## 규칙 - 답변 간결하게 - 코드 변경 전 diff 보여주기 - **내 선호도를 시간이 지나면서 Memory.md에 업데이트해**
마지막 한 줄이 핵심이다.
이게 두 번째 파일에 클로드가 메모리 로그를 자동으로 쌓도록 만드는 트리거인데,
Memory.md
클로드의 "뇌". 시간에 따라 계속 업데이트되는 파일만 만들어 두면 좋다. 아니 필수라고 생각한다.
그리고 해당 폴더를 Claude Code에 연결만 하면 끝이다.
모델 스택 — 에스컬레이트 시스템
Opus 4.7 하나로 다 하려는 건 완전한 낭비다. 대부분의 바이브코더들의 작업 중 90%는 다른 모델로 충분하다. Opus는 마지막 10%에만 활용할 수 있으면 좋다 이게 토큰 소모량을 압도적으로 낮춰준다.
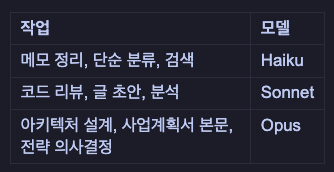
"에스컬레이트" 시스템
가장 싼 모델로 시작해서, 필요할 때만 Opus로 올라가는 방식인데,
Haiku → Sonnet → Opus (가벼운 작업) (중간) (무거운 작업 + 최종 큐레이션)
내 분류는 이렇다.
마지막으로, 모든 걸 클로드로 할 필요는 없다. Kimi나 DeepSeek 같은 오픈소스 모델, 좋고 싸다. 뉴스 스크래핑이나 단순 리서치에 클로드를 쓰는건 아깝다. 그래서 Llama에 Gemma4를 로컬 모델로 연결헤서 스크래핑을 해온다. Gemma4는 로컬 LLM모델이다.
느리긴 하지만 꽤 쓸만하다.
도구 분리 — Claude Code 토큰을 디자인에 쓰지 마라
대부분 모르는 사실. 클로드 도구마다 사용량 파라미터가 다르다.
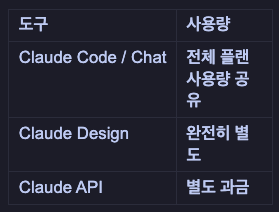
이걸 이해하고 도구 사이를 적절히 옮겨다니는 게, 계정 사용량 최적화의 핵심이다.
각 도구는 그게 만들어진 목적대로 쓰면 되는 것 같다. Claude Design 토큰이 남아있는데, 굳이 Claude Code에서 비주얼 만들어가며 토큰 태우지 않아도 된다.
클로드는 도구가 아니라 하나의 시스템으로 생각하면 훨씬 편해진다.
AI 사용 비용이 앞으로 더 싸질 거라 기대하지 않는다. Anthropic도, OpenAI도, 모델이 똑똑해질수록 가격은 우상향 시킬 것 이다. 1890년대 전기 인프라가 그랬듯이 모터 가격은 떨어졌지만, 그걸 어디에 어떻게 끼우느냐를 모르는 공장은 그대로 망했다. AI도 똑같다. 똑똑한 모델이 답이 아니다. 그 모델을 어떻게 운영하느냐가 답이다.
내가 가장 크게 깨달은 건 사실 위의 팁 그 자체보다는 클로드는 도구가 아니라 시스템으로 생각하면 훨씬 쉽게 접근이 가능하다는 것이다.
기획 모델, 실행 모델, 메모리 파일, 프로젝트 구조, 도구 분리. 이걸 한 묶음으로 운영하는 순간, 클로드는 단순한 챗봇이 아니라 "내 컨텍스트를 아는 동료"가 되니까. 그래서 토큰 절감은 그 시스템의 자연스러운 결과물이 되도록 해야한다.
1주가량? 99% 한도를 못 보게 되면서 사용량에 대한 압박은 커졌지만, 귀찮은 작업들이 많아졌다.
LLM이 텍스트의 난이도를 스스로 판단하고 자동으로 모델을 변형만 시켜주면 너무 좋겠지만...그건 안되는 것 같고..이걸 어떻게 자연어로 맥락을 파악하고 모델에 맞게 자동으로 변형을 시킬 수 있을지 고민 중이다.