인도 노동자 데이터가 미 테크 기업으로 흘러 들어간다
ChatGPT가 글로 배웠다면, 로봇은 인간의 손을 배운다.
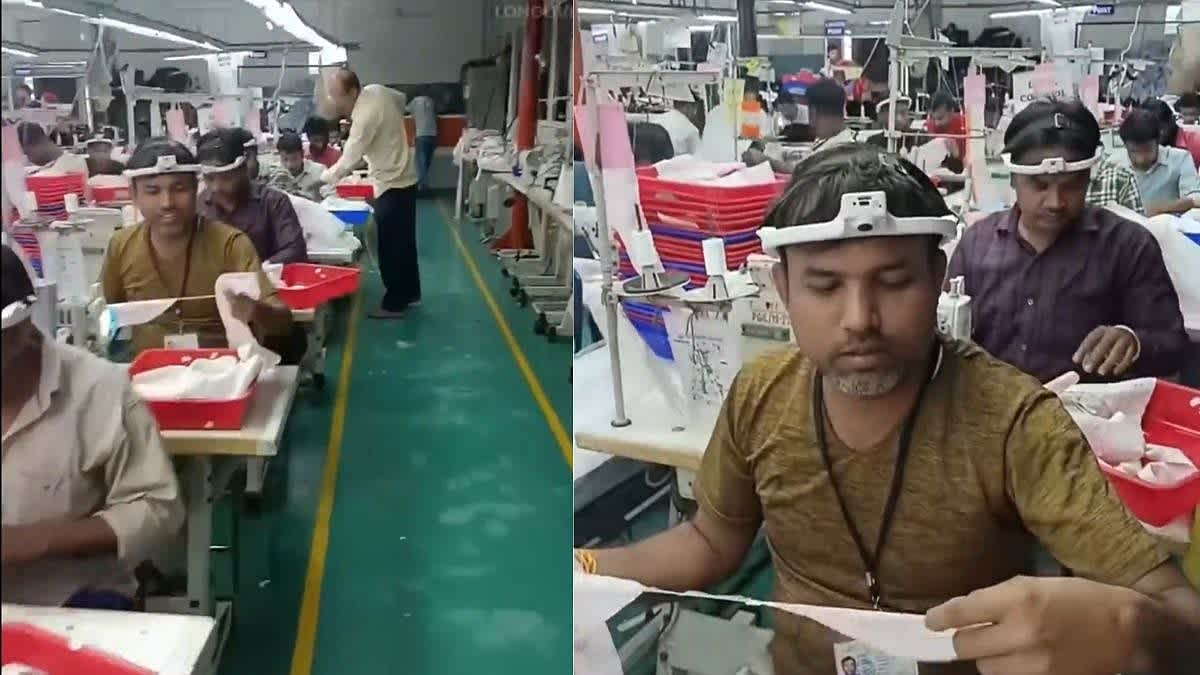
인도 벵갈루루의 한 의류 공장 내 노동자들은 이마에 고프로 카메라를 달고 일한다. 수건을 접고, 상자를 쌓고, 부품을 조립하는 손동작이 1인칭 시점으로 빠짐없이 기록된다. 이렇게 모인 영상은 미국 테크기업으로 흘러가 로봇 훈련에 쓰인다. 업계에선 이를 '핸드 팜(Hand Farm)'이라 부른다. 노동자들은 시간당 약 1달러를 받고 손동작을 제공하고 어쩌면 자신이 평생 해온 일을 자동화할 재료를 넘기고 있다.
왜 이런 일이 벌어질까?
ChatGPT 같은 생성형 AI의 학습 데이터는 인터넷에 있던 것들이다. 웹문서, 코드, 수 많은 커뮤니티 내 게시물과 댓글 등의 데이터로 배웠다. 그런데, 로봇은 다르다. 인터넷에는 "수건 접는 법"을 설명한 글과 영상은 넘쳐나지만 사람이 천을 집을 때 손가락에 어느 정도 힘을 줘야 하는지, 어떤 각도로 미끄러지는지는 없다. LLM이 인터넷의 글로 배웠다면 로봇은 인간의 손과 몸짓을 직접 보고 배워야 한다. 그런데 그런 데이터는 존재하지 않는다.
그래서, 데이터를 만들어내는 작업이 인도에서 벌어지고 있는 것이다. 노동자가 이마에 카메라를 달고 수건을 수백 번 접으면 그 영상은 다시 사람 손을 거쳐 가공된다. 손이 어느 방향으로 움직였는지, 수건 크기에 따라 어떻게 접어야 하는지 하나씩 라벨이 붙는다. LA타임스는 인도 카루르의 데이터 기업 Objectways가 이런 방식으로 미국 고객사에 수건 접기 영상을 보냈다고 보도했다. 이 회사는 하루 약 1,000시간의 데이터를 만들지만 시장 수요는 20만~30만 시간에 이른다고 한다. 턱없이 부족한 것이다.
여기서 중요한 건 데이터의 '깊이'가 바뀌었다는 점이다. 과거의 데이터는 문장, 클릭, 검색어, 사진이었다. 이제는 손목의 회전, 손가락의 압력, 물건을 집기 전 망설이는 찰나, 숙련자가 무의식적으로 따르는 작업 순서다. 장인이 말로 설명하기 어려운 기술, 주부가 매일 익힌 가사 동선, 물류 노동자가 터득한 균형감, 이른바 '암묵지'가 데이터가 된다. AI가 학습하기 위해 필요로 하는 데이터가 인간의 글에서 인간의 몸으로 옮겨가고 있다.
이 흐름은 인도만의 일이 아니다. 미국 뉴욕에서는 'shift'라는 스타트업이 무료 청소 서비스를 내세운다. 조건은 하나다. 청소원이 머리에 카메라를 쓰고 일하며 그 영상을 로봇 훈련에 쓰도록 허락하는 것이다. 설거지, 걸레질, 빨래 개기 같은 일상적 가사노동이 로봇 학습 데이터로 바뀐다. 얼굴과 개인정보는 흐림 처리하지만 결국 이용자는 집이라는 가장 사적인 공간을 데이터 수집 장소로 내주는 셈이다.
이 사업 모델이 확산될 가능성은 크다. 로봇 기업의 난제는 더 이상 "로봇이 걷느냐"가 아니다. 진짜 어려운 건 수건을 접고 전선을 피해 청소하고 삐뚤어진 상자를 다시 쌓고 예외 상황을 스스로 처리하는 일이다. 그래서 로봇 회사는 깨끗한 실험실 데이터보다 현실 속 집, 어수선한 창고, 사람이 실수하고 다시 고치는 과정이 담긴 '현실의 데이터'를 원한다.
이 지점에서 인도 노동자의 손동작은 미국 테크기업의 교과서가 된다. 과거 글로벌 제조업이 저임금을 찾아 공장을 중국, 베트남, 인도로 옮겼듯 이제 AI 산업은 저렴한 신체 데이터를 찾아 개발도상국의 공장과 가정으로 들어간다. 차이가 있다면 이번엔 물건이 아니라 노동자의 '움직임'이 수출된다는 점이다. 산업화 시대의 원자재 수출과 닮았지만 이번 원자재는 석유나 철광석이 아니라 인간의 동작과 공장과 일상 곳곳의 공간과 사물들에 대한 데이터이다.
이때 가치 배분의 문제가 생긴다. 노동자는 시간당 몇 달러를 받지만 그 데이터로 학습한 로봇 모델은 수십억 달러짜리 기업 자산이 된다. 더 민감한 건 개인정보를 넘어선다는 점이다. 청소 영상에는 얼굴을 흐려도 거실 구조, 아이 장난감, 약봉지, 냉장고 속 식재료, 생활 수준이 담긴다. 기존 개인정보보호법은 "내가 누구인가"를 다루는 데 익숙하지만 로봇 학습 데이터는 "내가 어떻게 일하고 사는가"를 포착한다. 내가 20년간 재봉틀 앞에서 익힌 손놀림은 과연 누구의 것인가? 회사의 것인가, 나의 것인가, 그 데이터를 산 로봇 회사의 것인가가 우리에게 던져진 질문이다.
기업들은 숙련자의 업무를 표준화하고 자동화를 준비하기 위해 스마트글래스와 작업 카메라로 현장을 기록하려 할 것이다. 하지만 무심코 수집한 영상은 곧 노동감시 논란이 된다. 직원의 시선, 휴식 시간, 실수, 작업 속도까지 기록되면 생산성 도구와 감시 도구의 경계가 무너진다. 개인도 마찬가지다. 스마트글래스가 보급되면 회의, 요리, 육아, 운동이 자연스럽게 촬영되고 그 데이터는 로봇을 더 능숙하게 만드는 재료가 된다. 오늘의 스마트글래스는 편의 장치처럼 보이지만 내일의 관점에선 현실 세계를 채굴하는 기록장치다.
AI의 다음 전장은 누가 더 많은 현실 데이터를 더 싸고 안전하게 확보하느냐에 대한 것이다. 인터넷 데이터는 이미 학습에 충분히 다 사용했고 이제 저작권 분쟁의 벽에 부딪혔다. 인도 노동자의 이마에 달린 카메라와 뉴욕 청소원의 카메라 모자는 그 변화의 상징이다. AI가 바카라상 위 문장을 읽던 시대에서 인간의 몸과 공간을 관찰하는 시대로 넘어가고 있다.
결국 핵심은 이 데이터의 가치가 누구에게 돌아가느냐다. 인간의 손동작이 로봇에게 인간의 노동을 가르친다면 그 손동작을 제공한 사람은 단순 임시 노동자가 아니라 AI 공급망의 원천 기여자다. 데이터 경제가 클릭과 검색어의 시대를 지나 몸짓과 숙련의 시대로 들어가면서 우리에게 필요한 것은 더 많은 카메라가 아니라 더 정교한 권리 계약과 더 투명한 보상 구조다. 로봇이 인간의 일을 배우는 시대에는 인간의 일도 새롭게 평가받아야 한다. 인도 노동자의 손에서 시작된 이 질문은 결국 우리 모두의 일터와 거실, 스마트글래스 너머의 일상에서 스스로에게 던져야 할 질문이다.
10월14일 출간됩니다. 2027년 주목해야 할 AI 트렌드 그리고 우리의 대처
https://www.yes24.com/Product/Goods/197780287