세상은 AI 전쟁 중... 99.99%
신경망 아키텍처, 인공지능의 설계도
이 글은 다른 곳에 쓰며 수정하던 글을 비공개, 공개로도 바꾸다 7년이 흘러 인공지능을 통해 제대로 검증받는 과정을 공개하는 글입니다. 검증 및 수정본 발행은 Claude Opus5로 하였습니다.
과정의 투명성
이 단원을 시작하며
건물을 짓기 전에 우리는 가장 먼저 설계도를 그립니다. 아파트, 체육관, 도서관은 모두 '철근과 콘크리트'라는 같은 재료로 지어지지만 완성된 모습과 용도는 완전히 다르죠. 재료가 아니라 재료의 '배치'가 건물의 성격을 결정하기 때문입니다. 인공지능도 똑같습니다. 오늘날 거의 모든 인공지능은 '인공 뉴런'이라는 똑같은 기본 블록으로 만들어집니다. 그런데 어떤 녀석은 사진 속 강아지를 찾아내고, 어떤 녀석은 시를 쓰고, 또 어떤 녀석은 과학자의 단백질 연구를 돕습니다. 이 차이는 어디서 올까요? 바로 뉴런을 어떻게 배치했는가에서 옵니다. 이 배치의 설계도를 우리는 아키텍처(architecture)라고 부릅니다.
이 단원에서는 기술을 외우는 대신 이야기를 따라갈 것입니다. 새로운 아키텍처는 하늘에서 뚝 떨어진 것이 아니라, 앞선 아키텍처가 풀지 못한 치명적인 한계를 극복하기 위해 태어났기 때문입니다. 자, 이제 위대한 설계도들의 진화 과정을 함께 살펴볼까요?
1장 · 왜 '종류'가 필요한가
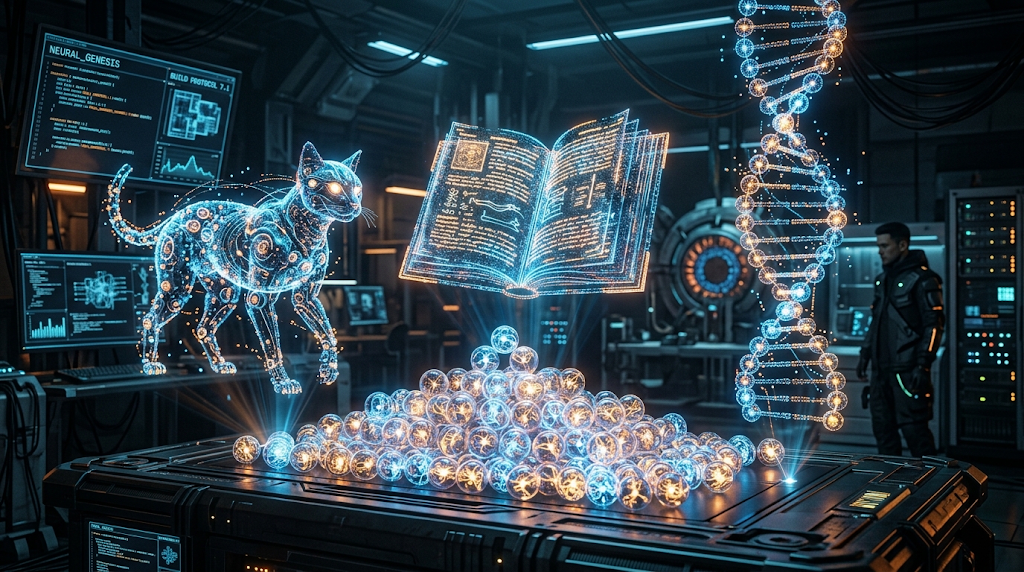 똑같은 재료(뉴런)가 어떻게 배치되느냐에 따라 고양이, 바카라, 생명공학용 모델로 탄생하는 모습
1.1 공통의 재료 - 인공 뉴런
위 그림을 보세요. 중앙에 쌓여 있는 파란 구슬들이 보이시나요? 저것이 모든 신경망의 기본 단위인 '인공 뉴런'입니다. 뉴런의 작동 원리는 놀랄 만큼 단순합니다. 입력된 숫자들에 가중치(중요도)를 곱해 더한 뒤, 활성화 함수라는 필터를 한 번 거쳐 숫자 하나를 내보냅니다.
인공지능을 '학습'시킨다는 것은, 데이터를 계속 보여주면서 이 가중치 숫자들을 정답에 가깝게 조금씩 조절해 나가는 과정일 뿐입니다.
1.2 아키텍처 - 편견(가정)을 심어주는 일
하지만 뉴런 자체는 이미 1950년대에 발명되었습니다. 그런데 왜 2010년대가 되어서야 AI가 세상을 놀라게 했을까요? 그 비밀이 바로 그림 속 세 갈래의 '배치(아키텍처)'에 있습니다.
아키텍처를 설계한다는 것은, 사실 컴퓨터에게 "세상은 대략 이렇게 생겼어"라는 가정을 구조 자체에 미리 심어주는 일입니다. 이것을
귀납 편향(inductive bias)
이라고 부릅니다. 이 단원에서 가장 중요한 단어입니다! "고양이 귀는 사진 어디에 있든 똑같은 고양이 귀야"라고 미리 힌트를 주면 이미지 특화 AI가 됩니다. "단어는 순서가 중요해"라고 힌트를 주면 언어 특화 AI가 됩니다.
여기에 핵심 딜레마가 있습니다. 힌트(편향)를 많이 주면 적은 데이터로도 빨리 배우지만, 데이터가 엄청나게 많아지면 오히려 그 힌트가 고정관념(족쇄)이 되어 발전의 한계를 맞습니다. 반대로 힌트 없이 백지상태로 시작하면 처음엔 헤매지만, 인터넷 전체의 데이터를 다 들이부으면 스스로 우주의 법칙을 깨달으며 압도적인 성능을 냅니다.
이 딜레마가 앞으로 펼쳐질 아키텍처 발전의 운명을 가르게 됩니다.
결론
큰 틀의 서사(재료 → 배치 → 귀납 편향 → 데이터 규모에 따른 역전)는 학계 주류 이해와 일치합니다. 다만 사실 오류 2건, 논리 인과 오류 1건이 있고, 그중 하나는 바카라 전체 논리의 출발점에 있어서 반드시 고쳐야 합니다.
1. 반드시 고쳐야 할 것
① "왜 2010년대가 되어서야 AI가 놀라게 했을까? → 비밀은 배치(아키텍처)에 있다" — 인과가 틀렸습니다.
CNN은 이미 1989년(LeCun), 1998년(LeNet-5)에 완성되어 있었습니다. 아키텍처는 2010년대에 새로 등장한 게 아닙니다. 2012년 AlexNet이 터진 실제 원인은 세 가지입니다.
데이터: ImageNet(2009), 1400만 장 라벨 데이터셋의 등장
연산: GPU를 이용한 병렬 학습
학습 기법: ReLU, Dropout, 더 나은 초기화
즉 "배치가 달랐다"가 아니라 "같은 배치에 데이터와 연산이 붙었다"가 정답입니다. 그리고 이건 뒤에 나올 딜레마(편향 vs 데이터 규모)와도 논리가 이어집니다. 지금 문장대로 두면 3장쯤에서 저자가 스스로 반박하게 됩니다.
수정안: "뉴런도, 심지어 이미지용 배치도 이미 1990년대에 존재했습니다. 빠진 것은 설계도가 아니라 데이터와 연산 능력이었죠. 2010년대에 그 둘이 채워지자, 비로소 '어떤 배치를 고를 것인가'가 승부처가 되었습니다."
② "뉴런 자체는 이미 1950년대에 발명되었습니다" — 10년 이릅니다.
1943년 McCulloch & Pitts: 인공 뉴런의 수학적 모델 제안
1957~58년 Rosenblatt: 퍼셉트론, 학습 가능한 최초의 뉴런
정확히는 "1940년대에 제안되고 1950년대 말에 스스로 배우기 시작했습니다"입니다.
③ "힌트 없이 백지상태로 시작하면" — 개념적으로 틀린 표현입니다.
귀납 편향이 0인 아키텍처는 존재하지 않습니다(No Free Lunch). 트랜스포머도 고유한 편향을 갖습니다 — 모든 토큰 쌍의 상호작용을 가정하고, 순서 자체는 구조가 아니라 위치 인코딩으로 주입하며, 집합에 대해 순열 등변적입니다. 정확한 표현은 "백지"가 아니라 "약한 편향"입니다. 이 구분을 도입부에서 잡아두지 않으면 ViT를 설명할 때 "편향이 없다는데 왜 위치 인코딩이 필요하죠?"라는 질문에 답할 수 없습니다.
지금 바로 작가의 멤버십 구독자가 되어
멤버십 특별 연재 콘텐츠를 모두 만나 보세요.
前 SAMSUNG KNOX 메인개발자, 前 ETRI ARM firmware 강사 6年, 前(주)쏘닥 CTO, 前(주)이엑스 CTO. 스타트업 CTO... 기술을 쉽게...
오직 멤버십 구독자만 볼 수 있는,
이 작가의 특별 연재 콘텐츠
- 최근 30일간 22개의 멤버십 콘텐츠 발행
- 총 449개의 혜택 콘텐츠