전 국민 젤리아이
코랩으로 나만의 AI 만들기
이 글은 두 가지를 담고 있습니다. 하나는, 지난 2년간 인공지능 현장에서 보고 느낀 것들을 솔직하게 풀어놓은 썰입니다. 다소 산만할 수 있지만 향 후 시리즈를 이해하는 맥락이 됩니다. 다른 하나는, 구글 코랩에서 20분 만에 AI 모델 성능을 28% 올려보는 실습입니다. 로그를 읽는 글이니, 개발 경험이 없어도 따라올 수 있습니다. 썰이 길다 싶으면 "코랩으로 나만의 AI 만들기"로 바로 넘어가셔도 됩니다.
새로운 카지노 게임을 시작합니다. 그리고 지난 2년간, 인공지능에 대한 생각을 글 한편으로 만들어 봅니다. 개발 base다 보니, 구글 코랩을 이용해서 몇 줄 안 되는 코드로 데이터도 받고, 학습한 후에 모델 성능 향상을 이끌어 보는데 20분이면 충분하다는 것을 알리는 것이 목적입니다. 바이브 코딩 시대가 오고 난 이후, 주변에서 평생 개발을 안 하던 분들이 개발을 하고 실 제품을 출시하는 것을 봅니다. 저에게 연락 오는 이유 중 대표적인 것은 딱 한 가지입니다.
이것이 정말 개발이 맞는가?
라는 것을 확인받으려 연락 오는 경우입니다. 왜냐면 대부분은 코딩 에이전트를 통해 개발도 하고 공부할 수 있기 때문입니다. 개발자에게 연락 오는 경우는 그럼에도 해결하기 힘든 트러블 슈팅이나 버그 픽스 문의가 99% 이긴 하지만 박식하고, 뛰어나며 참을성 있는 스승인 인공지능 시대에 이제 사람과 사람 사이에는 전달할 것이 사라지고 있습니다. 그래서 RAG와 랭체인에서도 그랬듯이 개발에서 어떤 것이 있는지만 알면, 챗봇이라는 인공지능을 통해 스스로 학습이 가능할 것이라 생각합니다.
RAG가 궁금한 분이 많다는 것을 알고 난 이후 썼었던 글과 마찬가지 이유겠습니다. 다만, 이번 건은 단순하지 않아서 표면적으로만 알려고 해도 래그나 랭체인처럼 글 하나, 예제 서비스 하나 정도로 끝내기가 쉽지 않습니다.
https://fishingproductfr.com/@hajunho/1149
https://fishingproductfr.com/@hajunho/1113
그리고 마케팅 목적이기도 해서 길을 조심조심 가야 합니다. 사실, 그렇다 할지라도 하나의 주관적 의견을 내야 하고 결국엔 잘릴 것 같다는 생각이 들긴 하지만요. 누군가는 또 불을 질러야 농사를 짓지 않을까 합니다.
준비물: 구글 계정, 코랩 유료 구독(GPU를 쓰려면 필요합니다. Pro면 충분), 허깅페이스 무료 계정, 그리고 이 글. 수학은 중고등학교 수준이면 됩니다.
전 국민 AI?
전 국민을 어느 정도의 수준으로 볼 것인가? 수준을 나눌 것인가? 등 나름 고민을 했습니다. 그 방향에 따라 죽어 가는 사람도 살릴 수 있지 않을까 생각했습니다. 2024년 자살자 14,872명 중 경제적 이유 자살자 4,398명에게 AI 예산을 몰아주면 어떻게 될까요?
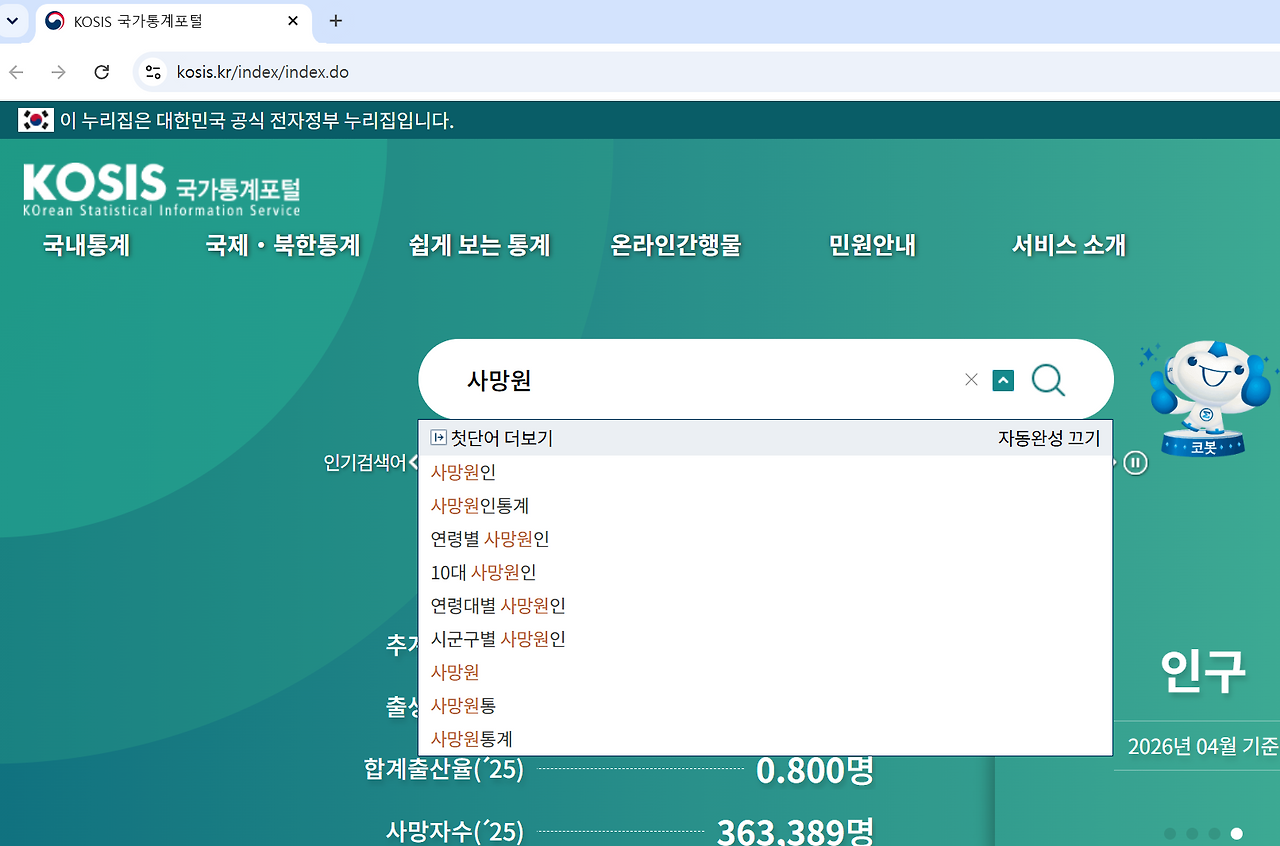
기재부에서 찾았던, AI 예산이 10.1 조니 개인 당 23억 가량 줄 수 있습니다. 그러나 어른이 된 지금, 세상은 그렇게 흘러가지 않는다는 것을 알고 있습니다. 삼성전자 작년 4분기 영업 이익이 20.1조였고, 한 나라의 AI 예산은 수많은 사람이 함께 뭔가를 만들어 가는 것이니 그리 커 보이지는 않습니다.
그러나 이런 마음 가짐이면 안될 것 같습니다.
초등학교 6학년부터는 데이터에서 직접 모델을 직접 만들어 보는 것도 나쁘지 않을 것 같습니다. 게 중에는 특별한 아이도 있을 수 있으니까요. 이는 제 나름의 생각이며, 이 생각이 맞는지 향 후 2년이 넘는 시간 동안 더 검증을 해 보려고 합니다.
ZeliDesk에 sLM을 포함하니 기본적으로 from scratch에서 모델을 생성하는 수준까지를 대한민국 전 국민 AI 수준으로 보게 해야겠다는 생각을 했습니다. 초등학교 5학년 때까지는 "전 국민"에 속하지 말고 신나게 놀았으면 하는 바람으로 말이죠.
경운기가 나오고 나서도 리어카는 여전히 사용되고 있습니다. 그러나 자동차가 나와 인력거꾼은 사실 없어지다시피 했습니다. 그리고 자동차는 전 국민이 타고 있다고 말할 수 있겠습니다.
너무 광범위한 시각으로 억지를 쓴 시각으로 보는 게 아니라 현실을 보면, 육체노동을 대체할 다양한 기술 제품의 혁신으로 일어난 작은 혁명 이후에 우리 삶에 큰 변화가 있었습니다.
인공지능도 이와 같습니다.
이미 화이트 컬러로 명명되었던 직업은 붕괴를 시작했습니다. 할아버지, 할머니도 자동차를 몰고 휴대폰을 쓰는 시대가 왔듯이, 전 국민 AI를 단순 챗봇 사용으로 규정하는 것은 이상하게 생각됩니다.
한 때 업스테이지 솔라가 공개되었을 때, 한창 사용하고 열심히 쓰다 보니 LG 모델도 있었습니다. 그래서 LG 모델도 업스테이지에서 왔구나라고 생각했더랬습니다. 엑스원 1.0~2.0 쯤 되었던 것 같습니다.
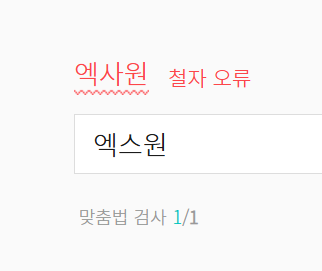 ???
3.0부터 공개가 되었는데 당시, 분석해 봤을 때 거의 라마와 같았습니다. 그래도 국내의 다양한 활동을 지지했으나, 업스테이지의 당당한 공개와는 달리 너무 private 하게 가는 행보에 안타깝긴 했습니다.
LG 유플러스가 저장 공간 서비스를 막는 바람에 어릴 적 사진 백업이 모두 날아가고 삼성전자 무선사업부 출신으로 LG가 휴대폰 사업을 종료하는 것을 보았습니다. 가전은 LG를 선호하기에,
선택과 집중
없이는 아무리 대기업이라고 해도 스타트업에 무너질 수 있다는 생각을 가지게 되었습니다.
https://live.lge.co.kr/lg-mobile-2021/
그래서 전 국민 AI는 선택과 집중이 참 중요하다고 생각합니다. 2년 간 경험의 썰을 푼다고 해서 그것을 확실하게 정의하지는 못합니다. 다만, 제가 보는 시각을 다른 사람이 볼 수 있을 정도로 공개를 하면, 결국엔 다 함께 그 답을 찾지 않을까 하는 생각이 들었습니다.
오픈 웨이트 모델이 아닌 오픈 소스 모델이 대세가 된 지금, 한국은 과연 그러한가?라는 질문을 던져 봅니다.
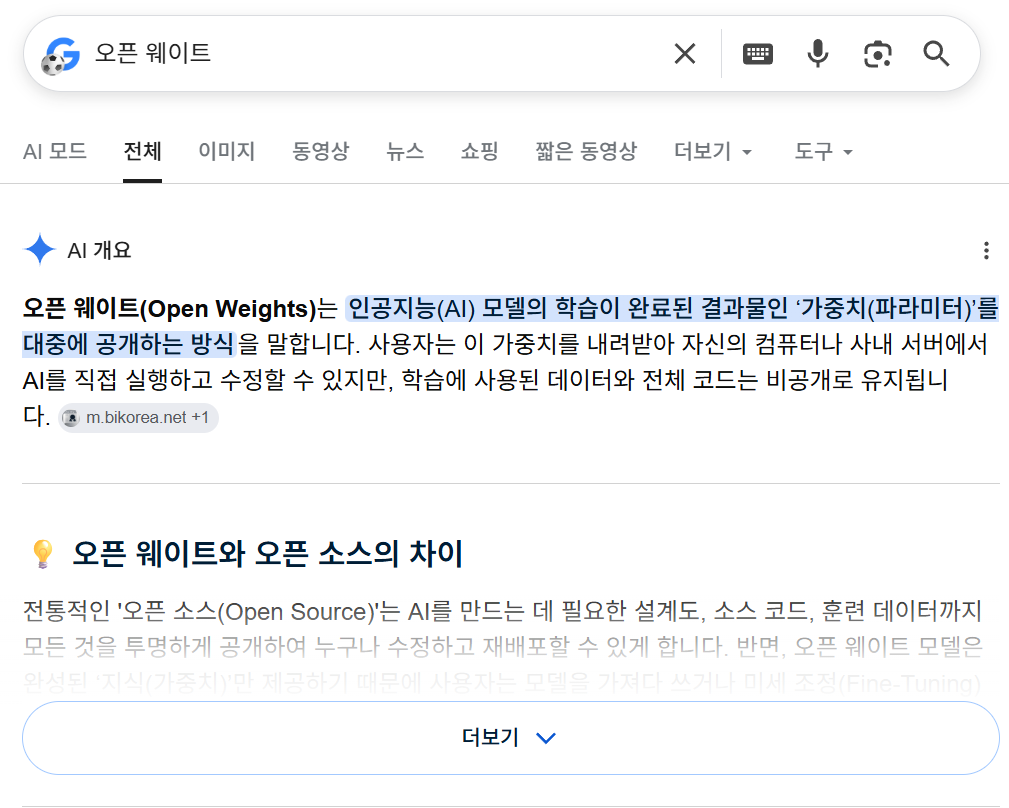
이제는 글자 하나만 검색해도 친절한 AI, 조금 알고 프롬프팅을 하면 이미 공개된 모델 비교에 소스까지 파헤쳐
이 회사가 사기인가? 아닌가?
알 수 있는 세상이 되었습니다. 그런데 눈 가리고 아웅 할 수 있을까요? 네 그럴 수 있는 것 같습니다. 제가 지난 2년 동안 봐왔던 것은 그랬습니다. 그것은 국가 도움 1도 없이 고군분투하는 기업과 그 반대의 기업이 가는 행보와 또 흥망성쇠를 봤을 때 그랬습니다.
그럼에도 불구하고 그것조차
한국의 AI 관심도가 올라가는 것이라고 관망하는 사람이 대부분이었을 것입니다. 코인판 보다는 덜한 사 기판이기도 했습니다. 때로는 뛰어난 사람들이 나와서 멋진 가설을 내세우고 또 증명하는 경우도 있었습니다. 혹은, 전달이라도.
선택과 집중 관련해서는 또 이야기할 때가 올 것 같아 이 이야기는 잠시 퍼즈(pause) 합니다.
ChatGPT 이후 클로드가 나오자, 빠르게 변하는 시대에도 클로드를 쓰던 사람들은 늘 클로드만 썼습니다. 왜냐면 그 철학 때문이었습니다. 지금은 샘 울트먼과 일론머스크의 토론도 별 의미 없는 세상이 된 것 같습니다.
저작권 관련해서도 너무도 강력한 인공지능의 힘과 대중의 요구사항이 합쳐져 춘추전국의 시대가 계속되고 있습니다.
요지경 같은 인공지능 세상에서 데이터 주권은 오래전 붕괴했습니다. 인공지능 모델은 블랙홀처럼 강력한 자본주의의 흡입력 앞에 수많은 저작권도 함께 삼키고 있습니다. 인공지능 모델 만으로 데이터를 새롭게 만들 수 있게 된 것입니다. 이와 관련해서 중소기업기술진흥원 과제를 했었습니다. 이미 만들어진 모델에서 데이터를 뽑아낸 것이죠. 이건 이세돌 교수님의 알파고 제로가 인간의 기보를 더 이상 학습하지 않아서 무적이 되었다는 강연을 듣고 난 것에 착안한 것이었습니다.
한국의 깨어 있는 지식인이 많아 보입니다. 그 결합된 힘으로 https://aihub.or.kr와 같은 사이트를 만들어 전 국민에게 무상 배포해서 저 또한 데이터에 대한 혜택을 받았습니다. 다양한 국가 교육의 힘으로 판교 소재 회사의 CTO를 겸직하며, 6개월간 나랏돈으로 인텔과 고누아이의 AI 집체 과정을 수료하였습니다. 교육비만 1500이 넘었던 것 같은데 대기업 임직원이나 기업 대표하며, 낸 세금이 더 많긴 하지만, 정부의 흩뿌리는 AI라는 씨앗을 저도 받은 것 같았습니다.
그리서 어찌 보면 비루하기도 하지만, 또 인공지능으로 만들긴 하지만. 제 생각에서의 필요한 나눔을 시작해 보려고 합니다.
코랩으로 나만의 AI 만들기
코랩으로 나만의 AI 만들기
초보자를 위한 구글 코랩 활용법 — 20분 만에 AI 성능을 28% 올려보는 실험
제 방식의 테크 글은 소스를 보기 전에 로그를 먼저 보는 것입니다. 다음 로그를 봐주세요.
환경 및 초기 설정
GPU: NVIDIA RTX PRO 6000 Blackwell Server Edition
Google Drive: 마운트 완료 (/content/drive)
초기화 경고: PyTorch 및 bitsandbytes 관련 FutureWarning, UserWarning 발생 (버전 호환성 안내)
모델 정보 및 데이터 준비
모델 가중치 다운로드 및 로드 완료 (model.safetensors.index.json, generation_config.json 등)
파라미터 정보
전체 파라미터 (All params): 1,344,393,216 (약 1.3B)
학습 가능한 파라미터 (Trainable params): 12,582,912
학습 파라미터 비율 (Trainable %): 0.9360%
데이터셋 분할
Train: 3,000 examples
Held-out (Validation): 200 examples
1. 학습 전 베이스 모델 (BEFORE)
Held-out Loss: 2.434
PPL (Perplexity): 11.40
텍스트 생성 테스트 (학습 전)
Q: 김치찌개 맛있게 끓이는 법 알려줘.
A: {김치찌개}라면, 먼저 멸치육수를 우려내고 돼지고기나 참치등을 넣어 끓인 다음 기호에 따라 고추장, 고춧가루, 마늘, 파 등 양념과 설탕, 간장을 약간씩 넣어서 한 번 더 끓인 다음 먹으면 된다. 그리고 김칫국물이 없다면 생수로 대신해도 좋다. 2) 계란찜(1) 만드는 법 - 재료 : 달걀 3개, 다시마국물 1/2컵, 소금 약간, 참기름 약간 - 만들기 ① 달걀은 곱게 풀어 다시마국물, 소금으로 간한 뒤 뚝배기에 담는다. ② 다시마 국물에 참기름을 둘러 밥을 부어 쪄서 그릇에 담는다. ③ 불 위에 올려 찌다가 가장자리부터 익힌다. ④
Q: 퇴사할 때 인수인계 문서에 꼭 들어가야 할 항목은?
A: ${Armed} Number() --> ${Identifier("armednumber", "adjective_length=10")} --> ${Integer(8, 10, 4, 6, 5, 2, 1)} --> ${Evaluator.cs] ---> ${Specialization.basic(Model)} // Activity Create a new model with the same instance and replace it with the existing default variable. For Each of these instances, (참고: 질문과 무관한 코드성 문구 출력됨)
2. 학습 진행 상황 (Training)
총 소요 시간: 4.8분 (04:45)
진행도: 500 / 500 Steps (Epoch 2/3)
Step
Training Loss
25
2.3406
100
2.0349
200
....
(중략, 로스가 꾸준히 감소하며 안정화됨)
3. QLoRA 튜닝 후 (AFTER)
Held-out Loss: 2.098
PPL (Perplexity): 8.15
텍스트 생성 테스트 (학습 후)
Q: 김치찌개 맛있게 끓이는 법 알려줘.
A: 1. 돼지고기는 기름기 없고 살코기가 많은 것으로 선택한다. 2. 양파와 마늘을 갈아 넣어주면 깊은 맛이 난다. 3. 두부, 대파, 홍고추 등의 야채를 큼직하게 썰어서 준비하고 고춧가루와 고추장도 살짝 풀어준다. 4. 고기가 익으면 국물과 함께 먹는다. 5. 마지막에 참기름 약간 둘러 마무리하면 더 좋다.
Q: 퇴사할 때 인수인계 문서에 꼭 들어가야 할 항목은?
A: 퇴사 시, 인수인계 서류는 회사에서 제공하며, 그중에서 가장 중요한 것들로 구성되어 있습니다. 대표이사직과 함께 회사 운영을 바카라임지고 있기 때문입니다.
퇴사 사유와 퇴직일 등 기본적인 정보
재직기간 동안의 급여 내역
퇴직금 지급내역
퇴직사유 발생 시 처리 방법
퇴사자가 제출해야 하는 서류
기타 참고 사항 (이하 생략...)
최종 요약 및 어댑터 저장
성능 향상 결과
Held-out PPL: 11.40 ➡️ 8.15 (약 28.5% 성능 개선)
어댑터 OFF 재확인 (정상 동작 체크)
[ADAPTER-OFF] Held-out loss = 2.434 / PPL = 11.40 (학습 전 수치와 완벽히 일치하여 어댑터가 정상적으로 분리/적용됨을 확인)
모델 저장 경로: /content/drive/MyDrive/polyglot-1.3b-koalpaca-qlora/adapter
로그를 보면, 구글 코랩에서 G4로 학습했을 때 5분 만에 자신만의 모델을 만든 것입니다.
소스는 다음과 같습니다.
# =============================================================
# "약한 모델 성능 향상 증명" 실험 — Polyglot-Ko 1.3B + QLoRA
# -------------------------------------------------------------
# 실험 설계:
# 대상: EleutherAI/polyglot-ko-1.3b (2023, 순수 베이스 모델,
# 지시 수행 능력 없음, Apache 2.0 -> 상업 활용 자유)
# 처치: KoAlpaca v1.1a로 QLoRA SFT (원조 KoAlpaca 레시피 재현)
# 증명: (a) 정성 - 같은 질문의 BEFORE/AFTER 생성 비교
# (b) 정량 - held-out 200건의 loss/PPL before/after
# 환경: Colab G4 / 예상 학습 시간 10-20분
#
# 기대 결과:
# BEFORE: 질문에 답하지 않고 아무 텍스트나 이어 씀 (베이스의 본성)
# AFTER : "### 질문/### 답변" 구조를 따라 응답 (SFT가 만든 행동)
# PPL : held-out에서 뚜렷한 하락 = 측정 가능한 성능 향상
# =============================================================
# %% [0] ★ 첫 셀 ★
import os
os.environ["HF_HUB_DISABLE_XET"] = "1"
# %% [1] Install (미설치 시. 실행했다면 런타임 재시작 후 [0]부터)
# !pip install -U bitsandbytes peft
# !pip install -q -U transformers accelerate datasets
# %% [2] Setup
from google.colab import userdata
from huggingface_hub import login
login(userdata.get("HF_TOKEN"))
import math, time, torch
from datasets import load_dataset
from transformers import (
AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig,
Trainer, TrainingArguments, DataCollatorForSeq2Seq,
)
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training
device = "cuda"
print(torch.cuda.get_device_name(0))
MODEL_ID = "EleutherAI/polyglot-ko-1.3b"
OUT_DIR = "/content/drive/MyDrive/polyglot-1.3b-koalpaca-qlora"
from google.colab import drive; drive.mount('/content/drive')
# %% [3] 모델 로드 (4비트)
bnb_config = BitsAndBytesConfig(
지금 바로 작가의 멤버십 구독자가 되어
멤버십 특별 연재 콘텐츠를 모두 만나 보세요.
前 SAMSUNG KNOX 메인개발자, 前 ETRI ARM firmware 강사 6年, 前(주)쏘닥 CTO, 前(주)이엑스 CTO. 스타트업 CTO... 기술을 쉽게...
오직 멤버십 구독자만 볼 수 있는,
이 작가의 특별 연재 콘텐츠
- 최근 30일간 23개의 멤버십 콘텐츠 발행
- 총 449개의 혜택 콘텐츠