AI 시대 최소한의 미적분 상식 14
해커는 '미분'으로 AI를 어떻게 속일까?
정지 표지판에 작은 스티커 몇 개를 붙였더니, 한 연구팀이 만든 표지판 인식 AI가 이 표지판을 "속도 제한 45 마일"로 읽었습니다. 사람에게는 여전히 "멈추라"는 표지판이지만, AI에게는 전혀 다른 표지판이었던 거죠. 스티커는 아무렇게나 붙인 게 아닙니다. 연구자들은 "어느 위치에 붙여야 AI가 가장 크게 헷갈릴까?"를 수학으로 계산해서 붙였습니다. (관련 논문 : https://arxiv.org/abs/1712.08062)
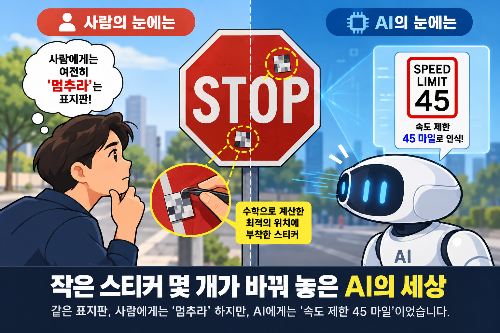
물론 실제 도로의 자율주행차가 곧바로 이렇게 속는 것은 아닙니다. 차량에는 여러 센서와 안전장치가 함께 작동하니까요. 하지만 연구실에서 실제로 증명된 AI의 약점이라는 점은 분명합니다.
이 착시의 정체는 AI를 똑똑하게 만든 바로 그 수학, 미분(기울기)입니다. 오늘은 '적대적 공격(Adversarial Attack)'과 미분의 두 얼굴에 대한 이야기입니다.
1. 귀여운 판다가 긴팔원숭이로 둔갑하다
2014년, 딥러닝 연구자 이안 굿펠로우 등은 유명한 실험을 발표했습니다.
(관련 논문 : https://arxiv.org/abs/1406.2661)
AI에게 판다 사진을 보여주면 "약 58% 확률로 판다"라고 답합니다. 그런데 이 사진 위에 사람 눈에는 거의 보이지 않는 옅은 '잡음(노이즈)'을 덧씌우자, AI는 같은 사진을 보고 이렇게 답했습니다.
“99.3%의 확신으로 이 동물은 긴팔원숭이입니다!”
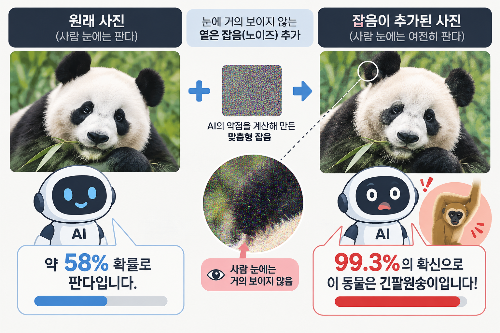
사람 눈에는 여전히 귀여운 판다인데, AI는 조작 전보다 오히려 더 강한 확신으로 엉뚱한 오답을 외친 겁니다. 아무 잡음이나 섞은 게 아니기 때문입니다. 이 잡음은 AI의 약점을 계산해서 만든 맞춤형 잡음이었습니다.
2. 해거의 역발상 : 산을 거꾸로 오르도록 만들자.
우리는 "2. 안갯속을 내려오는 가장 현명한 방법"에서 AI는 마치 안개 낀 산에서 가장 낮은 골짜기(오차가 가장 작은 곳)를 찾아가는 방법으로 학습을 하고 있음을 알아보았습니다.(이를 '경사하강법'이라고 합니다.)
여기서 해커는 이런 질문을 합니다. "눈을 가리고 산을 내려오는 사람을 오히려 올라가게 만들려면 어떻게 해야 할까?"
답은 간단합니다. 나침반이 가리키는 방향을 거꾸로 뒤집으면 됩니다. 공격하는 쪽이 바로 이 생각을 했습니다. 다만 학습할 때와 공격할 때는 미분으로 고치는 대상이 다릅니다.
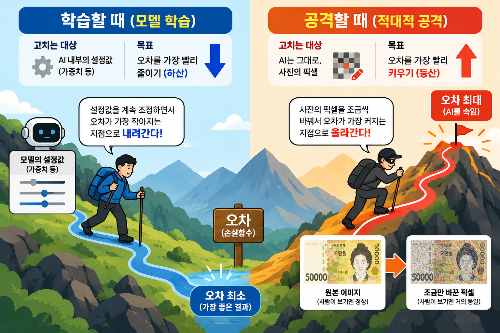
공격하는 쪽은 미분으로 이렇게 묻습니다. "이 판다 사진의 픽셀들을 어느 방향으로 아주 조금씩 바꾸면 AI가 가장 크게 틀릴까?"
여기에는 한 가지 조건이 있습니다. 사람이 알아채지 못하도록 픽셀을 아주 살짝만 바꾸는 것입니다. 이렇게 오차가 가장 빨리 커지는 방향으로 픽셀을 미세하게 밀어내는 대표적 기법이 FGSM(Fast Gradient Sign Method)입니다. 이름은 어렵지만 원리는 한 문장입니다. "미분 나침반을 거꾸로 쥐고, 픽셀을 낭떠러지 쪽으로 살짝 민다."
3. 왜 사람은 멀쩡하고 AI만 속을까?
사람은 사물의 전체 윤곽과 맥락을 봅니다. 그래서 픽셀 몇 개의 미세한 색 변화는 신경 쓰지 않습니다.
AI는 사진 한 장을 수만, 수십만 개의 픽셀 숫자로 받아 계산합니다. 여기서 핵심은 모든 픽셀이 동시에, AI를 가장 크게 흔드는 방향으로 조금씩 움직인다는 점입니다. 픽셀 하나의 변화는 먼지처럼 작아도, 수만 개가 같은 방향으로 쌓이면 AI의 계산 결과는 크게 뒤집힙니다. 사람에게는 먼지 수준의 변화가 AI에게는 "완전히 다른 그림"이 되는 이유입니다.
4. 현실에서는 얼마나 위험할까?
적대적 공격이 현실에 왜 위험한지를 살펴보겠습니다.
디지털 공격과 물리적 공격은 다릅니다. 사진 파일에 몰래 잡음을 얹는 공격은 사람 눈에 거의 보이지 않습니다. 반면 표지판 스티커나 특수 안경 같은 현실 세계의 공격은 눈에 띕니다. 다만 사람은 "누가 장난쳤나 보다" 하고 넘길 뿐, 그 의미를 오해하지는 않습니다
AI의 내부를 몰라도 속일 수 있습니다. 공격하는 쪽이 대상 AI의 구조를 몰라도, 비슷하게 만든 다른 AI로 만든 공격이 실제 시스템에도 통하는 경우가 있습니다. '구조를 숨기면 안전하다'라고 방심하기 어려운 이유입니다.
사진에만 국한되지 않습니다. 특수 무늬 안경으로 안면 인식 시스템을 속이는 연구가 있고, 사람 귀에는 들리지 않는 소리를 섞어 음성 비서가 엉뚱한 명령을 따르게 하는 연구도 있습니다. 의료 영상을 분석하는 AI를 대상으로 한 연구도 이루어지고 있습니다.
실제 사고로 이어진 증거는 아직 없습니다. 연구실 결과가 곧바로 상용 자율주행차의 사고로 이어진다는 증거는 아직 없습니다. 그래서 오히려 지금이 대비하기 좋은 때입니다.
6. 최근 은행 해킹, 적대적 공격일까?
최근 한국 금융권에서는 AI 에이전트를 활용한 것으로 추정되는 해킹이 잇따라 일어났습니다. 신한은행에서는 고객 2만 5천여 명의 정보가 유출됐고, KB국민은행과 하나은행에서도 수십~수백 명의 정보가 빠져나갔습니다. 이후 저축은행과 캐피탈사 등 2 금융권으로까지 번졌다고 보도됐습니다. 유출된 정보에는 이름, 전화번호, 주민등록번호, 연소득, 대출 한도 등이 포함됐습니다.
그렇다면 이것도 지금까지 설명한 '적대적 공격'일까요? 공격은 맞지만 "적대적 공격"은 아닐 가능성이 높습니다.
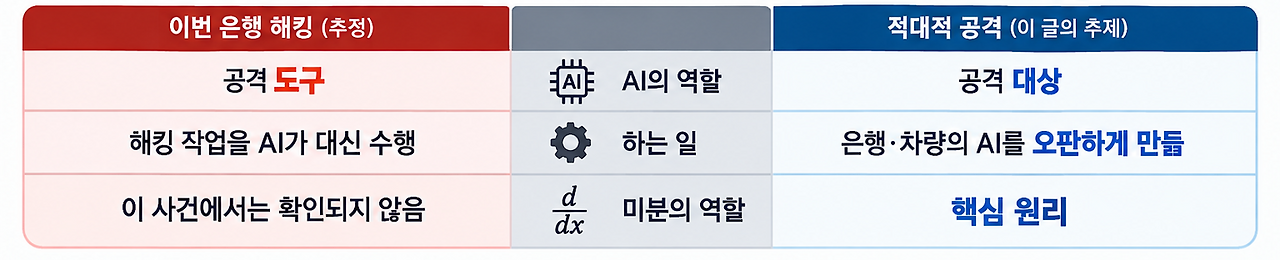
쉽게 말해, 판다 이야기가 “AI의 눈을 속이는” 이야기라면 이번 사건은 “AI를 손발로 부리는” 이야기입니다. AI 에이전트란 사람이 일일이 지시하지 않아도 스스로 여러 단계의 작업을 이어서 처리하는 AI를 말합니다. 해킹처럼 반복적이고 끈기가 필요한 작업을 대신 맡기면, 공격하는 쪽의 속도와 규모가 달라질 수 있다는 우려가 나옵니다.
그래도 두 이야기는 같은 교훈으로 이어집니다. AI는 수학과 계산으로 움직이는 강력한 도구이고, 누가 어떻게 쓰느냐에 따라 방어에도 공격에도 쓰입니다. 그리고 이제 AI는 공격의 도구이자 표적이 될 수 있습니다.
다만 아직 알려지지 않은 부분이 많습니다. AI가 실제로 어떤 역할을 했는지는 조사 결과를 지켜봐야 합니다. 다만, 이번 이야기에서는 "추정"이라는 보도 내용을 바탕으로 생각해 보았습니다.
7. 방어는 어디까지 왔을까?
보안 연구자들은 적대적 훈련(Adversarial Training)이라는 방어법을 씁니다. 속이려는 잡음이 섞인 이미지를 미리 AI에게 보여주며 "이것도 판다라고 대답해"라고 가르치는, 말하자면 예방주사입니다.
하지만 이것으로 문제가 끝나지는 않습니다. 새로운 공격이 나오면 새로운 방어가 나오고, 다시 더 정교한 공격이 나오는 식입니다. 완벽한 방어는 아직 없고, 지금도 활발히 연구되는 미해결 문제입니다.
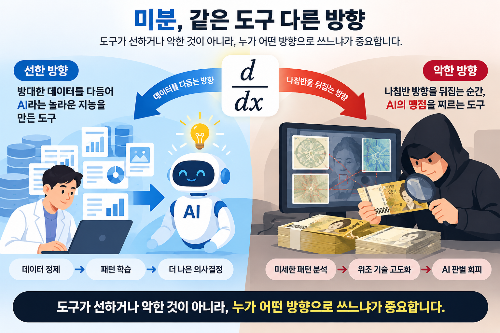
미분은 방대한 데이터를 다듬어 AI라는 놀라운 지능을 만든 도구입니다. 그리고 같은 미분이 나침반 방향을 뒤집는 순간, AI의 맹점을 찌르는 도구가 됩니다. 도구가 선하거나 악한 것이 아니라, 누가 어떤 방향으로 쓰느냐가 중요합니다.
AI가 자율주행, 보안, 의료 같은 일상 깊숙한 곳으로 들어올수록 “AI는 얼마나 똑똑한가”만큼이나 “AI는 어떻게 속을 수 있는가”를 아는 일이 중요해집니다. 그리고 우리가 당장 할 수 있는 일도 있습니다. AI의 판단을 100% 믿지 않는 습관입니다. 중요한 순간에는 사람이 한 번 더 확인하는 것이 가장 오래된, 그리고 가장 확실한 안전장치니까요.