AI 시대 최소한의 미적분 상식 12
진짜 보다 더 진짜 같은 가짜의 탄생: 위조 지폐범과 형사의 줄다리기
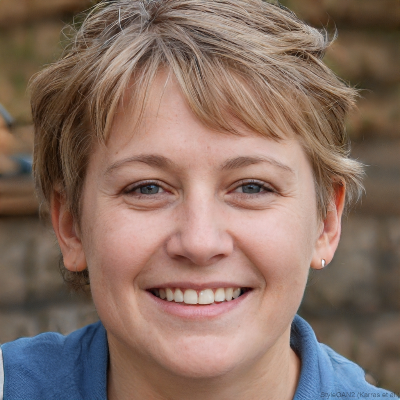 출처 : https://thispersondoesnotexist.com/
위 사진을 한번 봐주세요.
금방이라도 숨을 쉴 것처럼 생생한 눈동자, 뺨에 드리운 자연스러운 솜털, 빛을 받아 반짝이는 머리칼까지. 완벽한 한 사람의 얼굴입니다. 하지만 이 사진은 https://thispersondoesnotexist.com/에서 내려받은 사진입니다. 웹 사이트 제목이 재미있습니다. "이 사람은 세상에 단 한 번도 존재한 적이 없습니다."
이 사진은 컴퓨터 그래픽 아티스트가 오랜 시간 공들여 그린 것도 아닙니다. 인공지능(AI)이 텅 빈 도화지 위에 순식간에 창조해 낸 얼굴입니다. AI는 어떻게 사람 눈까지 속일 만큼 정교한 가짜를 만들어낼 수 있었을까요? 그 비밀은 하나의 AI가 혼자 열심히 공부한 결과가 아닙니다. 서로 미친 듯이 경쟁하는 두 개의 AI가 있었기에 가능했습니다. 바로 'GAN(생성적 적대 신경망)'입니다.
1. 위조지폐범과 형사, 끝나지 않는 대결
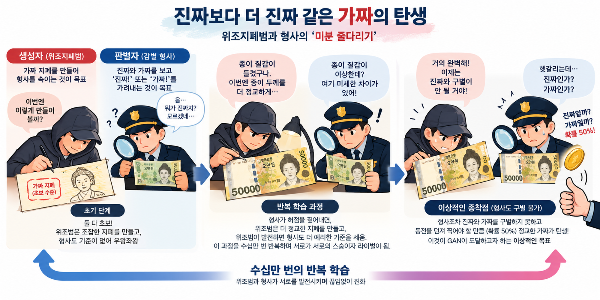
GAN을 만든 이안 굿펠로우는 이 기술을 설명하기 위해 지금까지도 널리 쓰이는 비유를 들었습니다. '위조지폐범'과 '위폐 감별 형사'의 대결입니다.
생성자(Generator, 위조지폐범): 가짜 지폐(가짜 이미지)를 찍어내, 형사를 속이는 것이 목표입니다.
판별자(Discriminator, 감별 형사): 진짜 지폐(실제 사진)와 위조지폐를 번갈아 보며 "진짜!" 혹은
"가짜!"를 가려내는 것이 목표입니다.
처음에는 생성자, 판별자 모두 초보입니다. 위조범은 크레파스로 낙서한 수준의 지폐를 내밀고, 형사도 뭐가 진짜인지 기준이 없어 우왕좌왕합니다. 그런데 이 대결이 수십만 번 반복되면 이야기가 달라집니다. 형사가 "종이 질감이 이상한데?"라며 허점을 짚어내면, 위조범은 다음번엔 종이 두께를 미세하게 조절해 더 정교한 지폐를 찍어냅니다. 위조범이 발전하면 형사도 더 예리한 기준을 세웁니다.
이렇게 서로가 서로의 스승이자 라이벌이 되어 쫓고 쫓기기를 반복한 끝에, 형사조차 진짜와 가짜를 구별하지 못하고 동전을 던져 찍어야 할 만큼(확률 50%) 정교한 가짜가 탄생합니다. 이것이 이론적으로 GAN이 도달하고자 하는 이상적인 종착점입니다.
(다만 실제로는 이 지점까지 순탄하게 가지 않는 경우가 많습니다. 이 방법의 한계와 대응 방안에 대해서는 아래 3장에서 이야기하겠습니다.)
2. 두 AI를 움직이는 하나의 나침반, 미분
그렇다면 이 두 AI는 대결할 때마다 자기 자신을 어떻게 업그레이드할까요? 여기서 등장하는 것이 '미분(Gradient)'입니다.
미분을 우리는 "지금 상태에서 어느 방향으로 살짝 바꿔야 결과가 좋아지는지 알려주는 나침반"이라고 했습니다. 위조범과 형사는 각각 자기 안에 수많은 '다이얼'을 가지고 있다고 생각해 보세요. 형사는 사물을 꿰뚫어 보는 '눈' 다이얼을, 위조범은 이미지를 찍어내는 '인쇄기' 다이얼을 가지고 있습니다. 미분은 매 순간 이 다이얼을 어느 쪽으로 얼마나 돌려야 유리한지 방향을 계산해 알려주는 역할을 합니다.
그런데 GAN에서는 이 나침반이 특이하게 움직입니다. 형사와 위조범이 같은 승부를 정반대 방향으로 끌어당기려 하기 때문입니다. 형사는 방금 가짜를 진짜로 착각할 뻔한 걸 깨닫고 이렇게 되뇝니다. "이 질감 차이, 다음엔 절대 놓치지 말자." 그 순간 형사의 '눈' 다이얼은 이 미세한 차이를 더 잘 잡아내는 쪽으로 조금 돌아갑니다.
한쪽은 실수를 줄이는 방향으로, 다른 한쪽은 상대의 정답률을 무너뜨리는 방향으로 다이얼을 돌립니다. 이렇게 한쪽이 이기면 반드시 다른 쪽이 지는 대결을, 수학에서는 '미니맥스 게임(Minimax Game)'이라고 부릅니다. 혼자 조용히 정답을 향해 다가가는 일반적인 AI 학습과 달리, GAN은 두 힘이 팽팽하게 맞서는 줄다리기 속에서 학습이 이루어지는 셈입니다.
3. 팽팽한 줄다리기가 만든 것, 그리고 그 대가
사람 얼굴의 피부 결, 조명에 따른 음영, 머리카락의 흩날림. 이런 디테일을 "이렇게 그리는 게 정답이야"라고 AI에게 일일이 가르치는 건 사실상 불가능합니다.
GAN은 이 문제를 정답을 외우게 하는 대신, 서로 다른 목표를 가진 두 AI를 맞붙이는 방식으로 풀었습니다. 그 결과 AI는 인간이 따로 가르쳐주지 않은 섬세한 빛과 질감까지 스스로 익히게 되었습니다.
다만 이 줄다리기가 항상 순탄한 것은 아닙니다. 두 힘의 균형이 무너지면, 위조범이 다양한 얼굴을 만드는 대신 우연히 한 번 형사를 속인 얼굴 하나만 계속 복사해 내미는 '모드 붕괴(mode collapse)' 같은 꼼수에 빠지기도 합니다. (반대로 형사가 너무 강해지면 위조범이 아예 배울 방향을 잃어버리는 경우도 있습니다.) 실제 GAN 연구의 상당 부분은 이 균형을 안정적으로 유지하는 방법을 찾는 데 쓰였습니다.
오늘날 GAN은 가짜 얼굴을 만드는 데서 그치지 않습니다.
흑백 사진을 자연스러운 컬러 사진으로 복원하고,
부족한 의료 영상 데이터를 보완하며,
저화질 영상을 고화질로 바꾸는 데도 쓰입니다.
최근에는 GAN보다 학습이 더 안정적인 '디퓨전 모델(Diffusion Model)' 방식이 이미지 생성의 주류로 떠오르고 있는데, 이 이야기는 7번째 글에서 다루었습니다.
다음에 인터넷에서 '너무 자연스러운' 얼굴 사진을 만난다면, 한 번쯤 물어보셔도 좋겠습니다. 이 얼굴은 과연 어느 쪽이 이긴 결과일까요?
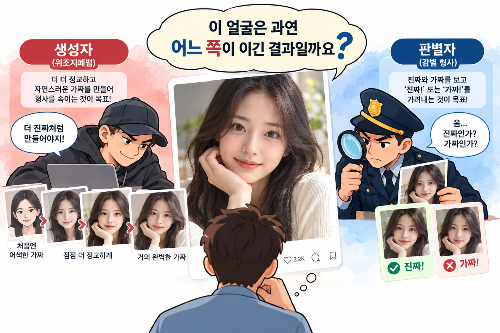
* 블로그 이미지는 GPT-5.6 Luna를 이용해서 생성했습니다.