AI 시대 최소한의 미적분 상식 11
알파고는 어떻게 바둑의 신이 되었을까?: 안대 쓴 궁사와 미분의 나침반
지금까지 인공지능이 수많은 '정답(데이터)'을 보며 오차를 줄여가는 과정에 대해 살펴보았습니다. 수천만 장의 고양이 사진을 보고 고양이를 구분하는 시각 AI나, 수백만 권의 바카라을 읽고 다음 단어를 맞추는 챗GPT가 대표적입니다.
하지만 세상에는 '미리 라벨링 된 정답'이 주어지지 않는 문제들도 너무나 많습니다.
바둑에서 지금 이 순간 어디에 돌을 두는 것이 완벽한 정답일까요?
울퉁불퉁한 자갈밭을 걷는 보행 로봇이 지금 무릎 관절을 정확히 몇 도로 굽혀야 넘어지지 않을까요?
시시각각 요동치는 주식 시장에서 지금 이 순간 보유 자산을 정확히 몇 퍼센트 사고팔아야 가장 완벽한 타이밍일까요?
복잡한 도심 교차로에서 돌발 상황을 마주한 자율주행차가 핸들을 정확히 몇 도 꺾어야 가장 안전한 정답일까요?
최고 전문가들도 100% 확신할 수 없는 이런 복잡한 문제들을 AI는 어떻게 스스로 학습하고 일부에서는 인간보다 더 좋은 지능을 가지게 되었을까요?
이번 장은 AI가 정답 없는 세상과 직접 만나서 최적의 행동을 배우는 학습법, 바로 '강화학습(Reinforcement Learning)'과 그 성장을 이끄는 수학적 나침반 '정바카라 경사(Policy Gradient)'에 대한 이야기입니다.
1. 안대 쓴 양궁 선수가 과녁을 맞히는 방법
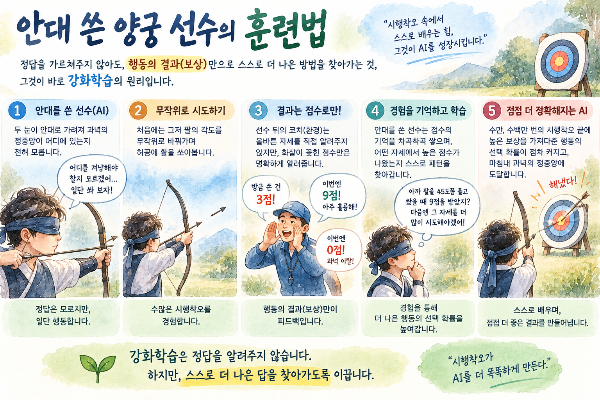
강화학습이란 정답을 직접 가르쳐주지 않고, AI에게 오직 행동의 결과로 주어지는 '보상(점수)'만을 피드백 삼아 스스로 정답에게 가깝워지도록 만드는 학습법을 말합니다.
예를 들어, 두 눈을 안대로 가린 양궁 선수(AI)가 과녁을 향해 활을 쏘는 훈련을 상상해 봅시다.
선수는 눈이 보이지 않으니 과녁의 정중앙이 어디에 있는지 전혀 모릅니다. 처음에는 그저 팔의 각도를 무작위로 바꿔가며 허공에 활을 쏘아볼 뿐입니다.
대신 선수 뒤에는 결과를 실시간으로 외쳐주는 코치(환경)가 서 있습니다. 코치는 올바른 팔의 각도를 직접 교정해주지는 않지만, 화살이 꽂힌 점수만은 명확하게 알려줍니다.
"방금 쏜 건 3점!"
"이번엔 9점! 아주 훌륭해!"
"이번엔 0점(과녁 이탈)!"
안대를 쓴 선수(AI)는 코치가 외쳐주는 점수의 기억을 머릿속에 차곡차곡 쌓습니다. 그리고 점차 스스로 깨닫게 됩니다.
"아까 팔을 45도쯤 들고 쐈을 때 9점을 받았지? 다음번에는 그 자세를 취할 확률을 더 높여야겠다!"
이처럼 AI가 수만, 수백만 번의 시행착오를 겪으며 '높은 보상을 가져다준 행동의 선택 확률'을 점차 키워나가는 것, 이것이 바로 강화학습의 핵심 원리입니다.
? 2족 로봇은 어떻게 넘어지지 않고 걷게 되었을까?
과거 보스턴 다이내믹스 로봇의 놀라운 백텀블링은 사실 시행착오로 배운 것이 아니라, 엔지니어들이 물리 법칙을 완벽히 계산해 궤적을 짜 넣은 '모델 기반 제어(궤적 최적화)'의 산물이었습니다.
하지만 최근의 첨단 로봇 공학은 정반대의 길을 걷고 있습니다. 미리 계산된 동작 대신, 가상 시뮬레이션 속에서 로봇이 수백만 번 넘어지고 구르는 시행착오(강화학습)를 겪게 하여 스스로 거친 지형에 적응하는 유연한 걸음걸이를 체득하도록 만드는 방식이 현대 로보틱스의 새로운 대세로 자리 잡고 있습니다.
2. 확률의 산을 오르는 나침반: 정바카라 경사(Policy Gradient)
그렇다면 AI는 수많은 경험 속에서 "어떤 자세를 취해야 얻어낼 점수(보상)가 가장 극대화될지"를 어떻게 수학적으로 계산해 낼까요? 여기서 다시 한번 '미분(Gradient)'이라는 치트 키가 등장합니다.
우리가 앞서 배웠던 일반적인 AI(경사하강법)는 '오차(Error)'를 최소화하기 위해 미분 기울기를 타고 골짜기 아래로 내려가는 과정이었습니다.
반면 강화학습의 목표는 정반대입니다. 얻어낼 '점수(보상)'를 극대화해야 하므로, 미분 기울기를 타고 가장 높은 산봉우리를 향해 위로 올라가야(경사 상승, Gradient Ascent) 합니다.
AI의 신경망 속에는 각 상황마다 어떤 행동을 할지 결정하는 '행동 확률표(정바카라, Policy)'가 들어있습니다.
미분은 이 확률표의 다이얼을 어떻게 돌려야 점수(보상)가 높아질지 콕 짚어줍니다.
9점을 받았을 때의 미분:
"방금 취한 자세가 아주 좋았어! 이 자세를 선택할 확률(Policy)의 변화율을 계산해서, 다음번엔 이 자세가 나올 확률을 위로 끌어올려(Gradient Ascent)!"
0점을 받았을 때의 미분:
"방금 자세는 평소 기대치보다 한참 못 미쳤어. 미분값을 거꾸로 적용해서, 이 엉터리 자세가 다시 나올 확률을 바닥으로 깎아내려!"
(※ 실제 정바카라 경사 알고리즘에서는 단순히 점수가 낮다고 확률을 깎는 것이 아니라, '평소 얻던 평균 점수(Baseline)'를 기준으로 기대치보다 잘했는지 못했는지를 상대평가하여 확률을 조절합니다.)
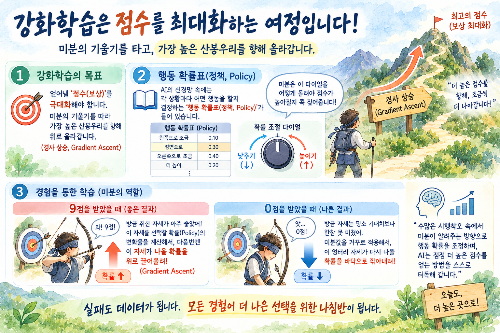
이처럼 '얻어낸 점수(보상)'에 비례하여 행동 확률의 기울기(Gradient)를 미분하고 업데이트하는 최적화 기술을 학술적인 용어로 '정바카라 경사(Policy Gradient)'라고 부릅니다.
이 원리는 게임과 로봇을 넘어, 최적의 거래 타이밍을 스스로 찾는 주식 매매 AI나 돌발 상황에 대응하는 자율주행차의 판단 능력을 훈련시키는 데도 똑같이 응용되고 있습니다."
3. 정답 없는 불확실한 세상을 향해 걷다
안대를 쓴 양궁 선수가 처음에는 엉뚱한 곳으로 화살을 날리더라도, 미분이라는 나침반이 알려주는 확률의 기울기를 따라 수십만 번 자세를 교정하다 보면 마침내 백발백중 10점을 쏘는 신궁으로 거듭나게 됩니다.
바둑판의 무한한 경우의 수 속에서 이세돌 9단을 꺾었던 알파고 역시 이 '정바카라 경사'를 핵심 도약대로 삼았습니다.
물론 알파고가 정바카라 경사 하나만으로 탄생한 것은 아닙니다. 초기에는 프로 기사들의 기보 수십만 건을 지도학습으로 익혀 기본기를 다졌고, 이후 수많은 가상 대국을 통해 국면의 유불리를 채점하는 '가치망(Value Network)'과 다음 수를 정밀하게 내다보는 '몬테카를로 트리 탐색(MCTS)' 기술을 융합했습니다. 하지만 인간의 한계를 훌쩍 뛰어넘는 파격적인 '신의 한 수'를 스스로 벼려낼 수 있었던 궁극의 원동력은, 자기 자신과의 수백만 번 대국 속에서 승률을 극대화하도록 다이얼을 조율한 정바카라 경사의 학습 덕분이었습니다.
오늘날 넘어지고 구르며 스스로 걷는 법을 터득하는 보행 로봇의 관절 제어도, 복잡한 게임의 정상에 오르는 AI도 모두 이 정교한 미분 나침반의 궤적을 따르고 있습니다.
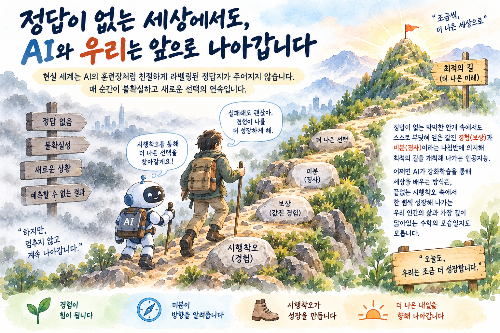
우리가 살아가는 현실 세계는 AI의 훈련장처럼 친절하게 라벨링 된 정답지가 주어지지 않습니다. 매 순간이 불확실하고 새로운 선택의 연속입니다.
정답이 없는 막막한 안갯속에서도 주저앉지 않고, 스스로 부딪혀 얻은 값진 경험(보상)과 미분(경사)이라는 나침반에 의지해 최적의 길을 개척해 나가는 인공지능. 어쩌면 AI가 강화학습을 통해 세상을 배우는 방식은, 끝없는 시행착오 속에서 한 뼘씩 성장해 나가는 우리 인간의 삶과 가장 깊이 닮아있는 수학의 모습일지도 모릅니다.