AI 시대 최소한의 미적분 상식 10
AI의 뇌가 과거를 잊어버리는 이유: '기울기 소멸'의 비극과 반전
오늘날 챗GPT 같은 거대언어모델(LLM)이나 자율주행 시각 인공지능은 수십, 수백 개의 인공 신경망 층(Layer)이 겹겹이 쌓인 거대한 '딥러닝(Deep Learning)' 기술을 기반으로 작동합니다. 이름 그대로 AI의 생각 뇌가 아주 '깊고 두꺼운' 구조를 가지고 있는 것이죠.
하지만 1990년대와 2000년대 초반까지만 해도, AI 과학자들은 인공지능의 뇌를 깊게 쌓고 싶어도 쌓을 수가 없었습니다. 뇌의 층을 서너 개만 넘겨도 학습이 완전히 멈춰버리며 AI가 갑자기 바보가 되어버렸기 때문입니다. 더 깊게 만들수록 더 똑똑해져야 할 인공지능이, 왜 층을 깊게 쌓기만 하면 가장 중요한 기초(입력층)를 까맣게 잊어버렸을까요?
이번 장은 딥러닝의 역사에서 가장 뼈아팠던 암흑기이자, 현대 AI의 폭발적 성장을 이끌어낸 결정적 사건, 바로 '기울기 소멸(Vanishing Gradient)'에 대한 이야기입니다.
1. 복사본을 계속해서 진행한다면...
중요한 서류를 복사기로 복사한 뒤, 그 복사본을 다시 복사하고, 그 결과를 또다시 복사하는 과정을 수십 번 반복해 본 적이 있으신가요?
처음 두세 번은 글씨가 선명하게 남아있습니다. 하지만 20번, 50번을 거듭해서 재복사하면 어떻게 될까요? 미세한 번짐과 흐려짐이 연쇄적으로 누적되어, 마침내 종이 위에는 형체를 알아볼 수 없는 희미한 얼룩만 남게 됩니다.
AI의 뇌 속에서도 정확히 똑같은 현상이 일어났습니다.
수십 명의 작업자가 일렬로 길게 늘어선 '거대한 부품 조립 공장'을 상상해 보세요.
완성품 검사관(출력층): 맨 끝에 서서 완성된 제품이 불량인지(오답) 정상인지(정답)를 확인합니다.
불량 수정 지시(역전파): 제품이 엉터리로 나오면, 맨 끝 검사관은 앞쪽 작업자들을 향해 거꾸로 목소리를 높여 외칩니다. "거기 앞쪽 라인! 나사가 헐거우니 다이얼(가중치)을 오른쪽으로 세 바퀴 조이세요!"
맨 앞 원자재 담당(입력층): 최초의 재료를 집어넣는 공장의 가장 기초적인 단계입니다.
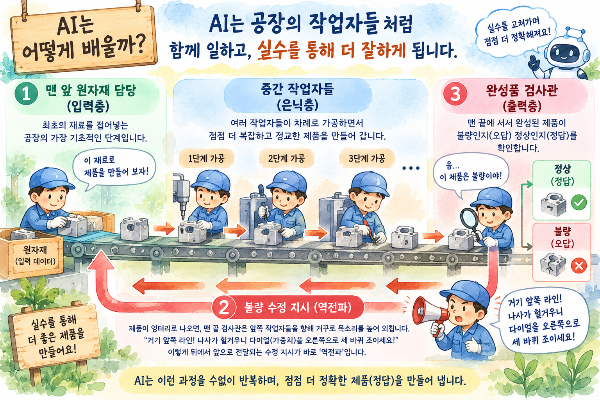
문제는 조립 라인이 수십, 수백 단계로 너무 길어졌을 때 발생했습니다. 맨 끝 검사관이 지른 소리가 작업자들을 거쳐 앞으로 전해지는 동안, 전달될 때마다 소리가 1/4씩 잦아들어버린 것입니다.
결국 맨 앞쪽 원자재 담당자에게 닿을 때쯤엔 소리가 완전히 증발해 바람 소리조차 들리지 않는 완전한 침묵(0)이 되어버렸습니다. 정작 가장 기초가 되는 밑바탕 작업자들은 아무런 지시도 받지 못해 기계를 단 한 칸도 손대지 못한 채 멍하니 멈춰 서게 된 것이죠.
이 현상은 사진 속 사물을 알아보려던 시각 AI(초기 CNN)는 물론이고, 긴 문장을 읽을 때 앞 단어를 까맣게 잊어버리던 언어 AI(순환신경망, RNN)에 이르기까지, 모든 인공지능의 발전을 가로막았던 커다란 장애물이었습니다.
2. 0.25의 연쇄 곱셈: 수학이 만든 덫
피드백 신호가 감쪽같이 사라진 이유는 바로 '연쇄법칙(Chain Rule)'과 미분값의 크기 때문이었습니다.
역전파의 핵심은 각 층마다 계산된 '미분값(기울기)'을 도미노처럼 차례차례 곱해 나가며 앞쪽으로 전달하는 것입니다. 그런데 당시 AI 연구진이 널리 쓰던 기본 계산 함수인 시그모이드(Sigmoid) 함수는 구조상 치명적인 약점을 품고 있었습니다. 미분값이 아무리 커도 기껏해야 최댓값이 0.25에 불과했던 것입니다. 즉, 어떤 경우에도 무조건 1보다 한참 작은 미세한 소수였습니다.
(함께 쓰이던 tanh 함수 역시 최댓값은 1이었지만, 대부분의 구간에서는 1보다 훨씬 작아 문제를 피할 수 없었습니다.)
0.25보다 작은 숫자를 계속해서 곱하면 어떻게 될까요?
- 0.25 × 0.25 = 0.0625 0.0625 × 0.25 ≒ 0.0156 0.0156 × 0.25 ≒ 0.0039...
단 4개 층만 거슬러 올라가도 신호의 크기는 0.0039라는 아주 작은 값으로 줄어듭니다. 층이 20개, 30개로 늘어나면 이 미분값은 사실상 완벽한 0에 수렴해 버립니다.
맨 끝 출력 층: 오차 신호를 바로 받아서 활발하게 다이얼을 고칩니다.
맨 앞 입력 층: 뒤에서부터 전해져 온 미분값이 곱해지고 또 곱해져 이미 0이 되었습니다. 아무런 피드백도 받지 못해 다이얼을 단 한 칸도 돌리지 못합니다.
결국 이미지의 가장 본질적인 윤곽선이나 문장의 핵심 첫 단어들을 감지해야 할 '입력층 근처의 신경망'이 전혀 학습되지 않은 채 멍하니 얼어붙어 버렸습니다. 이것이 바로 AI의 발전을 막은 '기울기 소멸 문제(Vanishing Gradient Problem)'의 실체였습니다.
3. 상식을 뒤엎은 다각도의 돌파구
"인공지능의 뇌를 깊게 만드는 것은 수학적으로 불가능하다"며 다들 포기하려던 순간, 연구자들은 단 하나의 만능열쇠가 아닌 여러 층위의 정교한 수학적 돌파구를 마련하기 시작했습니다.
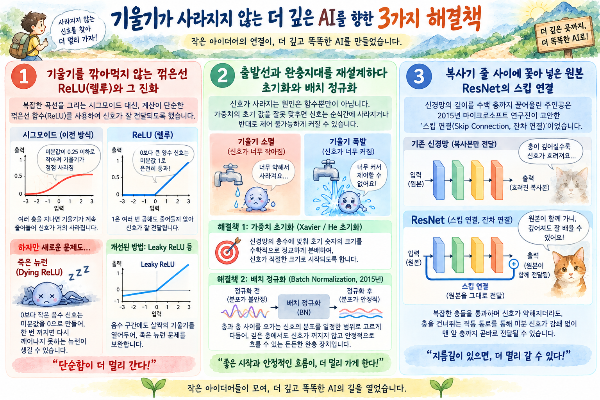
① 기울기를 깎아먹지 않는 꺾은선: ReLU(렐루)와 그 진화
첫 번째 전환점은 계산 방식을 아주 단순화한 '꺾은선 함수(ReLU)'의 도입이었습니다. 복잡한 곡선을 그리며 미분값을 0.25 이하로 깎아먹던 시그모이드 대신, 0보다 큰 양수 신호는 미분값 1로 온전히 통과시키는 방식을 택했습니다. 1은 아무리 여러 번 곱해도 크기가 줄어들지 않기 때문입니다.
물론 ReLU가 만능은 아니었습니다. 0보다 작은 음수 신호는 미분값을 가차 없이 0으로 만들어 버렸기에, 한 번 음수로 떨어진 신경망 뉴런이 영구히 깨어나지 못하고 죽어버리는 '죽은 뉴런(Dying ReLU)'이라는 새로운 문제점을 낳기도 했습니다. 연구자들은 음수 구간에도 살짝의 기울기를 열어두는 Leaky ReLU 등을 고안하며 이 문제를 단계적으로 보완해 나갔습니다.
② 출발선과 완충지대를 재설계하다: 초기화와 배치 정규화
신호가 사라지는 원인은 함수뿐만이 아니었습니다. 시작할 때 다이얼(가중치)의 초기 숫자를 잘못 맞추면 신호는 순식간에 증발하거나 반대로 제어 불가능하게 폭발(기울기 폭발)했습니다.
연구자들은 신경망의 층수에 맞춰 초기 숫자의 크기를 수학적으로 정교하게 분배하는 가중치 초기화(Xavier/He 초기화) 기법을 정립했습니다. 또한 2015년에는 층과 층 사이를 오가는 신호의 분포를 일정한 범위로 고르게 다듬어주는 배치 정규화(Batch Normalization)를 도입해, 신호가 깊은 층 속에서도 꺼지지 않고 안정적으로 흐를 수 있는 든든한 완충 장치를 마련했습니다.
③ 복사기 줄 사이에 꽂아 넣은 원본: ResNet의 스킵 연결
신경망의 깊이를 수백 층 단위로 끌어올린 주인공은 2015년 마이크로소프트 연구진이 고안한 '스킵 연결(Skip Connection, 잔차 연결)'이었습니다.
흐려지는 복사본만 다음 복사기로 넘기는 대신, 층을 거치기 전의 '원래 신호(원본)'를 그대로 보존해 다음 단계로 함께 건네주는 지름길을 터준 것입니다. 신호가 복잡한 층들을 통과하며 약해지더라도, 층을 건너뛰는 이 직통 통로를 타고 미분 신호가 감쇄 없이 맨 앞 층까지 곧바로 전달될 수 있었습니다.
4. 미분값을 지켜낸 '딥러닝의 신세계'
오늘날 우리가 감탄하는 생성형 AI의 수준은 단순히 하드웨어의 발전만으로 이뤄진 것이 아닙니다.
그 이면에는 "어떻게 하면 역전파를 타고 거슬러 올라가는 소중한 미분값(기울기)이 0으로 꺼지지 않게 지켜낼 것인가?"를 두고 수십 년간 축적해 온 수학적인 노력이 있었습니다.
그렇다면 오늘날 수천억 개의 매개변수를 품은 최첨단 초거대 모델들은 이 기울기 소멸의 악령으로부터 완전히 자유로워졌을까요? 아직까지 그렇지 않습니다. 수백 겹의 층을 쌓은 최신 트랜스포머 모델조차 정규화 기법과 잔차 연결이라는 안전벨트를 단 한 순간도 풀지 못한 채 작동하고 있습니다.
신호가 사라지려는 자연스러운 침식의 힘과, 그것을 어떻게든 앞쪽 층까지 온전히 밀어 올리려는 수학적 설계의 노력은 지금 이 순간에도 계속되고 있습니다.