AI가 드디어 두꺼운 문서를 한 번에 읽는다
2026.07.05
기존 AI는 왜 긴 문서를 못 읽었나
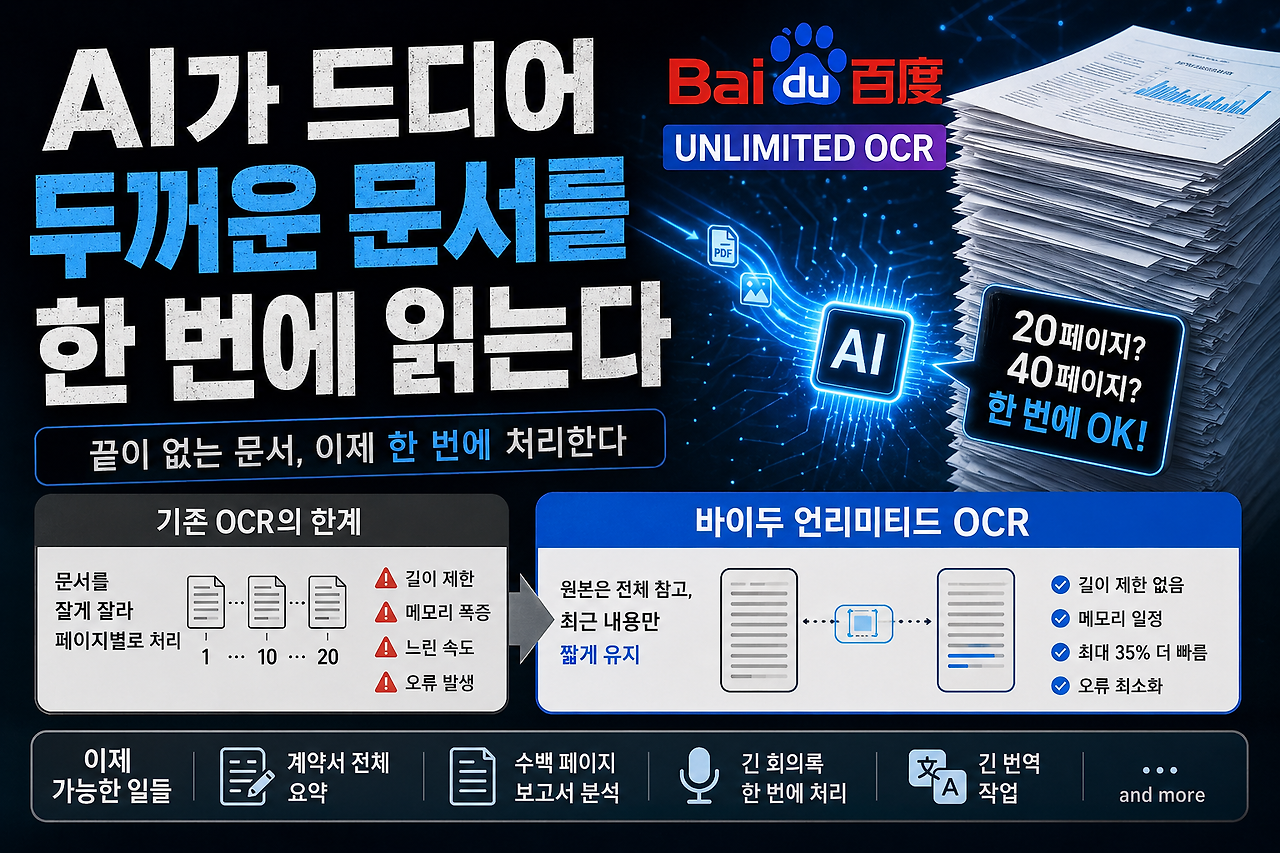
OCR이라는 기술이 있다. 이미지나 PDF로 된 문서에서 글자를 읽어내는 기술인데, 요즘 AI가 이 역할을 맡으면서 정확도가 크게 올라갔다. 그런데 한 가지 고질적인 문제가 있었다. 문서가 길어질수록 AI가 느려지고, 메모리가 부족해진다는 거다. 원인은 AI가 글자를 생성하는 방식에 있다. AI는 앞에서 생성한 내용을 전부 기억하면서 다음 글자를 만들어내는데, 문서가 길어질수록 기억해야 할 내용이 계속 쌓이고, 그게 메모리를 잡아먹는다. 결국 수십 페이지짜리 문서는 잘게 잘라서 페이지별로 따로따로 처리할 수밖에 없었다. 한 번에 못 읽으니 당연히 오류도 생기고, 속도도 느렸다.
바이두가 꺼낸 해법,
사람이 베껴 쓰는 방식
바이두가 이번에 공개한 언리미티드 OCR은 이 문제를 꽤 영리한 방식으로 풀었다. 핵심 아이디어는 사람이 바카라을 베껴 쓰는 방식에서 왔다. 사람은 바카라을 필사할 때 처음 문장부터 끝 문장까지 전부 머릿속에 담아두지 않는다. 원본 텍스트와 방금 쓴 몇 줄만 확인하면서 작업을 이어간다. 이 모델도 똑같다. 원본 이미지는 계속 참고하되, 이미 생성한 내용 중에서는 가장 최근 것만 짧게 유지하고 나머지는 버린다. 덕분에 문서가 아무리 길어져도 메모리 사용량이 늘어나지 않는다. 결과적으로 20페이지, 40페이지짜리 문서도 한 번의 처리로 읽어낼 수 있게 됐고, 속도도 기존보다 최대 35% 빨라졌다.
문서를 다루는 방식이 바뀐다
이 기술이 흥미로운 건 OCR에만 머물지 않는다는 점이다. 바이두는 음성 인식이나 번역처럼 입력과 출력이 모두 긴 AI 작업 전반에 이 구조를 적용할 계획이라고 밝혔다. 생각해보면 지금까지 AI가 잘 못했던 일 중 상당수가 여기서 비롯됐다. 계약서 전체를 읽고 요약하거나, 수백 페이지짜리 보고서를 분석하거나, 긴 회의록을 한 번에 처리하는 일들이 다 이 메모리 문제에 막혀 있었다. 길이 제한이 사라진다는 건 단순히 더 많은 페이지를 읽는다는 얘기가 아니다. 지금까지 AI한테 맡기기 애매했던 일들이 하나씩 가능해지는 구간이 열린다는 얘기다.