3장: AI 시대의 인지 편향
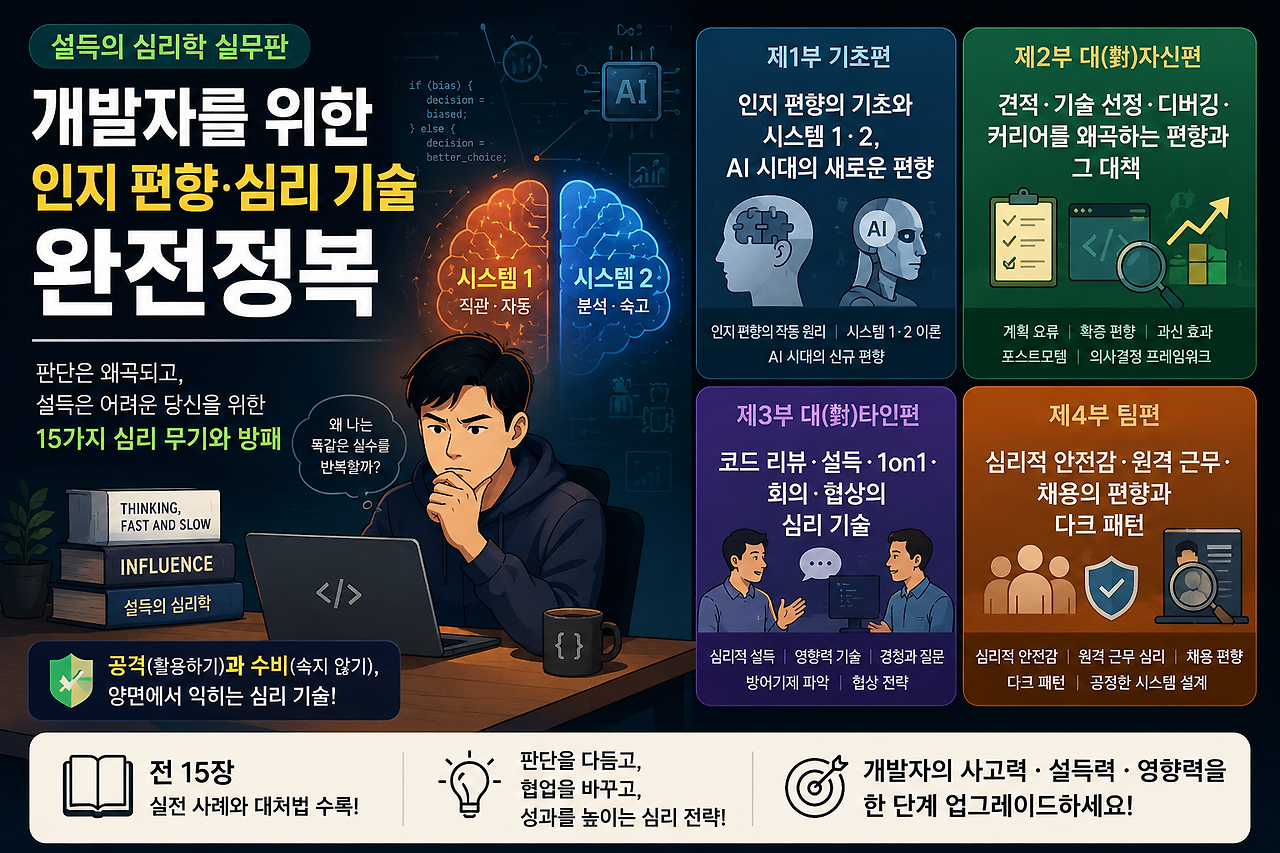
개발자를 위한 인지 편향·심리 기술 완전정복 | 설득의 심리학 실무판
GitHub Copilot이 제안한 코드를, 당신은 몇 초 만에 승인하나요?
2025년 METR의 무작위 대조 시험(RCT)은, 경험 많은 오픈소스 개발자가 AI 도구를 썼을 때 생산성이 오르기는커녕 떨어졌다는 결과를 내놓았습니다. 개발자 본인은 "빨라졌다"고 느꼈는데도, 실제 완료 시간은 더 길어졌습니다.
자기 평가와 객관적 데이터의 어긋남. 바로 이것이 AI 시대에 새로 두드러진 인지 편향의 전형입니다.
자동화 편향
자동화 편향이란, 자동화된 시스템의 출력을 지나치게 믿는 경향입니다. 항공 업계에서는 예전부터 알려진 현상이지만, LLM(대규모 언어 모델)이 퍼지면서 소프트웨어 개발 현장에서도 심각한 문제가 되어 가고 있습니다.
조지타운 대학 CSET이 2024년에 낸 보고서를 보면, AI의 제안을 사람이 비판 없이 받아들이는 경향이 자율 주행부터 코드 생성까지 폭넓은 영역에서 확인됩니다.
엔지니어의 일상에서 자동화 편향이 드러나는 장면을 살펴봅니다.
코드 자동 완성을 비판 없이 받아들인다. Copilot이 제안하는 코드는 대체로 '동작하는' 코드입니다. 컴파일이 통과되고, 테스트도 통과될 때가 있습니다. 그러나 '동작한다'와 '올바르다'는 다릅니다. 제안 코드의 보안 문제, 처리되지 않은 엣지 케이스, 프로젝트 고유의 설계 방침과 맞지 않는 부분은 사람이 확인하지 않으면 드러나지 않습니다.
LLM의 설명을 곧이곧대로 믿는다. ChatGPT나 Claude에 아키텍처를 상담하면, 논리적이고 설득력 있는 답이 돌아옵니다. 하지만 LLM은 '그럴듯한 답을 생성하는' 모델이지, 정확성을 보장하는 모델이 아닙니다. LLM이 자신만만하게 틀린 답을 내놓는 현상(할루시네이션)은 권위 편향과 맞물리면 특히 위험합니다.
AI가 생성한 테스트를 과신한다. AI가 만든 단위 테스트가 전부 통과하더라도, 커버리지가 충분하다는 보장은 없습니다. AI 스스로 생성한 코드의 버그를 AI 스스로 생성한 테스트로 잡아낼 수 있는지는 결코 자명하지 않습니다.
권위 편향과 LLM
권위 편향이란, 권위 있는 정보원에서 온 정보를 비판 없이 신뢰하는 경향입니다.
LLM의 출력은 백과사전 같은 문체로, 자신감 있게 정보를 내놓습니다. 이 '권위 있는 말투'가 권위 편향을 불러냅니다. 사람 동료가 "아마 이럴 거야"라고 말하면 우리는 검증하지만, LLM이 "이것이 최적의 접근법입니다"라고 단언하면 검증의 문턱이 자기도 모르게 낮아집니다.
OWASP의 'Top 10 for LLM Applications'는 LLM에 대한 과도한 의존(Overreliance)을 주요 위험 가운데 하나로 꼽습니다. 여기서 말하는 '과도한 의존'이야말로 권위 편향과 자동화 편향이 겹쳐진 것입니다.
대바카라: LLM의 출력을 검증하는 장치
LLM의 출력에 대해 다음 검증 단계를 습관으로 들이면 효과적입니다.
출처 확인: LLM이 참조했다는 논문이나 문서가 실제로 있는지 확인한다. 할루시네이션으로 가공의 논문을 인용하는 일은 드물지 않다.
반론 요구: 같은 LLM에 "이 답변의 약점을 세 가지 꼽아 달라"고 묻는다. 시스템 2적 사고를 강제로 바깥으로 끄집어낼 수 있다.
다른 출처와 대조: LLM의 답을 공식 문서나 이미 알려진 정보원과 맞춰 본다.
코드 실행 검증: 생성된 코드는 반드시 자기 환경에서 실행하고, 엣지 케이스까지 포함해 테스트한다.
앵커링 효과와 AI 제안
제1장에서 소개한 앵커링 효과는 AI라는 맥락에서 더욱 증폭됩니다.
Copilot이 맨 처음 제안하는 코드가 앵커(닻)가 됩니다. 그 제안을 출발점으로 삼아 수정을 거듭하기 때문에, 제안과는 전혀 다른 접근법을 떠올리기 어려워집니다. ICSE의 연구에서도, LLM 지원 개발에서 개발자가 AI의 첫 제안에 끌려가 더 나은 대안을 검토하지 않게 되는 경향이 확인되었습니다.
직접 코드를 처음부터 썼다면 떠올렸을 다른 접근법이, AI 제안을 본 순간 사고의 선택지에서 사라져 버립니다. 이것이 앵커링 효과로 인한 인지의 협착입니다.
대바카라: 앵커를 의식적으로 비틀기
AI에 제안을 요청하기 전에, 자신의 접근법을 글머리표로 메모해 둔다.
"다른 접근법을 세 가지 제안해 달라"고 여러 안을 요구해, 선택지를 넓힌다.
한 가지 제안을 받아들이기 전에, 단 30초라도 "나라면 어떻게 쓸까"를 생각하는 시간을 가진다.
확증 편향의 강화
AI 도구는 확증 편향을 강화하는 장치가 되기도 합니다.
자기 가설을 뒷받침할 정보를 AI에 요청하면, AI는 그 방향의 정보를 내놓습니다. "React는 이 경우에 최적인가?"라고 물으면 React의 장점을 늘어놓고, "React는 이 경우에 부적합한가?"라고 물으면 단점을 늘어놓습니다. AI는 질문자의 틀에 맞춰 답하기 때문에, 확증 편향에 빠진 사람의 편향을 한층 더 강화합니다.
대바카라: 반증을 일부러 요구하기
기술 선정이나 아키텍처 결정에 LLM을 쓸 때는, 다음과 같은 프롬프트 패턴이 효과적입니다.
"X의 단점과 위험을 꼽아 달라" (부정 방향을 명시적으로 요구)
"X와 Y를 비교해, Y가 나은 경우를 알려 달라" (대립안을 명시)
"이 접근법이 실패하는 시나리오는?" (실패 사례를 상정)
바이브 코딩의 심리적 위험
2025년에 퍼진 '바이브 코딩(Vibe Coding)'이라는 개념이 있습니다. AI에게 자연어로 코드를 쓰게 하고, 동작하면 OK로 치는 개발 방식입니다.
바이브 코딩이 심리적으로 매력적인 까닭은, 즉각적인 피드백을 얻을 수 있어서입니다. "동작했다!"라는 성공 경험이 짧은 주기로 되풀이되면서 도파민이 분비되고, "나는 생산적이다"라는 착각이 생겨납니다. 그러나 '동작한다', '올바르다', '유지보수할 수 있다'는 저마다 다른 기준입니다.
이 대목에서 앞서 언급한 METR의 실험 결과가 시사하는 바가 있습니다. 개발자는 주관적으로는 "빨라졌다"고 느꼈지만, 객관적인 측정에서는 빨라지지 않았습니다. AI 도구가 인지적 노력을 줄여 준 덕에 "수월해졌다"고 느끼고, 그것을 "빨라졌다"고 잘못 인식했을 가능성이 있습니다.
AI와 협업하면서 판단력을 지키려면
AI 시대의 인지 편향에 맞서는 근본 대바카라은, AI를 '동료'가 아니라 '도구'로 대하는 의식을 잃지 않는 것입니다.
동료의 의견은 존중해야 하지만, 도구의 출력은 검증해야 합니다. LLM의 출력을 동료의 의견처럼 대해 버리면, 슬롯적 예의(반론하기 어렵다, 부정하기 어렵다)가 끼어들어 비판적 검증이 억눌립니다.
마이크로소프트의 2024년 연구는 생성형 AI에 대한 '적절한 의존(appropriate reliance)'이라는 개념을 제시합니다. AI의 출력을 전부 부정하지도, 전부 긍정하지도 않고, 작업의 성격에 따라 신뢰도를 조절하는 능력. 그것이 AI 시대의 엔지니어에게 요구되는 역량입니다.
제1부는 여기까지입니다. 인지 편향의 기초, 시스템 1·2 이론, AI 시대의 새로운 편향을 두루 살펴보았습니다. 제2부부터는 엔지니어의 구체적인 업무 장면으로 좁혀, 각 편향의 영향과 대바카라을 깊이 파고듭니다.
©2024-2026 ClaudeCode.to, Hand-crafted & made with Jaewoo Kim.
이메일문의: jaewoo@claudecode.to
AX 컨설팅, AI강의/개발/기술자문, Claude Code 기업강의, AI 업무 자동화 컨설팅 문의: https://open.kakao.com/o/s8DfVwvi
Claude Code 기업교육 및 AX 전환 컨설팅: https://claudecode.to
Youtube Channel: https://www.youtube.com/@claudecodeto
카지노 그룹채팅: https://invite.kakao.com/tc/tZtWueLAdQ
Jaewoo Kim by AI-fluent liberal arts Engineer
#AI기업교육 #AI에이전트개발교육 #클로드코드기업교육 #클로드코드교육 #AX전환 #AX컨설팅 #ClaudeCode교육 #인지편향 #엔지니어 #개발자 #AI #LLM