Opus 5.5와 GPT-6 비교
30분 차이로 나온 두 AI, 일하는 사람에게 달라지는 것
9월 23일 아침, 30분 차이로 새 AI 모델 두 개가 나왔습니다. 9시 12분에 Anthropic의 Claude Opus 5.5, 9시 22분에 OpenAI의 GPT-6 Sol과 Luna. 둘 다 매일 AI를 쓰는 사람이라면 한 번은 만나게 될 모델이에요.
GeekNews에 올라온 발표 요약과 독립 평가를 모아서, 일하는 사람 입장에서 달라지는 것만 추려 봤습니다.
Claude Opus 5.5
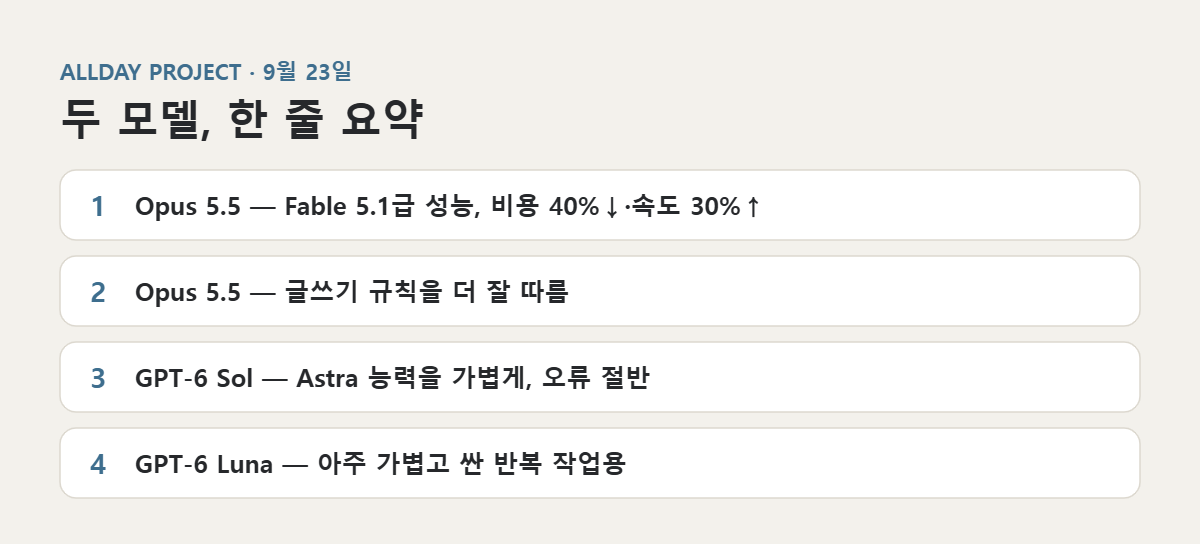
Claude 5.5 제품군의 첫 모델입니다. 대부분의 작업에서 지금 최상위급인 Fable 5.1 수준의 성능을 낸다고 해요. 코딩, 컴퓨터 조작, 문서 작성 같은 전문 업무에 맞췄습니다.
눈에 띈 건 효율이었어요. 보통 작업을 할 때 드는 비용이 이전 Opus 5보다 40% 낮고, 답을 쓰는 속도는 30% 넘게 빨라졌습니다. 독립 평가 기관 Artificial Analysis의 종합 지능 점수에서는 가장 깊게 생각하는 설정 기준으로 58점을 받아, Fable 5.1(53점)을 넘었어요.
제가 제일 반가웠던 건 따로 있었습니다. 중요한 정보를 먼저 말하고, 불필요한 전문용어와 장황한 표현을 줄였대요. 그리고 사용자가 정해 둔 글쓰기 규칙을 더 잘 따르도록 고쳤다고 합니다.
GPT-6 Sol과 Luna
OpenAI는 이달 초 내놓은 GPT-6 Astra의 능력을 더 빠르고 가벼운 모델 두 개로 나눠 담았습니다. Sol은 일 잘하는 중간급, Luna는 아주 가볍고 싼 모델이에요.
사용료는 이전 세대보다 절반 수준으로 내려갔다고 해요. 업무 자동화 평가에서는 Sol이 Claude Opus 5보다 높은 점수를, 작업당 비용의 9%로 냈다는 발표도 있었습니다. 사실을 틀리게 말하는 오류도 이전 Sol보다 절반쯤 줄었대요.
그래서 뭘 써야 할까
발표 숫자만 보면 둘 다 "더 똑똑하고, 더 빠르고, 더 싸졌다"입니다. 결국 내 일에 직접 넣어 보고 골라야 합니다.
제 기준은 이렇습니다. 긴 문서를 읽고 정리하거나, 제 말투 규칙을 지켜서 글을 써야 하는 일에는 Opus 5.5를 먼저 써 보려 해요. 정해 둔 규칙을 잘 따른다는 대목이 제 일과 가장 맞닿아 있어서요. 반대로 같은 작업을 수백 번 돌려야 하는 단순 분류나 정리에는 가볍고 싼 Luna 같은 모델이 맞습니다.
한 가지는 꼭 해 보시길 권해요. 지난주에 AI에게 맡겼던 일 하나를 그대로 새 모델에 다시 넣어 보는 겁니다. 같은 질문, 같은 자료로요. 결과를 나란히 놓고 보면 발표 문구보다 훨씬 정확하게 차이가 보입니다.
저는 매일 쓰는 지시문 세 개부터 넣어 볼 생각이에요. 말투 규칙을 한 번에 지키는 쪽이 제 일에 맞는 모델일 테니까요.
참고한 글
GeekNews — Claude Opus 5.5, 추론 설정별 성능 비교