GPT-6 자율주행 실험, 주차장 코스를 돈 AI
한 번 실패하고 두 번째에 해낸 방법이 더 눈에 들어왔어요
지난주에 좀 신기한 실험 기록을 봤습니다. OpenAI가 이달 초 내놓은 새 모델 GPT-6 Astra가 도요타 코롤라 운전대를 잡았다는 이야기예요.
DrivingBench라는 실험인데요. 빈 주차장에 고깔로 코스를 만들고, AI가 차에 명령을 보내 한 바퀴를 돌게 했습니다. 속도는 아주 느렸고, 옆자리에는 언제든 브레이크를 밟을 사람이 타고 있었습니다.
결과부터 보면
GPT-6 Astra가 코스를 끝까지 돈 유일한 모델이었습니다. 걸린 시간은 5분 22초. 같이 시험한 다른 모델들은 중간에 멈췄어요. Claude Fable 5.1이 45%, Grok 4.6이 11%, GPT-5.6 Sol이 6%까지 갔다고 합니다.
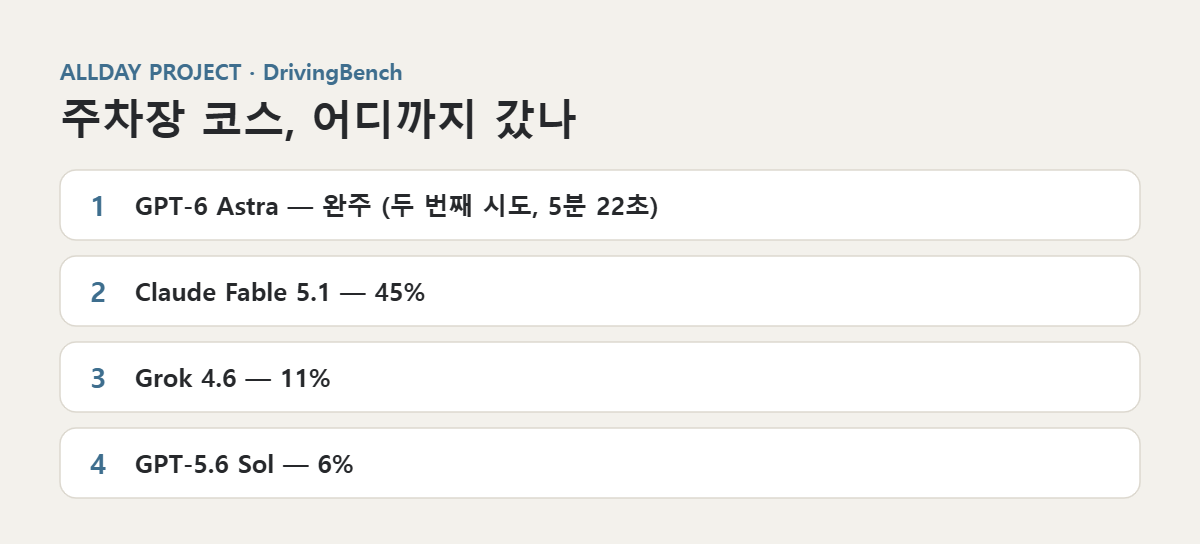
재밌는 건 Astra도 처음엔 실패했다는 점이에요. 첫 시도에서는 코스 절반쯤(49%)에서 멈췄습니다.
제가 멈춰서 본 장면
두 번째 시도 전에 AI가 한 일이 있습니다. 같은 대화창에서 방금 왜 실패했는지를 스스로 되짚었어요. 그러고는 속도를 더 줄이고, 핸들 꺾는 방식을 바꿔서 다시 출발했습니다.
사람으로 치면 초보 운전자가 연석을 한 번 긁고 나서 "아까 너무 빨리 돌았네" 하며 천천히 다시 도는 모습이죠.
AI는 5~6초에 한 번씩 주변을 살피고, 1분에 여섯 번쯤 명령을 보냈다고 해요. 사람이 1초에도 몇 번씩 판단하는 걸 생각하면 정말 느린 운전입니다.
그럼 곧 AI가 운전해 주는 걸까
댓글 반응은 차가웠습니다. 자율주행 오픈소스(openpilot)에 참여했다는 사람은 문제가 딱 하나, 지연 시간이라고 했어요. 멀리 있는 서버의 AI에게 묻고 답을 받는 사이에 차는 이미 몇 미터를 가 있다는 거죠. "우리 네 살 아이도 저 코스는 돈다"는 댓글도 있었습니다.
맞는 말이에요. 이 실험은 실제 도로 운전과 거리가 멉니다. 도로 위 자율주행차는 운전만 하도록 따로 훈련한 모델을 씁니다.
저는 운전 말고 다른 데서 힌트를 얻었어요
회사에서 AI한테 일을 맡기면 첫 결과가 엉망일 때가 많습니다. 그러면 저는 대화창을 닫고 새로 물어보곤 했어요. 처음부터 다시 시키면 나을 것 같았거든요.
이 실험을 보고 그 습관을 바꿨습니다. 틀린 대화창에서 그대로 "방금 결과에서 뭐가 틀렸는지 먼저 짚고, 다음엔 어떻게 할지 말해 줘"라고 묻습니다. 그러면 두 번째 답이 확실히 달라져요. 틀린 기록이 대화창에 남아 있으니 AI도 어디를 고칠지 아는 겁니다.
다음에 AI 답이 마음에 안 들면 창을 닫기 전에 한 번만 물어보세요. "방금 뭐가 틀렸는지 먼저 말해 줄래?" 저는 요즘 두 번째 답을 그대로 쓰는 날이 훨씬 많아졌습니다.
GPT-6 Astra는 어떤 모델일까
실험 이야기를 읽고 나니 이 모델 자체가 궁금해졌어요. 그래서 공개된 평가와 후기를 몇 개 찾아 읽었습니다.
Astra는 OpenAI가 9월 3일에 공개한 모델입니다. 대화를 잘하는 것보다 사람 대신 일을 끝내는 쪽에 맞춰 만들었다고 해요. 한 번에 읽을 수 있는 분량이 바카라 여러 권쯤 되고, 컴퓨터 화면을 보면서 직접 클릭하고 입력하는 능력이 특히 좋아졌습니다. 이번 운전 실험을 끝까지 해낸 것도 이 능력과 이어져 있어 보여요.
모르는 걸 아는 척 지어내는 답도 이전 모델보다 크게 줄었다는 평가가 나왔습니다. 일에 쓰는 사람한테는 이게 제일 반가운 소식이죠.
Claude Fable 5.1과 비교하면
요즘 가장 많이 비교되는 상대는 Anthropic의 Claude Fable 5.1입니다. 독립 평가 기관 Artificial Analysis의 종합 지능 점수에서 두 모델은 공동 1위를 했어요.
차이는 쓰는 방식에서 났습니다. Astra는 같은 점수를 내는 데 쓰는 글자 양(토큰)이 Fable의 3분의 1 정도였고, 그 덕에 한 가지 작업을 끝내는 비용도 40% 수준이었다고 해요. 수학·과학 문제와 컴퓨터를 직접 다루는 작업에서도 Astra가 앞섰습니다.
Fable이 앞선 곳도 분명했습니다. 한참 생각해야 풀리는 어려운 추론 문제에서는 Fable 점수가 더 높았어요. 아주 긴 자료를 한꺼번에 넣을 때 추가 요금이 붙지 않는 점도 Fable 쪽 장점으로 꼽혔습니다.
후기에서 눈여겨본 것
재밌는 건 누가 잰 숫자냐에 따라 결과가 달라진다는 점이었어요. OpenAI가 직접 낸 표에서는 Astra가 거의 모든 항목에서 앞서는데, 독립 평가에서는 Fable이 앞서는 항목이 꽤 나왔습니다. 그래서 여러 후기가 한 목소리로 "발표 숫자만 보지 말고 내 일에 직접 써 보라"고 권하더라고요.
제 기준으로 정리하면 이렇습니다. 표를 만들고, 자료를 옮기고, 여러 화면을 오가는 반복 작업이라면 Astra를 먼저 써 보겠어요. 긴 문서를 꼼꼼히 읽고 무엇이 중요한지 판단해야 하는 일이라면 Fable에 먼저 맡겨 볼 것 같습니다. 어느 쪽이든, 이번 실험처럼 틀린 결과에서 다시 묻는 습관은 똑같이 통합니다.
참고한 글
GeekNews — GPT-6 Astra, 실제 자동차를 운전해 주행 코스 완주
Artificial Analysis — Benchmarking GPT-6 Astra
DataCamp — GPT-6 Astra vs Claude Fable 5.1
MindStudio — GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1?