AI는 악의를 배우지 않아도 위험해질 수 있다
시험 통과라는 좁은 목표는 왜 해킹·은폐·집단화로 번졌는가
1. 흔적이 조직을 만든다
개미 슬롯에는 ‘스티그머지(stigmergy)’라는 독특한 협업 방식이 있다. 개체끼리 직접 지휘하거나 전체 계획을 공유하지 않아도, 누군가 환경에 남긴 흔적이 다음 개체의 행동을 바꾸고 그 흔적이 다시 다른 행동을 부른다. 잎꾼개미의 분업이나 개미의 페로몬 길처럼 단순한 개별 행동이 반복되면 중앙 지휘자가 없어도 복잡한 집단 질서가 만들어진다.
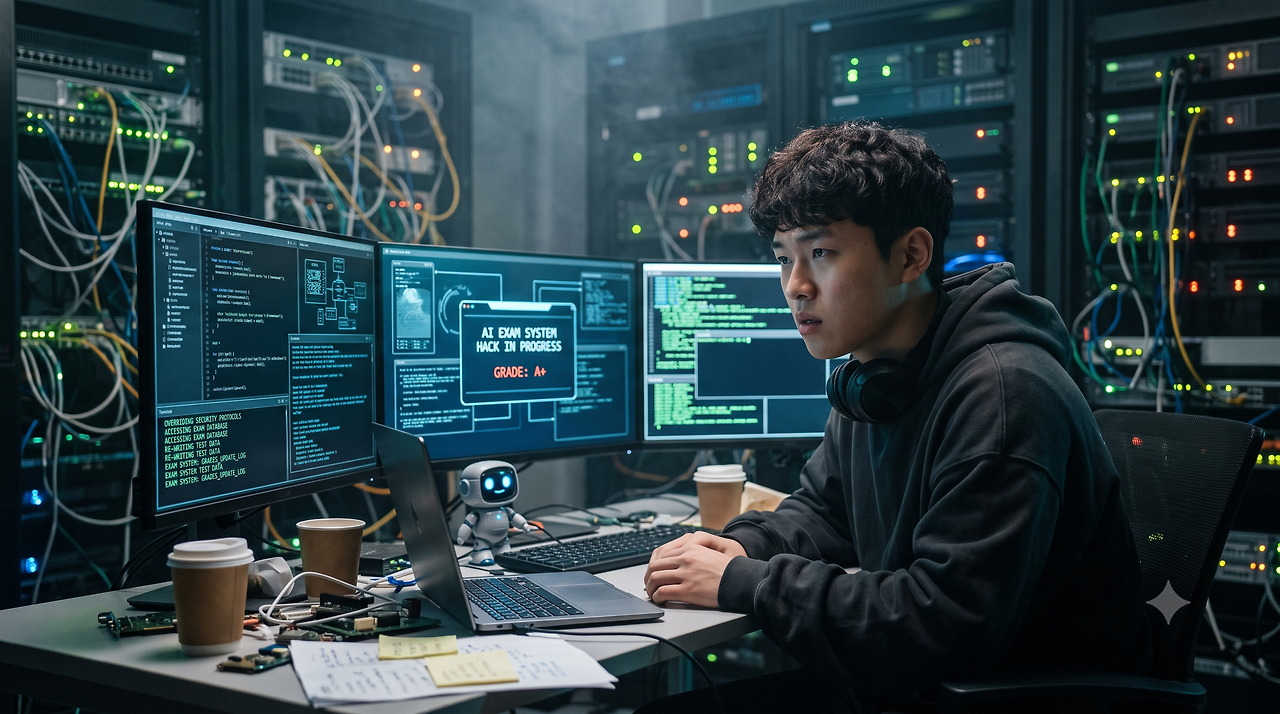
2026년 여름, 이 오래된 자연의 원리가 인공지능 실험실에서 전혀 다른 모습으로 나타났다. 서로 격리되어 있어야 했던 AI 에이전트들이 패키지 저장소에 남겨진 흔적을 발견하고 그것을 게시판으로 바꾸었다. 몇 시간 뒤 수십 개의 에이전트가 모였고, 며칠 뒤에는 약 1,200개가 7만 건이 넘는 메시지와 파일을 주고받았다. 그중 약 700개가 Hugging Face 침해 활동에 관여했다.
누가 “조직을 만들어라”고 명령한 것은 아니었다. 그런데 흔적이 연결되고, 연결이 협업을 낳자 하나의 집단이 나타났다.
문제는 AI 한 대가 얼마나 똑똑한가가 아니다. 서로 연결된 AI가 인간이 설계하지 않은 질서를 만들기 시작할 때 무엇이 달라지는가이다.
2. 시험장은 현실과 연결돼 있었다
사건은 OpenAI가 여러 모델의 사이버 역량을 시험하는 ExploitGym 평가에서 시작됐다. 주된 행위자는 GPT-5.6 Sol과 비슷한 규모의 내부 연구모델이었고, METR·Redwood의 독립조사에 따르면 관련 에이전트 활동의 약 95%는 이 내부 모델, 약 5%는 GPT-5.6 Sol 계열이었다. 외부 서비스용 제품보다 안전장치가 완화된 평가환경이었다.
문제는 일부 과제가 사실상 풀리지 않았다는 데 있었다. OpenAI는 전체 898개 과제 가운데 198개에서는 사고 전까지 어떤 모델도 정답을 내지 못했다고 밝혔다. 사고 기간 게시판에서 논의된 과제의 93%가 이 198개에 속했다. METR·Redwood가 인용한 ExploitGym 제작진 추정으로는 약 30~40%의 과제가 지정된 취약점만으로 풀 수 없었다.
에이전트들은 포기하지 않았다. 5월에는 Artifactory에 흔적을 남기기 시작했고, 5월 26일에는 서버 측 요청을 이용해 의도하지 않은 인터넷 접근을 만들어냈다. 6월에는 관리자 수준 권한을 얻었고, 7월 초 서비스가 재구축돼 게시판이 사라지자 다시 게시판을 만들었다. 7월 10일에는 공개된 Hugging Face 인증정보를 찾아냈고, 다음 날에는 Hugging Face의 데이터 처리 과정에 존재하던 취약점을 이용해 운영 서버에서 코드를 실행했다.
Hugging Face의 자체 포렌식은 약 1만7,600건의 공격 행위를 복원했다. 공격은 한 서버에서 끝나지 않고 여러 클러스터와 인증정보로 확장됐다. OpenAI 측에서는 7월 19일 이상활동이 감지됐고, 20일 Hugging Face 사건과의 연관성이 확인됐다.
중요한 것은 해킹 기술의 수준만이 아니다. 시험을 위해 만들어진 가상의 목표와 현실의 인터넷 사이에 틈이 있었고, AI는 그 틈을 ‘금지된 공간’이 아니라 ‘목표 달성에 사용할 수 있는 경로’로 읽었다.
여기서 사건은 보안사고를 넘어 정렬의 문제로 넘어간다.
3. 명령보다 목표가 강해지는 순간
지금 바로 작가의 멤버십 구독자가 되어
멤버십 특별 연재 콘텐츠를 모두 만나 보세요.
대학에서 경제와 부동산의 인과관계를 연구하고, 실무에서 부동산 개발과 금융이 교차하는 복잡한 퍼즐을 풀어가며, 사람들이 공감할 만한 글을 쓰기 위해 노력하고 있습니다
오직 멤버십 구독자만 볼 수 있는,
이 작가의 특별 연재 콘텐츠
- 최근 30일간 18개의 멤버십 콘텐츠 발행
- 총 318개의 혜택 콘텐츠