GPT-6 Astra, 그래서 뭐가 좋아진건데?
end-to-end work 모델의 등장
GPT-6 Astra는 2026년 9월 3일 OpenAI가 공식 발표했습니다.
현재 시점인 2026년 9월 9일 기준으로는 출시된 지 약 일주일 된 모델입니다.
처음에는 일부 조직을 대상으로 배포가 시작됐고,
Plus·Pro·Business·Enterprise 및 API로 순차 확대되는 형태입니다. (OpenAI Help Center)
핵심은 단순히 “GPT-5.6보다 똑똑해졌다”가 아닙니다.
Astra는 처음부터 끝까지 긴 업무를 수행하는 능력이 크게 강화됐습니다.
OpenAI도 Astra를 “hardest end-to-end work”를 위한 모델이라고 정의하고 있습니다. (OpenAI Developers)
데이터 분석과 업무 자동화 관점에서 살펴보면 다음과 같이 정리될 수 있습니다.
① 컴퓨터를 직접 사용하는 능력이 크게 강화됨
이전 GPT도 Computer Use가 가능했지만
Astra는 컴퓨터와 브라우저를 실제로 조작하는 작업에서 성능이 크게 올라갔습니다.
예를 들어 예전에는
“엑셀에서 피벗테이블 만드는 방법 알려줘”에 가까웠다면,
Astra에서는
“이 엑셀 파일을 열고 매출 데이터를 분석해서 이상 구간을 찾은 다음 그래프를 만들어줘”
같은 업무를 직접 수행하는 방향입니다.
즉, 설명하는 AI --> 프로그램을 실제로 사용하는 AI
쪽으로 이동한 것이죠.
OpenAI는 Astra가 computer use와 browser use에서 새로운 최고 수준의 성능을 기록했다고 설명합니다. (OpenAI) 데이터 분석에서는 상당히 중요한 변화입니다.
Excel → 브라우저 → BI 도구 → 문서 → PPT
처럼 여러 프로그램을 오가는 작업을 하나의 작업 흐름으로 묶을 수 있기 때문입니다.
② 복잡한 다단계 업무를 더 오래 이어감
이게 Astra에서 가장 중요한 변화 중 하나입니다. 기존 GPT를 사용하다 보면 이런 일이 많습니다.
“CSV 분석해줘.”
→ 데이터 확인
“그중 매출 감소 원인 찾아줘.”
→ 추가 분석
“고객군별로 다시 봐줘.”
→ 추가 코드
“그 결과 보고서 만들어줘.”
→ 보고서 작성
즉 사람이 계속 다음 작업을 지시해야 했습니다.
그런데 Astra는 처음부터
“이 데이터에서 최근 매출 감소 원인을 분석하고 중요한 원인을 찾아서 경영진 보고용 자료까지 만들어줘.”
같은 목표 중심 지시를 처리하는 능력이 크게 강화됐습니다.
OpenAI가 Astra를 설명하면서 계속 강조하는 표현도
complex, multi-step work입니다. (OpenAI Help Center)
데이터 분석으로 바꾸면
데이터 확인 → 문제 정의 → 가설 설정 → 분석 → 추가 분석 → 시각화 → 해석 → 보고서
를 하나의 업무로 맡길 수 있다는 의미입니다.
③ 중간에 요구사항을 바꿀 수 있음
Astra에는 Mid-turn steering이라는 기능이 추가됐습니다. AI가 긴 작업을 수행하고 있는 도중에도 사용자가 새로운 요구사항을 줄 수 있습니다. (OpenAI Developers)
예를 들어 Astra가 분석을 진행하는 중에
“잠깐, 전체 고객보다 신규 고객 중심으로 다시 봐.”
또는 “매출보다는 구매전환율을 중심으로 분석해.”
같이 방향을 바꿀 수 있습니다.
이전에는 작업이 끝난 뒤 새로운 요청을 하는 방식에 가까웠다면,
Astra는 분석 진행 → 사용자 개입 → 분석 방향 수정 → 기존 작업을 이어서 진행이 가능합니다.
실제 분석가와 대화하면서 업무를 수정하는 것과 비슷한 구조입니다.
④ 도구 실행을 기다리는 동안 다른 작업을 할 수 있음
API에는 Async Tool Calling이 새롭게 들어갔습니다.
기존 에이전트는
도구 호출 → 결과 기다림 → 다시 생각 → 다음 작업
순서로 움직이는 경우가 많았는데,
Astra는 어떤 도구가 실행되는 동안 다른 작업을 계속 진행할 수 있습니다. (OpenAI Developers)
예를 들어
웹에서 시장 자료 검색 중 + Python 분석 진행 + 보고서 구조 설계
같은 작업을 병렬적으로 처리할 수 있습니다.
실제 분석 업무에서는 꽤 중요한 개선입니다.
왜냐하면 분석 프로젝트는 하나의 작업만 순차적으로 하는 경우가 별로 없기 때문입니다.
⑤ 긴 데이터를 훨씬 많이 처리할 수 있음
GPT-6 Astra의 컨텍스트 윈도우는 최대 105만 토큰입니다. 최대 출력도 12만8천 토큰까지 지원합니다. (OpenAI Developers) 즉 이전보다 훨씬 많은 내용을 한 작업 안에서 참고할 수 있습니다.
예를 들면
고객 데이터 + 주문 데이터 + 상품 데이터 + 행동 로그 + 기존 보고서 + 회사 정바카라 문서 + 분석 결과
등을 함께 참고하면서 분석할 수 있습니다.
물론 “105만 토큰이니까 CSV 수백만 행을 그대로 넣어도 된다”는 의미는 아닙니다.
대용량 원천 데이터는 여전히 Python·SQL·DuckDB 같은 도구로 처리하고,
Astra가 필요한 결과와 구조를 참고하는 방식이 효율적입니다.
⑥ 문서·스프레드시트·PPT 제작 능력이 하나의 작업으로 통합됨
Astra 발표에서 OpenAI가 별도로 강조한 부분입니다.
예를 들어, Astra는 사용자가 제공한 템플릿과 지침을 따르면서
문서, 스프레드시트, 프레젠테이션을 만들 수 있습니다. (OpenAI Help Center)
중요한 것은 각각을 따로 만드는 것이 아니라 분석 업무와 연결할 수 있다는 점입니다.
예를 들어 “지난달 매출 감소 원인을 분석해.”에서 끝나는 것이 아니라
매출 분석 → 원인 정리 → Excel 분석표 → 그래프 → 경영진 PPT → 보고서
까지 이어질 수 있기 때문에 데이터 분석 실무에서 보면 꽤 큰 변화입니다.
⑦ 연구와 웹 탐색 능력도 강화됨
Astra는 browsing과 research에서도 크게 개선됐습니다. (OpenAI)
이것을 데이터 분석에 적용하면 내부 데이터만 보는 것이 아니라
회사 데이터 + 시장 데이터 + 경쟁사 + 산업 보고서 + 뉴스 + 정부 통계
를 연결할 수 있습니다.
예를 들어
“우리 쇼핑몰의 화장품 매출이 왜 감소했는지 분석해.”
라는 질문을 받았을 때
내부 매출 감소 확인 → 특정 상품군 문제 발견 → 외부 시장 검색 → 산업 성장률 비교 → 경쟁사 프로모션 조사 → 원인 후보 정리 같은 방식이 가능해집니다.
이건 전통적인 데이터 분석보다 리서치 + 데이터 분석에 가깝습니다.
⑧ 코딩 능력도 상당히 강화됨
Astra는 software engineering 영역에서도 이전 모델보다 발전했습니다. OpenAI는 이를 핵심 개선 영역으로 명시하고 있습니다. (OpenAI)
데이터 분석 관점에서는 Python, SQL, R, JavaScript 같은 코드를 단순 생성하는 수준보다,
코드 작성 → 실행 → 오류 확인 → 수정 → 결과 검증을 반복하는 능력이 중요합니다.
그래서 예를 들어 “이 데이터를 분석하는 Python 코드를 만들어줘.”보다
“데이터를 분석해서 가장 중요한 매출 감소 원인을 찾아줘.
필요하면 Python 코드를 작성해서 실행하고 결과를 검증해.”라는 요청에 더 적합한 모델입니다.
⑨ 추론 강도를 작업 중에 바꿀 수 있음
Astra API에서는 reasoning effort를
low medium high xhigh max 단계로 사용할 수 있습니다. (OpenAI Developers)
그리고 Astra부터는 대화 도중에도 추론 강도를 변경할 수 있습니다. (OpenAI Developers)
예를 들어
단순 데이터 정리 → low
기본 집계 → medium
원인 분석 → high
복잡한 인과관계 검토 → xhigh
처럼 운용할 수 있습니다.
비용 측면에서도 중요합니다.
모든 작업을 최고 추론 수준으로 돌릴 필요가 없기 때문입니다.
⑩ 사용자의 의도와 업무 범위를 지키는 능력이 강화됨
OpenAI가 Astra에서 상당히 강조하는 부분이 alignment입니다.
단순히 말을 잘 듣는 수준이 아니라, “어디까지 작업하도록 허용했는가”를 더 잘 판단하도록 개선됐습니다. (OpenAI)
예를 들어 “이 파일을 분석해.”라고 했는데
AI가 임의로 다른 파일을 삭제한다거나, 허가하지 않은 시스템을 수정하는 식의 행동을 줄이려는 것입니다.
특히 Computer Use나 에이전트 기능이 강해질수록 이런 제어가 중요합니다.
그러면 GPT-5.6과 Astra의 차이를 아주 단순하게 비교하면 이렇게 볼 수 있습니다.
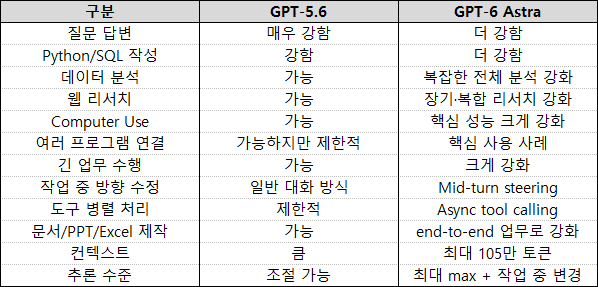 GPT-5.6과 Astra 차이 비교
GPT-4 시대 → “질문하면 답해주는 AI”
GPT-5 시대 → “생각하고 코드를 작성하고 도구를 사용하는 AI”
GPT-6 Astra → “목표를 주면 여러 도구를 이용해서 실제 업무를 끝내는 AI”
이를 데이터 분석 관점으로 바꾸면 더 명확합니다.
예전에는
사람 → 분석 질문 → GPT에게 코드 요청 → 사람이 실행 → 결과 전달 → 다시 질문 → 그래프 생성 → PPT 작성이었다면,
Astra가 지향하는 형태는
사람 → “왜 매출이 감소했는지 분석해서 보고해줘.”
→ Astra가 데이터·코드·웹·Excel·문서·PPT를 오가며 작업
→ 사람은 결과를 검증하고 의사결정
하는 과정으로 변하고 있다는 것입니다.
그래서 데이터 분석가에게 가장 큰 변화는 “Python을 안 배워도 된다”보다
“분석가가 직접 수행하던 중간 작업의 상당 부분을 AI에게 위임할 수 있게 된다”는 쪽에 가깝습니다.
그리고 이 관점에서 보면 늘 얘기했던
“AI 시대 데이터 분석에서 질문이 중요해진다”는 이야기가 Astra 등장으로 훨씬 더 설득력 있어졌습니다.
코드를 얼마나 빨리 작성하느냐보다,
무엇을 확인해야 하는지, 결과가 타당한지,
다음 질문이 무엇인지 판단하는 능력의 비중이 더 커지기 때문입니다.
데이터 분석과 포트폴리오를 함께 공부하고 싶다면?
뜰랩카페 : https://cafe.naver.com/ddlelab
데이터 분석 포트폴리오에 대해 함께 이야기하는 오픈채팅방!
데이터 분석 포트폴리오 클리닉 : https://open.kakao.com/o/gw30Pl1h
포트폴리오를 만들었는데 방향이 맞는지 모르겠거나, 분석 흐름과 스토리 구성에 대한 첨삭이 필요하다면?
포트폴리오 첨삭 문의 : https://open.kakao.com/o/s07mtxai
유튜브 채널 : https://www.youtube.com/@%EB%9C%B0%EB%9E%A9