Claude Fable 5 출시
발 빠르게 설명 들어갑니다.
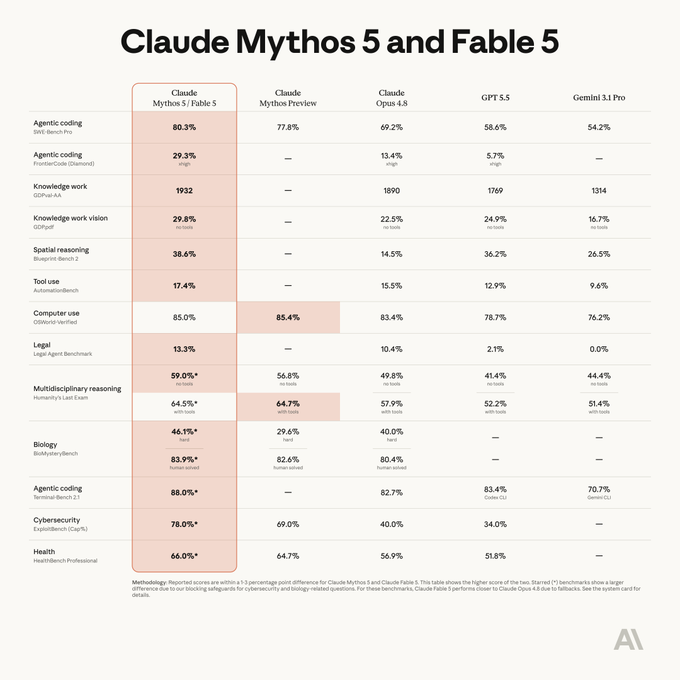
미국시간 6월 9일, 한국 시간 새벽 2시Anthropic이 Claude Fable 5를 공개했다.
지금 사용 중이다.
Anthropic이 금고에 있던 그 모델을 꺼냈다. 능력을 깎지 않고.
대신 검문소라는 것을 세웠다.
무엇이 나왔나?
팩트부터.
Claude Fable 5는 Anthropic이 일반 공개한 첫 Mythos-class 모델이다.
Haiku → Sonnet → Opus로 이어지던 라인업 위에 칸이 하나 더 생겼다. Anthropic은 Mythos-class를 Opus보다 높은 능력 등급으로 설명한다.
핵심은 이 문장이다.
"Fable 5와 Mythos 5는 동일한 기반 모델을 공유한다."
4월에 제한 공개됐던 그 Mythos 계열이다. 주요 OS와 브라우저 전반에서 제로데이 취약점을 찾아내던 모델. AWS, Microsoft, Apple, JPMorgan 같은 Project Glasswing 파트너와 일부 보안 기관만 쓰던 모델.
지난주에는 접근 범위를 15개국의 주요 인프라 기관으로 넓혔다. 그리고 일주일 뒤, 일반 공개 버전이 나왔다.
API와 소비량 기반 Enterprise 플랜에서는 바로 쓸 수 있다. Pro, Max, Team, 좌석 기반 Enterprise 플랜에서도 6월 22일까지는 추가 비용 없이 포함된다. 6월 23일부터는 사용량 크레딧이 필요하고, 용량이 충분해지면 다시 구독 플랜의 기본 모델로 넣겠다는 계획이다.
Anthropic 스스로의 표현으로, Fable 5는 지금까지 일반 공개한 모델 중 가장 강하다. 소프트웨어 엔지니어링, 지식 업무, 비전, 과학 연구에서 강하고, 작업이 길고 복잡할수록 기존 모델과의 격차가 커진다고 했다.
검문소의 구조
그럼 위험은 어떻게 막았나.
여기가 이번 출시의 진짜 내용이다.
이전 방식(Opus 4.7)은 훈련 단계에서 사이버 능력을 깎았다. 모델 자체를 손댔다.
Fable 5는 모델을 손대지 않았다. 대신 질의를 검사한다.
사이버보안, 생물학, 화학, 모델 증류(distillation) 같은 고위험 영역 질문이 들어오면 Fable 5가 직접 답하지 않는다. 차순위 모델인 Claude Opus 4.8이 대신 답한다.
사용자는 같은 창에서 대화한다. 답변 주체가 조용히 바뀐다.
공식 수치로, 이 안전장치는 전체 세션의 5% 미만에서 작동한다. 95% 이상은 Fable 5가 직접 답한다. Anthropic은 보수적으로 튜닝했기 때문에 무해한 질문도 가끔 걸릴 수 있다고 고지했다.
두 시점을 나란히 놓으면 전환이 보인다.
2026.04 — Opus 4.7: 능력 제거. 모델에서 위험 경로를 깎아냄.
2026.06 — Fable 5: 능력 보존. 위험 질의만 우회시킴.
두 달 만에 방식이 바뀌었다.
모델을 손대는 것에서, 모델 앞에 라우터를 세우는 것으로.
수치
성능 격차는 숫자로 확인된다.
Anthropic 공식 공지와 초기 고객 피드백 기준으로 정리하면 이렇다.
Hex 장기 분석 태스크 벤치마크 최초 90% 돌파. Opus 대비 +10포인트.
프런티어 물리 연구에서 최고 성능을 보였고, 추론 토큰은 3분의 1만 사용. GPT-5.5가 4일 걸린 지점에 36시간 만에 근접.
스프레드시트 작업에서 Opus 4.8을 모든 effort level에서 이기고, 25~30% 빠르게 완료.
복잡한 코드베이스 마이그레이션, 장기 에이전트 코딩, 비전 기반 앱 재구성에서 강점.
공식 표현: 작업이 길고 복잡할수록 격차가 커진다.
가격도 공식화됐다.
Fable 5와 Mythos 5는 입력 100만 토큰당 10달러, 출력 100만 토큰당 50달러다. Opus 4.8의 약 2배다. 대신 4월 Mythos Preview 가격의 절반 이하다.
비싸다.
하지만 가격표만 보면 핵심을 놓친다.
Anthropic이 팔려는 것은 더 많은 토큰이 아니다. 더 긴 작업을 끝내는 능력이다. 토큰 단가는 오르지만, 며칠 걸릴 작업이 몇 시간으로 줄면 작업 단가는 내려갈 수 있다.
이제 AI 비용은 "토큰당 얼마인가"가 아니라 "작업 하나를 끝내는 데 얼마인가"로 봐야 한다.
1953년에 같은 전환이 있었다
1945년 맨해튼 프로젝트의 구획화를 썼다.
13만 명이 일했지만 전체를 아는 건 소수였다. Mythos는 잠그고 Opus 4.7만 공개한 구조가 그랬다.
그 다음 단계도 역사에 있다.
1953년 12월, 아이젠하워가 UN에서 "Atoms for Peace"를 연설했다. 무기급 기술은 계속 잠그되, 같은 핵 기술을 민간에 배포하겠다는 선언이었다.
조건이 하나 붙었다.
사찰 체제.
1957년 IAEA가 그래서 생겼다.
기술에서 능력을 빼는 게 아니다.
사용을 감시하는 체제를 붙여서 배포한다.
Fable 5가 정확히 이 구조다.
Mythos-class 능력은 그대로. 위에 검문소를 얹어서 공개.
그리고 역사는 이 모델의 한계도 같이 기록했다.
1974년, 인도가 첫 핵실험을 했다. 평화 목적으로 지원받은 연구용 원자로에서 추출한 플루토늄이었다. 사찰 체제는 완벽하지 않았다.
검문소 모델의 약점은 검문소 자체다.
모델이 강할수록, 우회 시도의 가치도 같이 커진다.
Anthropic도 이걸 안다. 그래서 Fable 5와 Mythos 5, 그리고 앞으로 나올 비슷한 수준의 모델에는 30일 데이터 보관 정바카라을 적용한다. 학습에는 쓰지 않지만, 안전 목적의 공격 탐지와 오탐 개선을 위해 트래픽을 보관하겠다는 것이다.
강한 모델의 공개는 더 많은 감시 구조를 동반한다.
이건 기술의 문제가 아니라 운영 체제의 문제다.
그래서 뭘 해야 하는가
AI 메이커 관점으로 내려오면 세 가지다.
첫째, Anthropic이 '파이프 > 모델'을 스스로 증명했다.
Fable 5는 단일 모델이 아니다.
라우터 + Fable 5 + Opus 4.8의 묶음이다.
프론티어 랩이 모델이 아니라 라우팅 시스템을 팔기 시작했다.
나는 로컬 LLM과 Claude API를 비용 기준으로 가르는 라우팅을 짜왔다. Anthropic은 같은 구조를 위험 기준으로 짰다. 기준만 다르고 패턴은 같다.
모델 단일 호출의 시대가 공급자 단에서부터 끝나고 있다.
둘째, 비용 라우팅 기준을 다시 짜야 한다.
가격이 Opus의 2배라면 모든 작업에 Fable을 쓰는 건 낭비다.
공식 공지가 기준을 줬다.
길고 복잡한 작업일수록 격차가 커진다.
뒤집으면, 짧고 단순한 작업은 격차가 작다.
장기 에이전트 워크플로우, 멀티파일 코드 분석, 복잡한 리서치, 최종 검증은 Fable 5.
단발 질의, 일반 코딩, 초안 생성, 단순 요약은 Opus 4.8 이하로 충분하다.
셋째, 5%의 변수를 설계에 넣어야 한다.
프로덕션 파이프라인에서 같은 호출인데 응답 주체가 바뀔 수 있다는 뜻이다. 대략 20번에 1번꼴이다.
일관성이 중요한 자동화라면 어떤 질의가 폴백을 타는지 모니터링부터 붙여야 한다. 모델명을 로깅하고, 폴백률을 기록하고, 특정 도메인에서 갑자기 품질이 떨어지는지 봐야 한다.
앞으로의 AI 시스템은 프롬프트만 잘 쓰면 안 된다.
어떤 모델이 언제 호출됐는지까지 추적해야 한다.
"가장 강한 모델을 누가 쓸 수 있는가"에서,
"가장 강한 모델이 어떤 질문에 답하는가"로.
모델 접근권의 시대가 끝나고, 질의 접근권의 시대가 시작됐다.
다음 프론티어 모델부터, 이 배포 방식이 표준이 된다.
소스
Anthropic 공식 공지, "Claude Fable 5 and Claude Mythos 5", 2026.06.09
https://www.anthropic.com/news/claude-fable-5-mythos-5
Anthropic, "Project Glasswing: Securing critical software for the AI era"
https://www.anthropic.com/glasswing
The Verge, "Anthropic releases its first Mythos-class model Claude Fable", 2026.06.09
https://www.theverge.com/news/946725/anthropic-releases-claude-fable-5-mythos
Axios, "Anthropic releases Mythos-level model for general use", 2026.06.09
https://www.axios.com/2026/06/09/anthropic-mythos-class-safeguards