HBM 다음의 전쟁
삼성전자의 zHBM vs SK하이닉스의 HBF
AI 데이터센터에는 수많은 연산을 동시에 처리하는 GPU와 NPU 같은 AI 가속기가 필요하다. 하지만 가속기의 계산 속도만 빨라져서는 전체 성능이 높아지지 않는다. 필요한 데이터를 제때 공급하지 못하면 비싼 가속기도 기다려야 한다. 이른바 메모리 병목이다. HBM은 이 병목을 줄이기 위한 고대역폭 메모리다. 여러 개의 D램을 아파트처럼 수직으로 쌓고 층 사이에 수천 개의 데이터 통로를 만든다. 이렇게 만든 HBM을 가속기 가까이에 배치하면 많은 데이터를 빠르게 공급할 수 있다. 그런데, AI 모델의 파라미터가(AI의 작동 방식을 결정하는 수많은 조정값) 커질수록 필요한 메모리도 늘어난다. 또한, AI 에이전트가 긴 대화를 기억하고 여러 도구와 데이터를 호출하려면 임시로 저장할 정보도 많아진다. 그래서 HBM은 8단에서 12단으로 높아졌고 HBM4 표준은 최대 16단 구성까지 지원하고 20단 이상을 향해 가고 있다. 하지만 계속 높이 쌓는 데는 한계가 있다. 적층 단수가 늘면 열이 빠져나가기 어려워진다. 칩이 휘거나 접합 불량이 생길 가능성도 커진다. 수율이 낮아지면 가격과 공급 안정성도 나빠진다. 이제 메모리 경쟁은 얼마나 높이 쌓느냐에서 끝나지 않는다. 메모리를 어디에 놓을지와 데이터를 어떻게 이동시킬지까지 바뀌고 있다.
8월 4일부터 미국 산타클라라에서 열린 FMS(Future of Memory and Storage) 2026에서 이런 변화가 선명하게 드러났다. 삼성전자는 차세대 3D 메모리 아키텍처인 zHBM의 목업을 처음 공개했다. 현재 HBM은 GPU와 같은 AI 가속기 옆에 놓인다. zHBM은 HBM을 가속기 바로 위에 쌓는다. 데이터 이동 거리를 더 줄여 성능과 전력 효율을 높이려는 구상이다. 메모리와 가속기 사이에는 고객이 원하는 기능을 넣을 수 있는 인터레이어도 배치한다. 삼성전자는 zHBM용 차세대 인터페이스가 HBM5보다 최대 8배 높은 성능과 최대 3배 높은 전력 효율을 구현하는 것을 목표로 한다고 밝혔다. 같은 행사에서는 SK하이닉스와 샌디스크가 HBF의 첫 공개 기술 규격을 발표했다. HBF(High Bandwidth Flash)는 낸드플래시를 HBM처럼 수직으로 쌓아 HBM과 SSD 사이에 새로운 메모리 계층을 만드는 기술이다. HBM은 빠르지만 비싸고 전원이 꺼지면 데이터가 사라진다. SSD에 사용되는 낸드플래시는 상대적으로 느리지만 데이터를 계속 보관할 수 있다. 비트당 가격도 낮다. HBF는 낸드의 용량과 가격 경쟁력을 유지하면서 데이터 처리 속도를 끌어올리는 데 목적이 있다. 대규모 AI 모델의 가중치와 추론 데이터를 연산장치 가까이에 저장하는 데 적합하다. HBF는 HBM을 없애는 기술이 아니다. HBM과 SSD 사이의 속도와 용량 차이를 메우는 보완재다. 시스템 소프트웨어가 가장 자주 사용하는 데이터는 HBM에 두고 상대적으로 덜 급하지만 용량이 큰 데이터는 HBF에 배치할 수 있다.
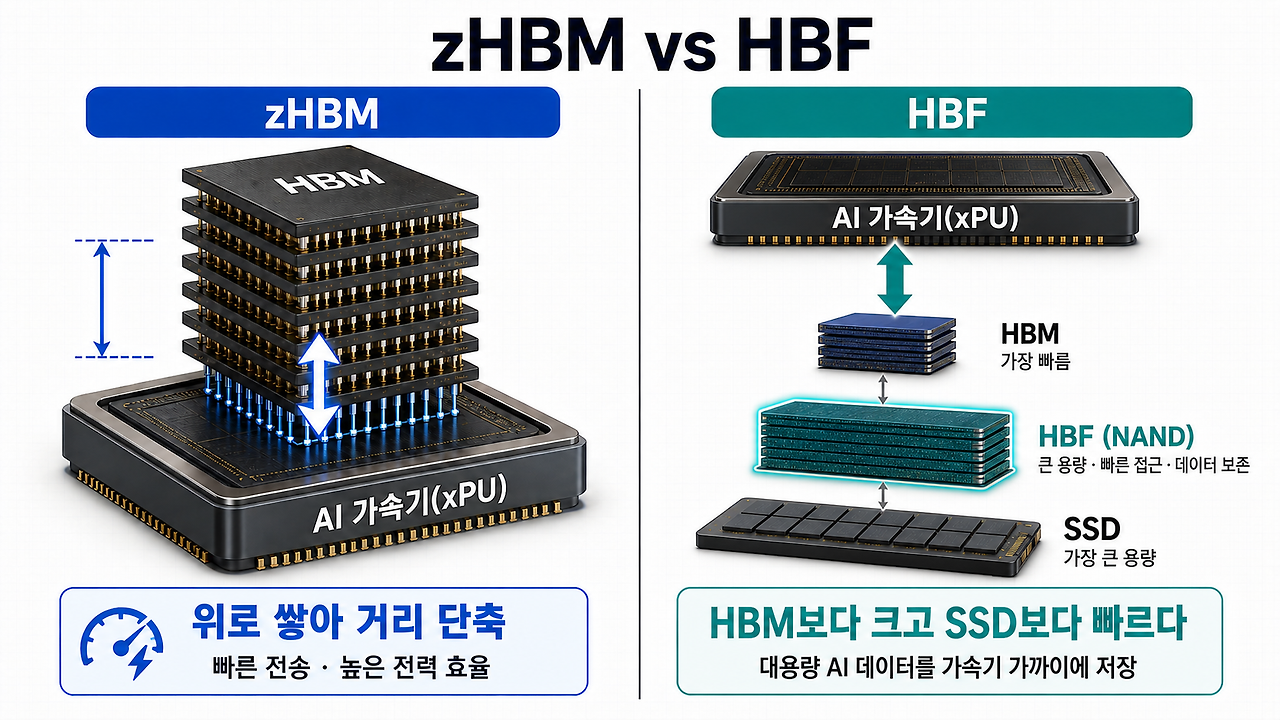 출처 : ChatGPT를 이용해 두 기술의 차이를 정리해서 도식화함
8월 23일부터 스탠퍼드대에서 열린 핫칩스 2026에서도 차세대 메모리 기술이 이어졌다. SK하이닉스는 iHBM을, 삼성전자는 PIM을 상세히 발표했다. 삼성전자의 LPDDR5X-PIM은 저전력 D램인 LPDDR5X에 연산 기능을 넣은 제품이다. 기존 AI 추론에서는 가중치와 중간 데이터를 메모리에서 NPU로 계속 옮겨야 한다. 연산을 마치면 결과를 다시 메모리에 저장한다. 이 왕복 과정에서 시간이 지연되고 전력도 소모된다.
LPDDR5X-PIM은 행렬과 벡터의 곱셈처럼 AI 추론에 반복되는 연산 일부를 메모리 뱅크 안에서 처리한다. 물론 NPU를 대체하는 것은 아니고 NPU와 메모리 사이를 오가는 데이터의 양을 줄여 전체 시스템의 성능과 전력 효율을 높인다. 스마트폰과 태블릿 및 AI PC처럼 전력과 발열의 제약이 큰 온디바이스 AI에서 특히 유용하다. 반면 SK하이닉스의 iHBM은 HBM의 발열을 낮추는 패키징 기술로HBM의 속도와 적층 단수가 높아지면 전력밀도가 커진다. 특히 HBM 베이스 다이와 AI 가속기가 통신하는 D2D PHY 구간에 열이 집중된다. iHBM은 이 영역에 일체형 냉각 요소인 ICE를 넣는다. ICE는 전기는 통하지 않지만 열은 잘 전달하는 실리콘 기반 소재로 열이 빠져나갈 별도의 통로를 만드는 방식이다. SK하이닉스는 이를 통해 기존 구조보다 열저항을 30% 이상 낮췄다고 밝혔다.
이들 기술이 해결하려는 문제는 서로 다르다. zHBM은 가속기와 메모리 사이의 거리를 줄이고 HBF는 낮은 비용으로 메모리 계층의 용량을 넓힌다. PIM은 데이터 이동 자체를 줄이며 iHBM은 고성능화 과정에서 발생하는 열을 낮춘다. 서로를 대체하는 기술이라기보다 AI 시스템의 서로 다른 병목을 해결하는 기술이다. 그렇기에 앞으로의 경쟁은 단일 제품의 성능 대결에 그치지 않는다. D램과 낸드 및 HBM을 첨단 패키징과 냉각 기술로 연결해야 한다. 메모리 제어 소프트웨어도 함께 최적화해야 한다. 결국 고객이 원하는 것은 가장 빠른 메모리 칩이 아니다. 같은 수의 가속기로 더 많은 AI 요청을 처리하고 전기료와 냉각비를 줄이는 시스템이다.
한국 메모리 산업의 역사는 1등이 타고나는 자리가 아니라는 사실을 보여준다. 삼성전자는 1983년 64Kb D램을 개발하며 메모리 사업에 뛰어들었다. 당시 세계 시장은 일본 기업들이 주도하고 있었다. 그러나 D램의 수요처가 메인프레임에서 PC로 이동하면서 시장의 선택 기준도 바뀌었다. 높은 신뢰성뿐 아니라 표준화된 제품의 가격과 공급 능력이 중요해졌다. 삼성전자는 이 변화를 읽고 불황에도 차세대 제품과 생산설비에 투자했다. 한 연구에 따르면 1987년부터 1992년까지 삼성 반도체 부문의 매출 대비 설비투자 비율은 39.8%였다. 업계 평균 20.5%의 두 배에 가까웠다. 그 결과 1992년 세계 최초 64Mb D램을 개발하고 D램 시장 1위에 올랐다. 1993년에는 전체 메모리 시장에서도 1위를 차지했다. 일본 업체들을 제친 힘은 한 번의 발명에 있지 않았다. 차세대 제품을 먼저 개발하고 높은 수율로 양산해 고객이 원하는 시점에 공급하는 능력이었다.
이후에도 경쟁 방식은 같았다. PC 시대에는 SDRAM과 DDR로 속도를 높였다. 스마트폰 시대에는 LPDDR로 성능과 배터리 사용시간을 함께 개선했다. 낸드에서는 2013년 셀을 수직으로 쌓는 V낸드를 세계 최초로 양산했다. 시장이 PC에서 모바일로 이동하고 다시 데이터센터로 바뀔 때마다 고객이 요구하는 메모리의 역할을 먼저 정의했다. SK하이닉스의 HBM도 장기 투자의 결과다. 회사는 생성형 AI가 등장하기 전인 2009년부터 TSV와 HBM을 연구했다. 2013년 세계 최초의 TSV 기반 HBM을 개발했지만 당시 시장은 충분히 크지 않았다. 그래도 투자를 중단하지 않았다. 2021년 HBM3를 세계 최초로 개발하고 2022년 양산해 엔비디아에 공급했다. 이후 HBM3E와 12단 적층 기술 및 MR-MUF 패키징을 고도화했다. 시장이 열리기까지 10년 가까이 기다린 투자가 오늘의 HBM 경쟁력이 된 것이다.
그렇다고 안심할 수는 없다. 2026년 2분기 D램에서 SK하이닉스와 마이크론의 점유율 차이는 1%포인트에 불과하다. 중국 업체들도 빠른 속도로 생산능력을 늘리고 있다. 현재의 시장점유율은 과거 투자의 결과이지 미래의 1등을 보장하는 보증수표가 아니다. 더욱이 HBM은 만들어 놓고 고객을 기다리는 범용 부품이 아니다. 가속기의 설계 단계부터 고객과 규격을 맞춰야 한다. 장기간의 품질 검증도 통과해야 한다. 여러 칩을 쌓아도 휘지 않아야 하며 발열과 전력 소모를 제어해야 한다. 높은 수율로 약속한 물량을 제때 공급하는 능력도 필요하다. 고객 만족은 벤치마크 점수 하나가 아니라 가속기 가동률과 전력비 및 안정적인 공급으로 결정된다.
한국 기업이 지켜야 할 것은 한 세대 앞선 칩이라는 명성이 아니다. 고객이 계속 선택할 수밖에 없는 성능과 품질 및 공급 능력이다. 이를 위해 첨단 패키징과 냉각 및 인터페이스와 소프트웨어에 대한 투자를 이어가야 한다. 메모리의 1등은 가장 큰 공장을 가진 기업이 아니라 고객이 만날 다음 병목을 가장 먼저 푸는 기업의 몫이다.
2027년 사업 전략, AX 로드맵 수립을 위한 필독서!
https://www.yes24.com/product/goods/197780287