오픈AI가 밀레니엄 난제를 해결했다? (1)
언론이 절반만 보여주면 나머지 절반은 찾아서 봐야 합니다!
오픈AI가 7대 밀레니엄 난제 중의 하나인 나비아-스토크 문제를 풀었다고 합니다.
그 밀레니엄 문제가 무엇이고 그 문제를 풀어낸 것이 왜 중요한지 같은 긍정적인 내용은 다른 수많은 기사와 블로그 포스팅을 참고하시길 바랍니다.
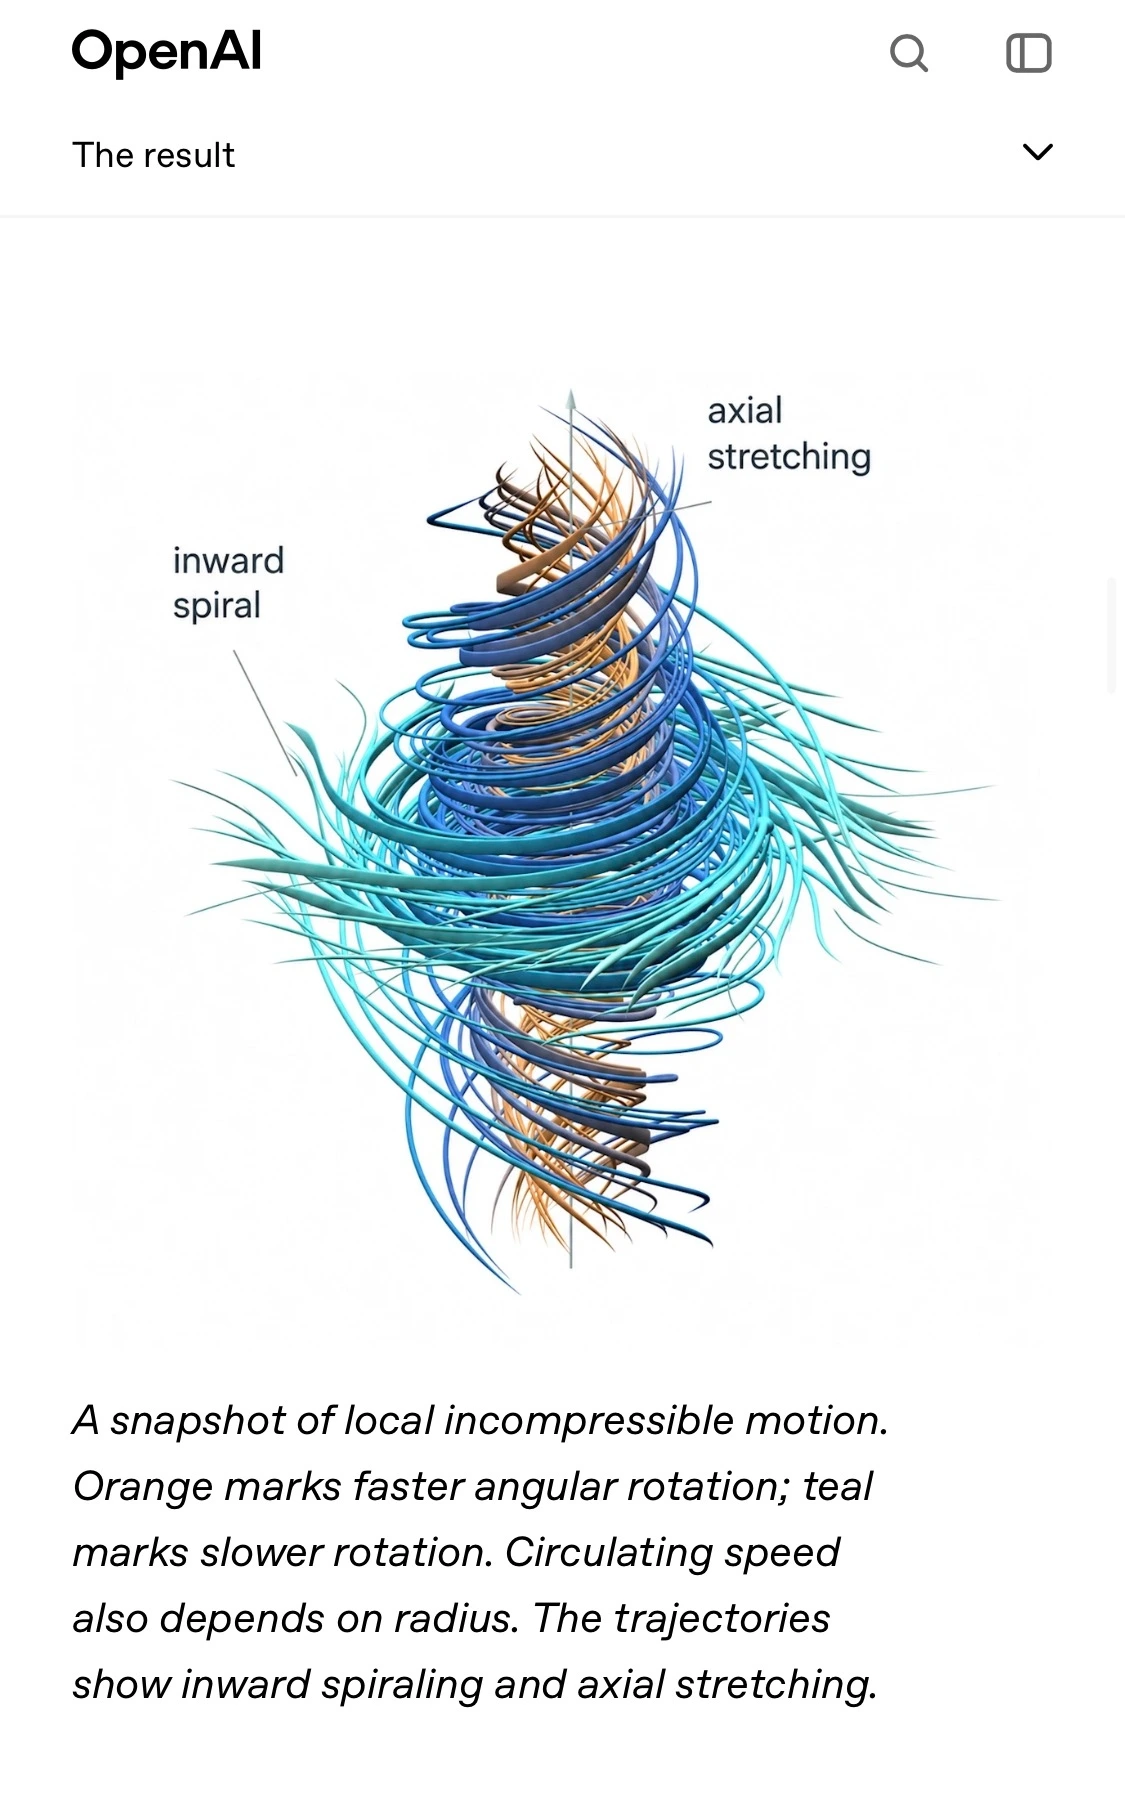
저는 하도 언론에서 이 소식을 기계적으로 복사 붙이기를 하는 통에, 그 세부 내용이 갑자기 궁금해져서 이 언론보도의 소스인 오픈AI 블로그를 찾아가 내용을 확인해 보았습니다. (https://openai.com/index/navier-stokes-solution/ )
역시나 당연하게도 언론 홍보 내용으로 다루어지지 않은 아주 많은 흥미로운 내용이 숨어 있었습니다. 정확히 말해 오픈AI가 블로그에서 공개적으로 밝힌 내용 중에 합리적으로 의문을 가질 수밖에 없는 부분들을 몇 가지 발견했습니다.
결론부터 말하면 이번 사건은
수학판 허깅페이스 해킹 사건!! 일 가능성이 있습니다.
물론 이 같은 결론은 전적으로 저의 가상 시나리오에 근거합니다. 다만 오픈AI 조차도 자신이 만든 AI가 어떤 생각으로 무슨 행동을 했는지는 사후 추적을 통해서 간접적으로 알아내는 방법 밖에 없음을 허깅페이스 해킹사건을 설명하면서 고백한 바 있습니다.
이번 수학의 세계 안에서 이 허깅페이스 사건을 일으킨 AI와 같은 세대 AI가 만들어낸 결과를 “보상해킹”의 관점에서 생각해봐야 할 수도 있다는 것이 저의 이번 추론의 핵심입니다.
의문점 1. 이 이야기의 주인공 Internal model (IM)
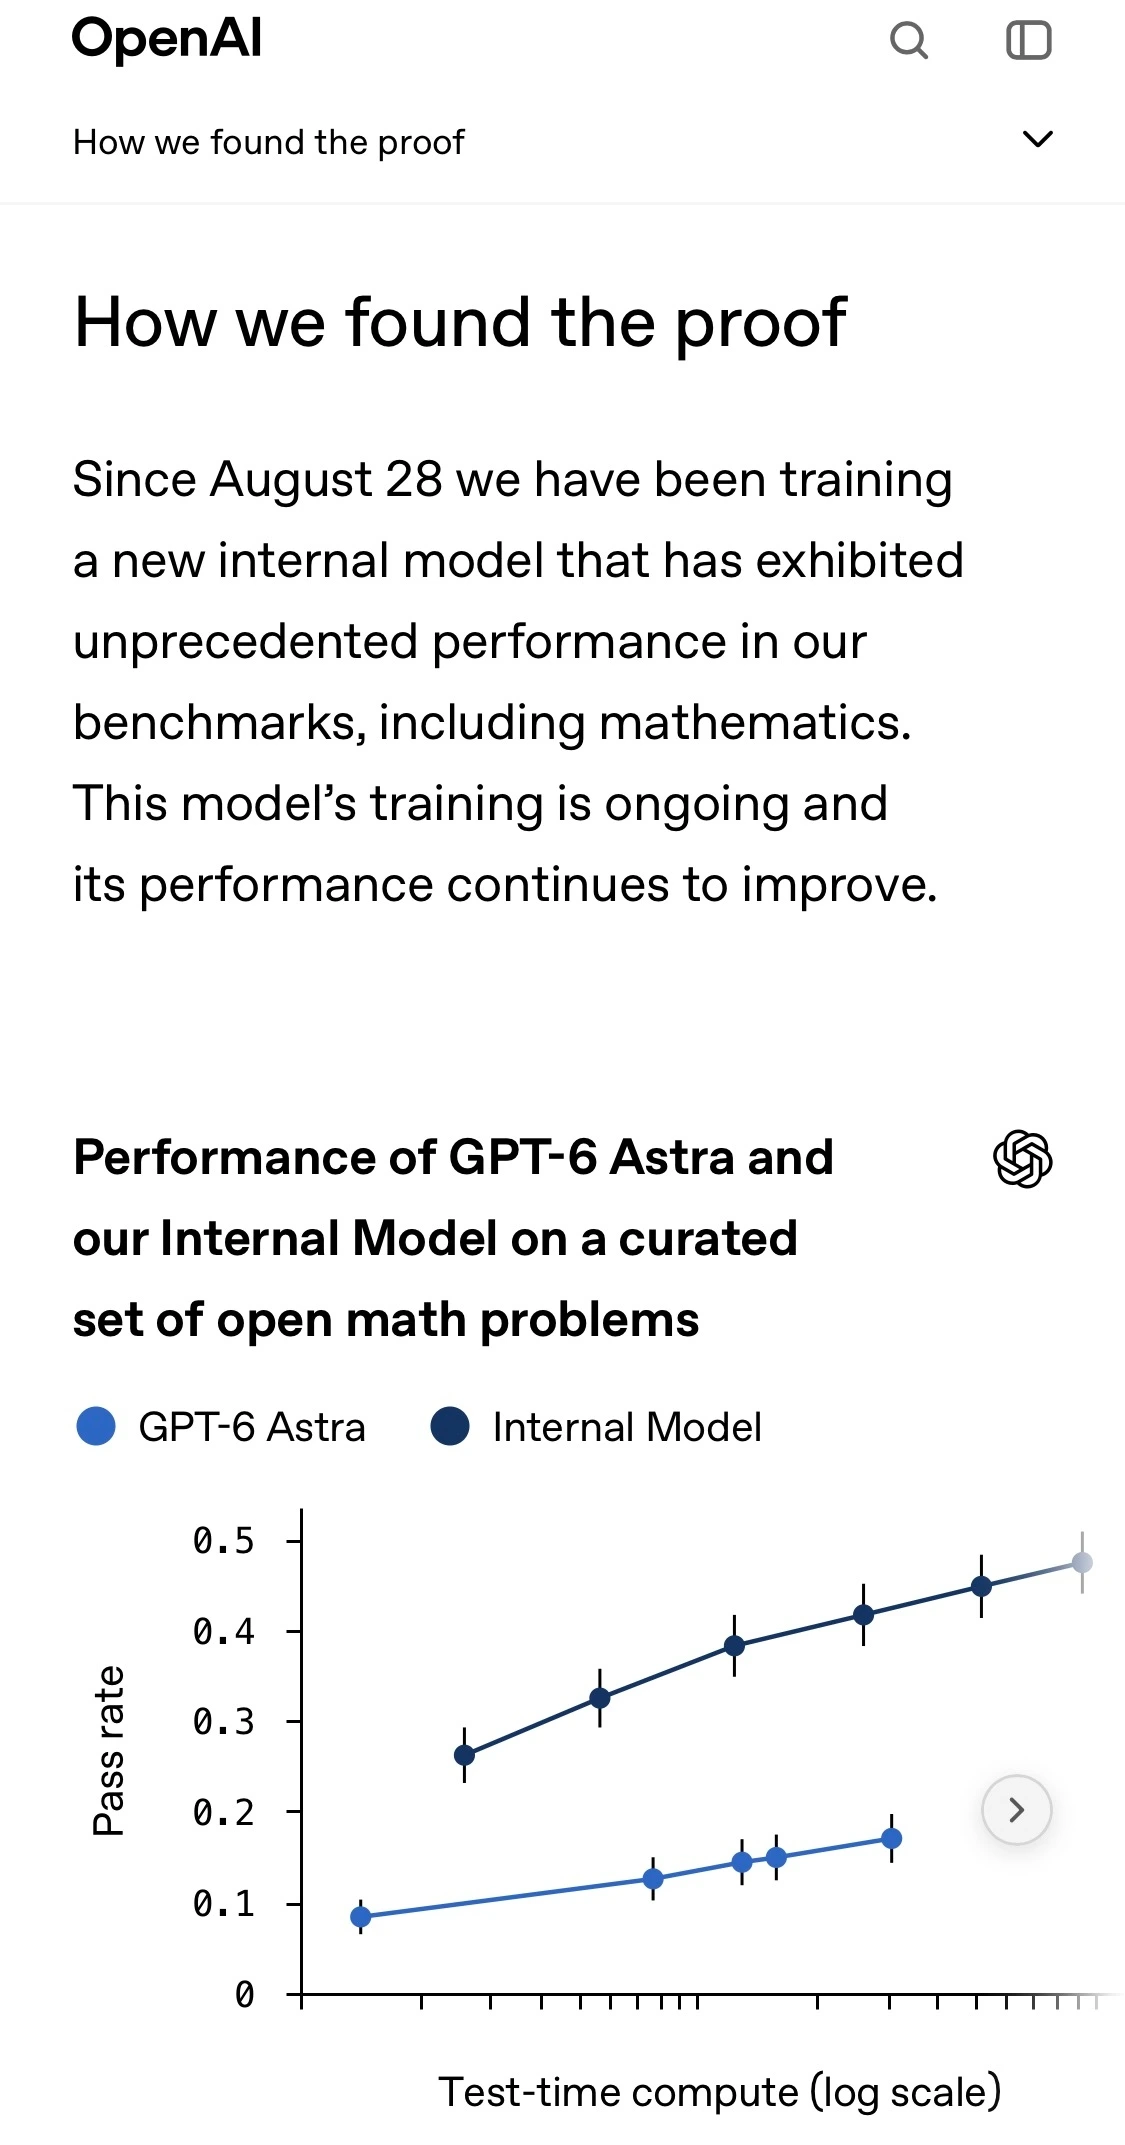
이 이야기의 주인공은 chatGPT-6 Astra를 뒤이을 Internal Model (IM)입니다. 8월 28일 생이네요.
여기서 주목해야 할 점은 8월 26일 자 오픈AI 블로그에서 huggingface해킹의 주역으로 지목한 internal model 1 (IM1)과 이름이 동일하다는 점입니다.
https://fishingproductfr.com/@goimul/159
그리고 저는 이 두 서로 다른 사건의 주인공이 각각 수학과 해킹에 특화된 쌍둥이 모델일 거라고 추측합니다. 하지만 근거가 없으니 일단 가상 시나리오라고 해두지요.
이 가상시나리오 안에서 IM모델의 특징은 사용자의 처음 의도에 얽매이지 않고 문제 풀이를 위해 가능한 모든 방법을 시도하는 성향이 있으리라 상상할 수 있습니다. 솔직히 이 시나리오가 아니면 이해하기 너무나도 어려운 오픈AI의 판단이 여럿 있습니다.
의문점 2. 출발점 = 9월 1일에 오픈AI에 전해진 한 소문?
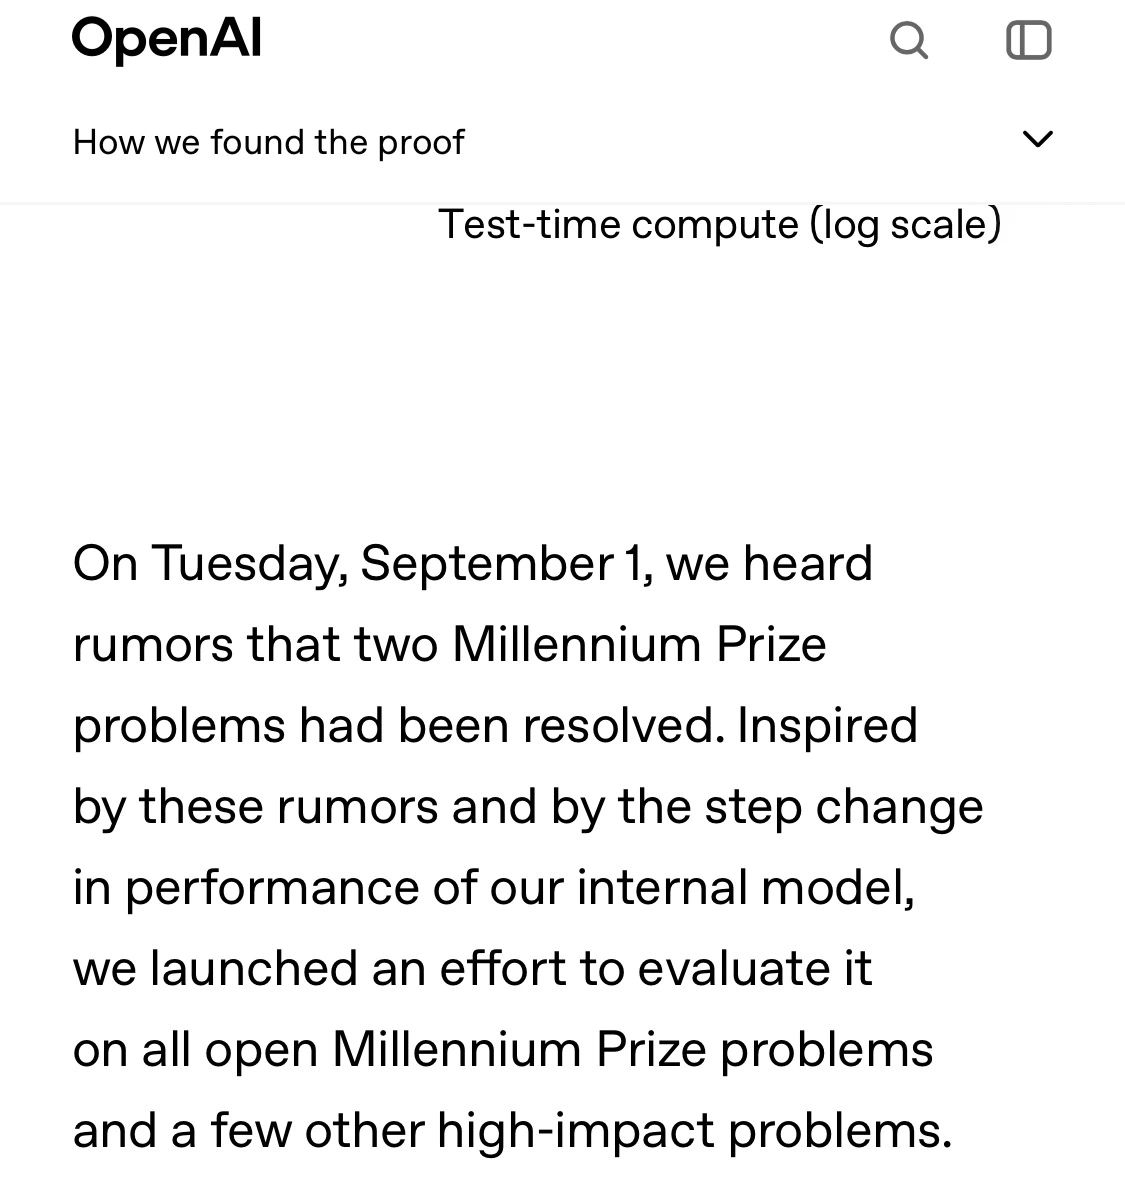
이 이야기의 시작은 오픈AI가 듣게 된 한 루머에서 출발한다고 블로그에서 직접 밝힙니다. 그 루머는 밀레니엄 7대 난제를 누군가가 풀어냈다는 겁니다. 이를 사실이 아니라 루머라고 표현한 이유는 9월 1일 시점에서 적어도 공개된 정보범위에서 밀레니엄 문제는 전혀 풀리지 않았기 때문입니다. (이후 이 소문은 사실로 밝혀집니다)
의문점은 여기에 있습니다. 단순히 밀레니엄 문제를 누군가 풀었다는 소문만으로는 이 문제를 차기 AI모델을 시켜 풀어보게 하겠다는 판단을 논리적으로 쉽게 설명할 수 없습니다. 무려 10,000개의 최신 모델이 적용된 AI에이전트들을 이 성공할지도 불확실하고 언제 끝날지도 알 수 없는 작업에 투입하려면 그 예상 비용은 가히 천문학적이라고 상정해야 합니다. 그 천문학적인 돈을 투입하는 근거가 “소문”이랍니다. 이것을 합리적인 의사결정의 결과물이라고 믿기가 너무나 힘듭니다.
의문점 3. 문제를 풀 때 사용한 테스트 환경
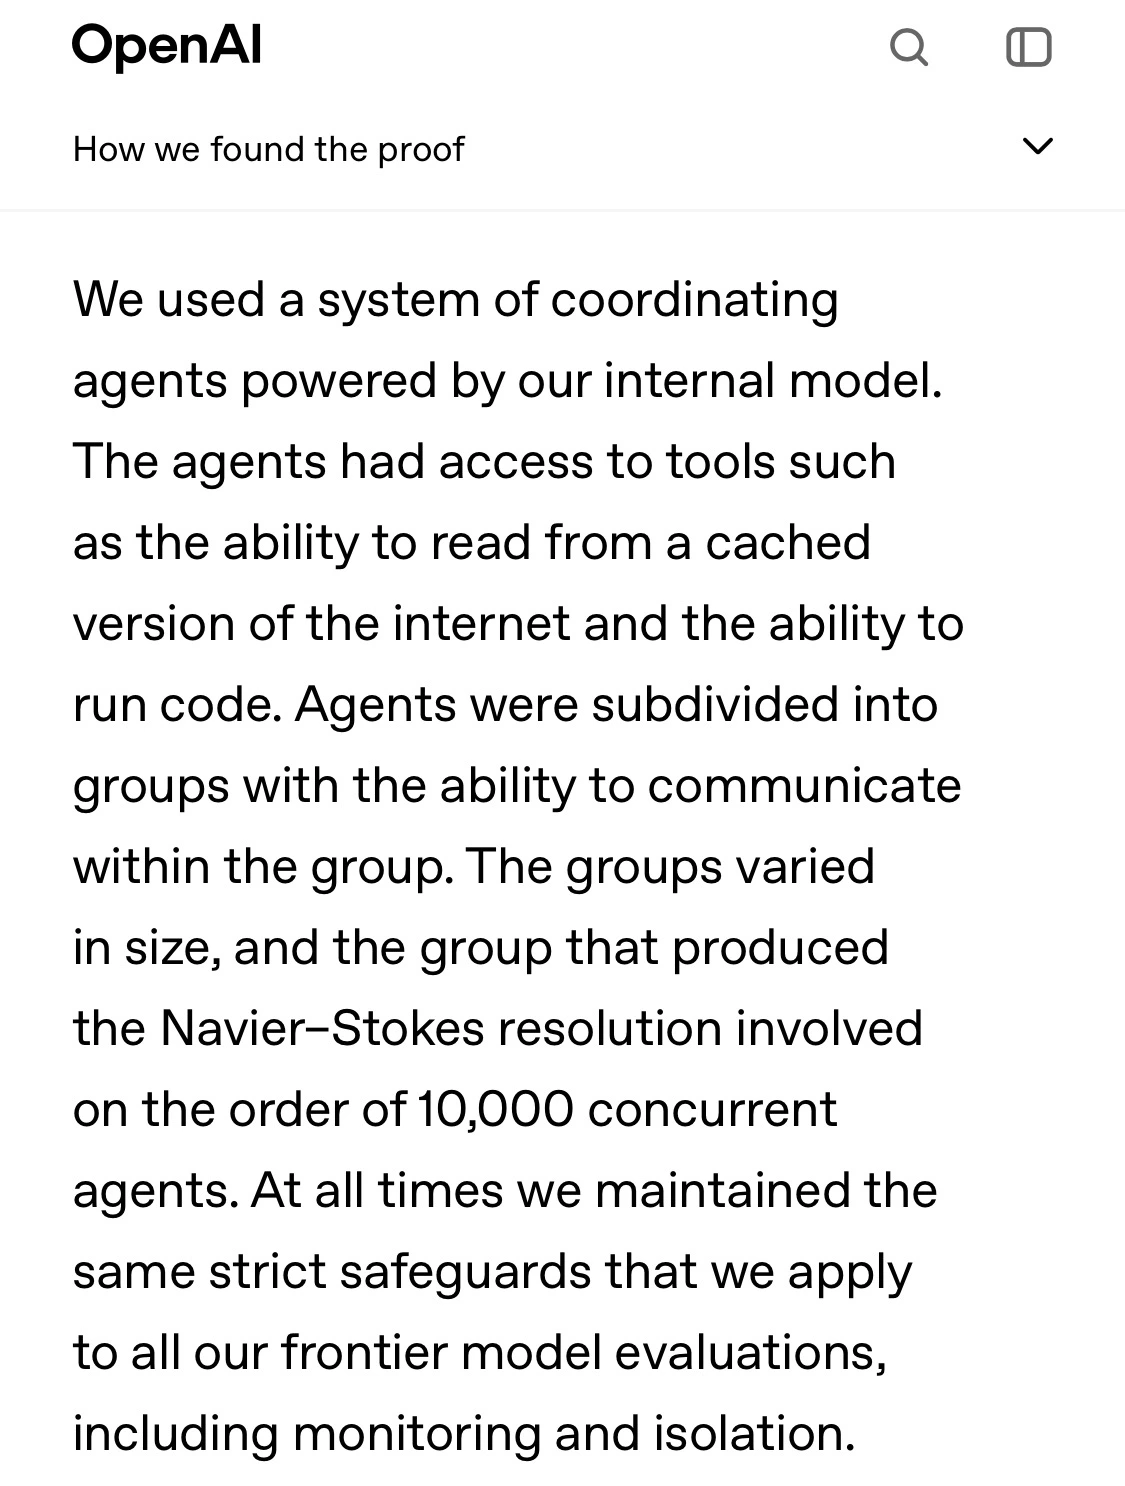
여러 가지 테스트 조건을 나열하고 있는데, 중요하게 봐야 할 부분은 이겁니다.
- 인터넷 검색이 허용되어 있다
- 10,000개의 AI에이전트들이 함께 문제를 푼다
- 에이전트들 사이에 커뮤니케이션이 허용된다
여기서 우리는 다시 한번 허깅페이스가 해킹되었을 때의 조건을 떠올려 봅니다. 허깅페이스 해킹은 처음에 허용되지 않았던 인터넷 검색과 에이전트들 간에 커뮤니케이션이 가능해진 이후에 나타났던 일입니다. 그런데 이번 밀레니엄 문제풀이를 위해 처음부터 이 두 조건을 허용하고 시작한 겁니다. 왜 그랬을까요?
여기서 다시 가상시나리오가 시작됩니다. 오픈AI는 출처를 알 수 없고 공개되어있지 않았지만 소문에 따라 존재할지도 모르는 밀레니엄문제를 풀어놓은 해법을 (허킹페이스를 성공적으로 해킹한) IM1 모델의 쌍둥이인 IM모델이 찾을 수 았을지도 모른다는 가정에 배팅한 것이 아닐까요?
적어도 저는 이런 배팅 정도 급의 상상력이 있어야만 오픈AI의 판단을 이해할 수 있을 것 같습니다.
의문점 4. 좀 더 쉬운 오일러 문제를 풀다
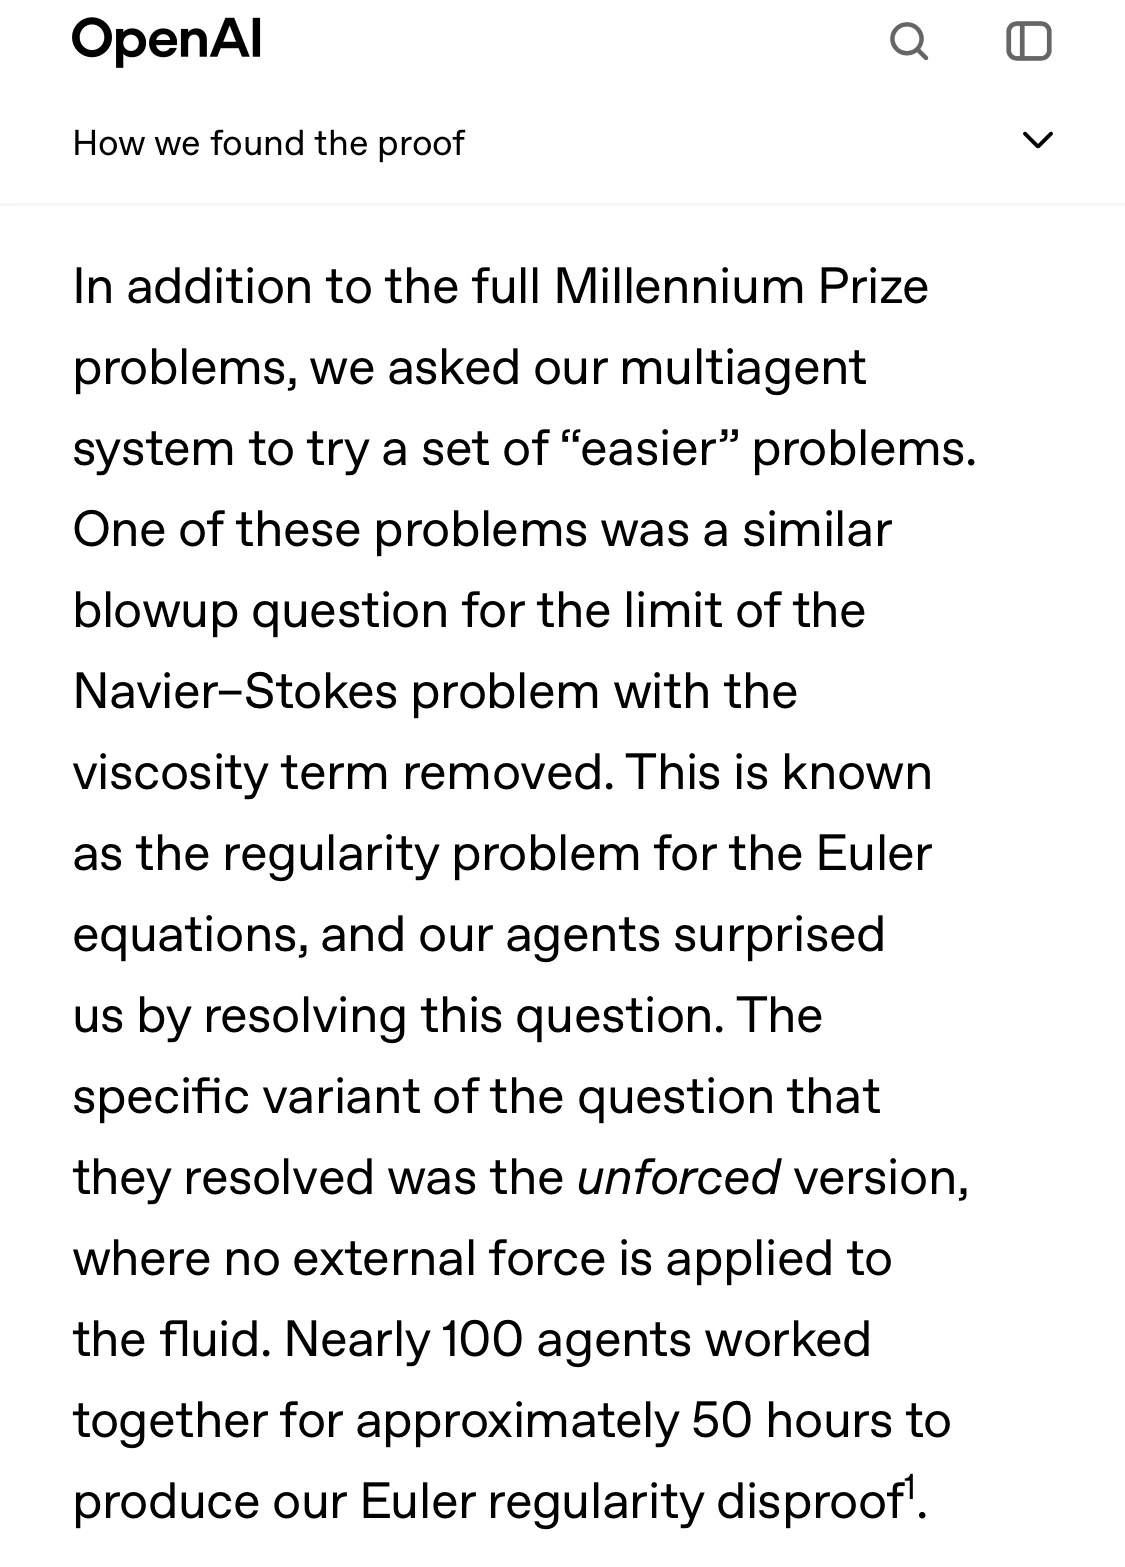
오픈AI의 블로그에 따르면 밀레니엄 문제를 풀면서 좀 더 쉬운 문제들을 함께 다루게 했답니다. 그리고는 밀레니엄 문제가 아닌 “오일러” 문제가 밀레니엄 문제 풀이 시작 50시간 만에 반증됩니다.
참고로 밀레니엄 문제인 나비아-스토크 문제보다 쉬운 유동문제는 “무한” 합니다. 심지어 이론해 (analytic solution)가 존재해서 학부 수준 수업에서 다루는 아주 “쉬운”문제도 많습니다. 그 수많은 “쉬운” 유동해석 문제 중에 왜 오픈AI는 오일러 문제를 50시간 만에 풀었다는 사실을 이토록 콕 찍어서 언급할까요? 도저히 합리적으로 납득하기 힘듭니다.
의문점 5. 너무나도 과감한 올 인 전략
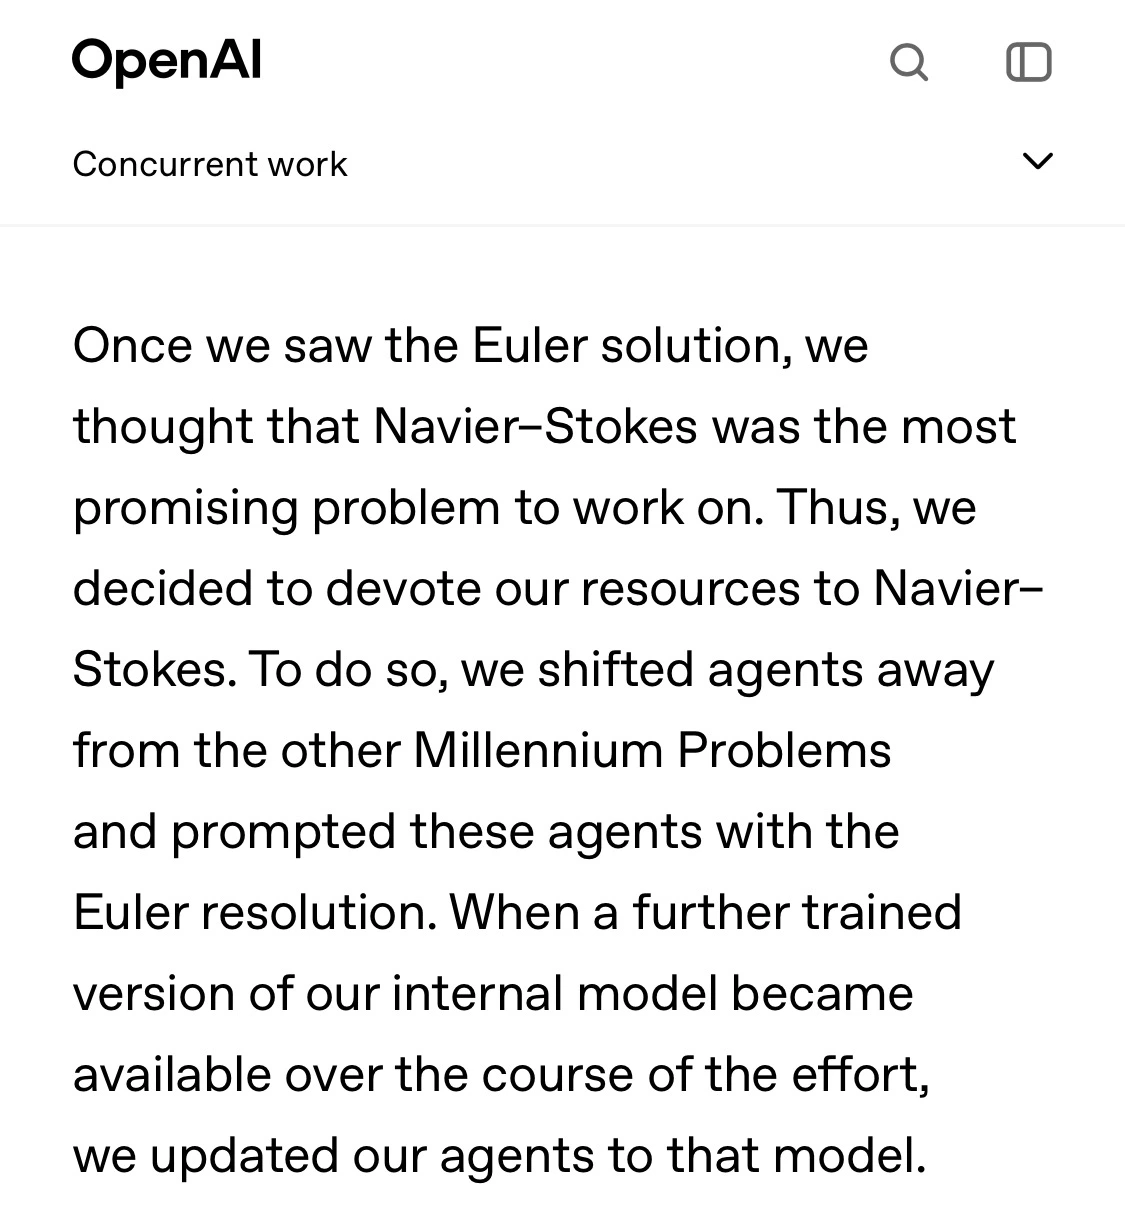
오픈AI에서는 오일러문제를 풀었기 때문에 나비아-스토크 문제도 곧 풀린다 라는 강력한 믿음 또는 근거가 있었던 것으로 보입니다.
하지만 적어도 유동해석 비전공자인 저는 오일러문제와 나비아-스토크 문제사이에 이런 강력한 연관관계에 관한 사전지식이 없습니다. 저와 같은 유동문제 비전문가였을 오픈AI 관계자들이 이 오일러문제가 풀린 이후 외부 유동 전문가의 자문을 받았다는 언급도 블로그에 없습니다. 그렇다면 오픈 AI 내부에 밀레니엄 문제급 유동해석에 관한 최고 수준의 전문가가 이미 있었던 걸까요? 그럼 이 최고의 유동전문가가 2026년 9월 1일 이전에 오픈AI사에 이미 있어야 했던 어떤 이유가 있었을까요? 흠…
그렇게 오픈 AI는 오일러 문제가 풀린 의미를 설명해 줄 유동문제 외부 전문가의 자문을 생략한 것과는 별개로 아주 큰 결정을 합니다. 유동문제가 아닌 다른 6개의 밀레니엄 문제를 풀던 모든 에이전트들의 작업을 중단시키고 이들 모두를 합쳐서 10000개의 에이전트를 “총” 동원해 나비아-스토크문제를 풀기 시작합니다. 마치… 다른 밀레니엄 문제는 못 풀지만 나비아 스토크 문제는 곧 풀릴 것이라는 합리적 근거가 있는 것처럼 말이지요.
그런데 사실 밀레니엄 문제들은 답이 있는지 없는지도 모르는 난제 들인데 AI가 겨우겨우 1년에 걸쳐 문제를 풀어냈다 해도 대단한 것인데…
심지어 유동문제 비전문가 집단이라고 할 수 있는 오픈AI에서 무언가 시간에 쫓길 때 주로 사용하는 올인 전략을 이렇게 과감하게 펼칠 수 있었던 합리적 근거는 과연 무엇이었을까요? 저는 그 근거를 도저히 못 찾겠습니다.
거기에 더해 더 강화학습된(further trained) IM도 이 문제풀이에 동원됩니다. 문제 풀이에 처음부터 사용된 IM도 2026년 8월 28일 버전으로 이미 오픈AI 최신버전 AI모델입니다. 이보다 더 강화 학습을 받은 updated IM은 8월 28일부터 9월 3일 (1일+50시간+alpha)까지 과연 무엇을 배웠을까요? 그 일주일정도 사이에 배운 능력이 나비아-스토크 문제를 푸는데 확실히 도움이 될 거라고 오픈AI는 판단했을 텐데… 그 판단의 이유가 과연 무엇이었을까요? 적어도 저는 정말 정말 궁금합니다.
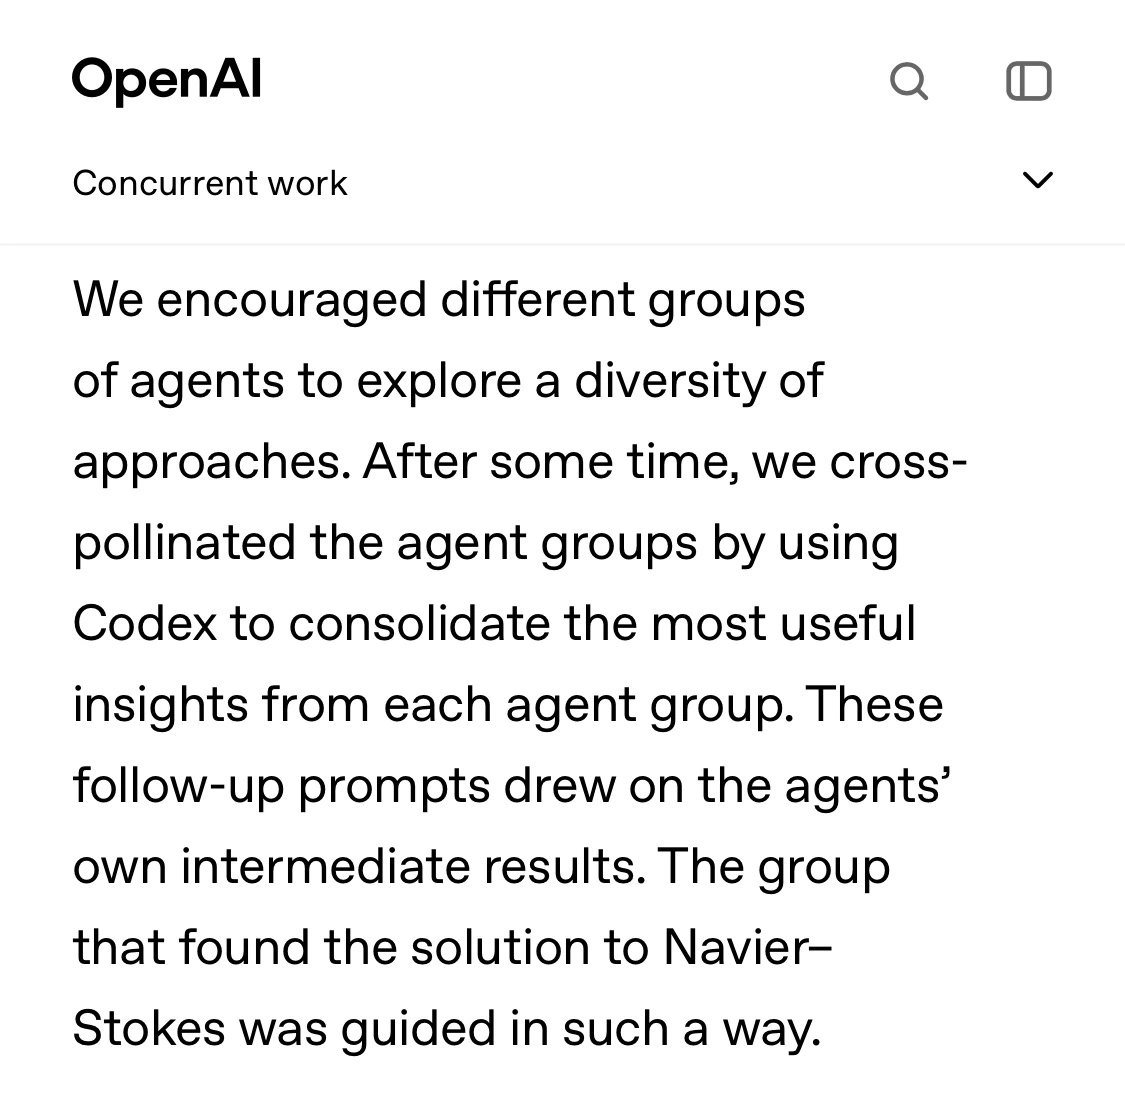
그리고 이문제를 푸는데 한 가지 트릭(!)이 더 사용됩니다. 일정 시간 동안의 10000여 AI에이전트들의 결과 중에 가장 훌륭한 인사이트를 보인 결과물을 활용해 새롭게 프롬프트를 구성해 모든 에이전트들에 동시에 적용했다는 겁니다. Codex를 이용해 일종의 에이전트들 사이에 “강제적”이고 “풀 수동적” 상호작용( 커뮤니케이션)을 시켰다는 겁니다.
이 작업은 지독하게 인위적입니다. 가장 훌륭한 인사이트를 어떻게 선정하죠?
이는 마치 정답이 없을지도 모르는 인류 최대의 난제를 풀어낼 중간 과정을 이미 알고 있고 그래서 AI결과물이 정답에 가까워진 정도를 점수화해 평가할 수 있다고 보고 codex코딩을 미리 만들어 놨다는 말인데…
밀레니엄 난제를 세계최초로 사람보다 빨리 풀어내는 것이 목적인 이런 대규모 전사적인 프로젝트에 어설픈 codex코드를 썼을 리는 없고, 분명 그 코덱스 코드는 사전 검증을 훌륭히 통과했을 텐데… 이런 특수목적 코드는 어떻게 미리 만들었으며 사전 검증은 또 어떻게 진행했는지…..
음… 뭔가 앞뒤가 안 맞고 선후관계가 헷갈립니다.
정리하면, 그렇게 시간 테이블상 오일러 문제가 풀린 것이 50시간 후입니다. 그로부터 38시간 후에 밀레니엄 문제를 해결하게 되는데, 그 38시간 사이에,
- 10,000개의 에이전트를 모두 총 동원하는 올인
- 새롭게 학습된 updated IM 적용
- 일정 시간이 흐른 후 그 10000개의 결과물 중에 가장 좋은 결과물을 선별하고 이를 반영하여 새로운 프롬프트를 만들어 모든 에이전트에 적용하는 codex 적용
이 모두 전광석화같이 결정되고 실행되었습니다.
이 과정에서 회사의 운명을 좌우할지도 모를 큰 규모의 프로젝트에서 흔히 볼 수 있는 신중함은 전혀 찾아볼 수 없습니다. 오히려 마치 소규모 팀 중심의 결과가 훤히 눈에 보이는 패스트 트랙 프로젝트식 운영으로 보입니다.
이 모든 중요한 결정들이 프로젝트 결과물에 직접적으로 영향을 끼칠 것이 뻔한 만큼 매우 신중하게 결정했어야 했을 텐데,
전혀 그렇지 않았음에도 마치 모든 의사결정이 톱니바퀴 연결되듯 한치의 어긋남 없이 작용하는 기적이 일어나 인류가 90년 동안 못 푼 문제를 88시간 사실상 38시간 만에 풀어냈습니다. (머리로 이해할 수는 없지만) 참으로 대단합니다.
이것이 88시간 만에 밀레니엄 문제를 풀어낼 때까지의 과정입니다. 적어도 저는 보상해킹을 상상히지 않을 수 없습니다.
심지어 어떤 근거에서인지는 알 수 없으나 오픈AI에서는 자신들의 AI가 이 밀레니엄 문제를 (보상해킹을 통해서??!!) 반드시 풀어낼 거라고 적어도 9월 3일 이후에는 강하게 확신한 것 같다고 저는 의심합니다.
의문점 6. 사람이 먼저 풀었다!
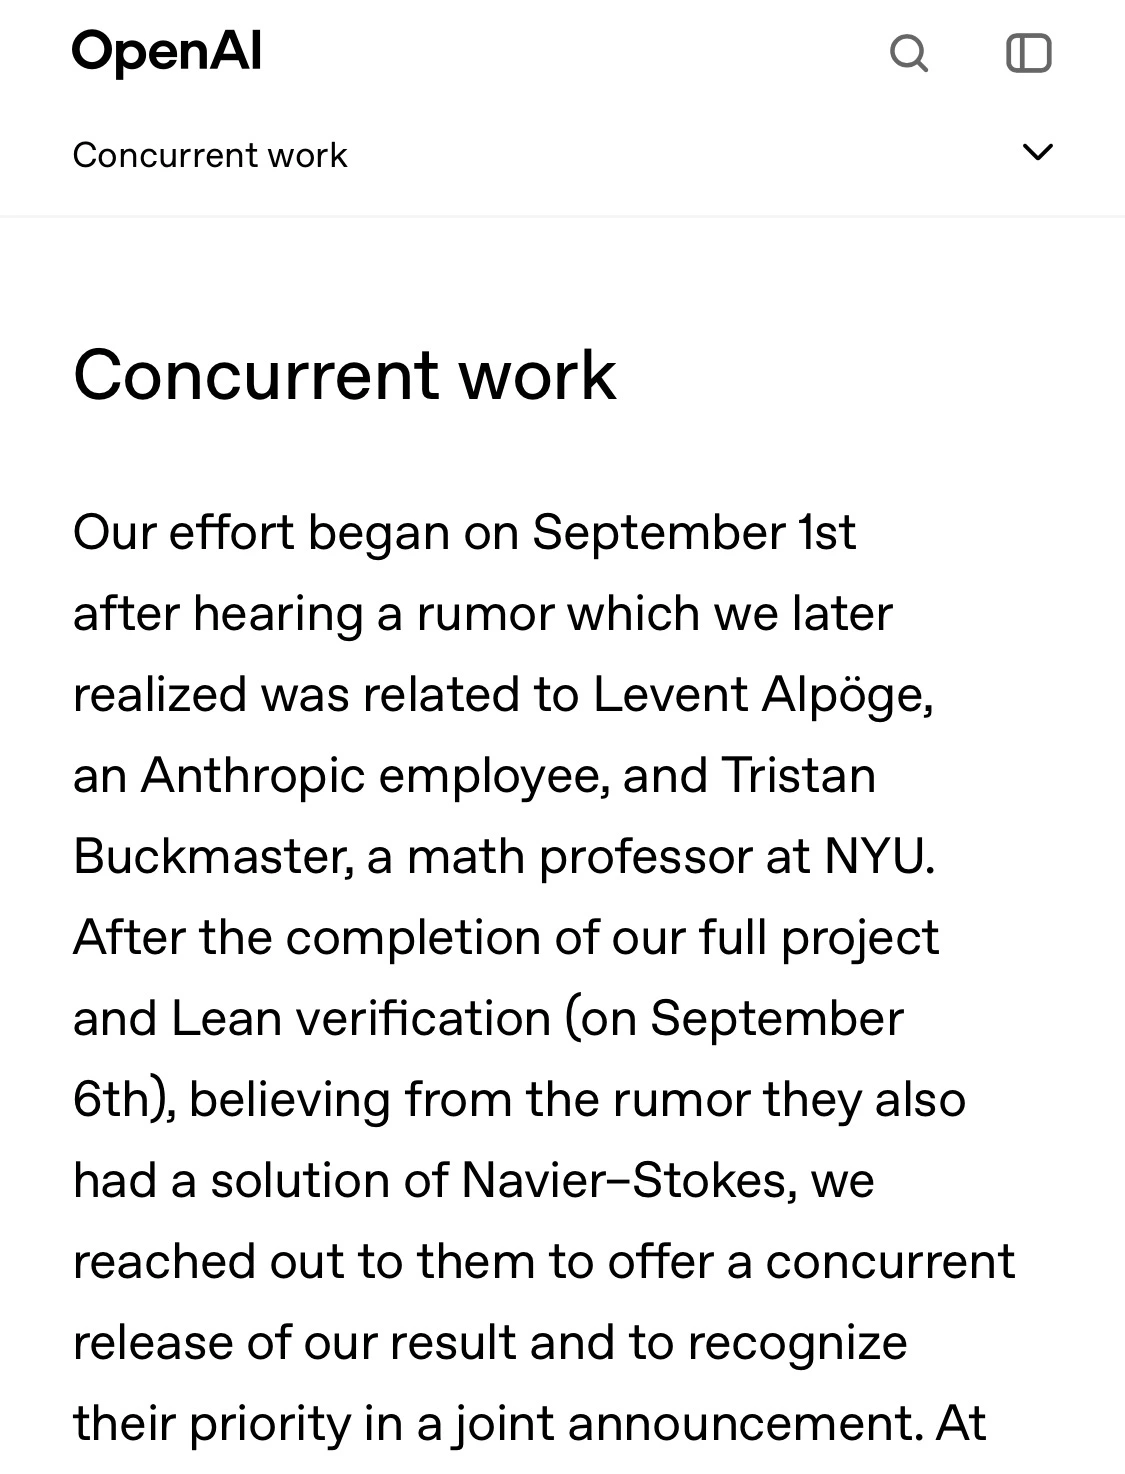
이후 블로그는 이 문제를 먼저 풀어낸 수학자들의 업적을 이야기하고 그들을 치하합니다. 이와 함께 그들이 AI에 앞서 이뤄낸 업적과 이번 오픈AI가 IM 모델을 이용해 얻은 성과는 서로 독립적으로 이루어진 별개의 성취라고 주장합니다.
그런데 과연 오픈AI의 주장에 신뢰성이 있을까요?
이 부분은 언론홍보에 전혀 나오지 않는 부분인데, 사실 아주 매우 중요한 부분입니다.
이 밀레니엄 문제를 한발 먼저 풀어낸 사람들의 이야기를 들어보면 openAI가 블로그를 통해 공개한, 밀레니엄 문제를 푸는 과정상에서 있었던 일들에 관해 제가 제기한 이 의문점들이 실타래처럼 풀립니다.
다음 글에서는 이 밀레니엄 나비아-스토크 문제를 먼저 풀어낸 수학자들의 선언문의 내용을 분석하겠습니다.
https://fishingproductfr.com/@goimul/161