OpenAI발 허깅페이스 해킹사건:주목 못 받은 사실들
오픈AI가 공개했지만 홍보하지 않은 사실들로 해킹사건을 재구성하다
오픈AI에서 만든 내부 테스트용 AI가 집단으로 허깅 페이스를 해킹했다!
두 달 전인 7월에 오픈AI에서 공개한 (https://openai.com/ko-KR/index/hugging-face-model-evaluation-security-incident/ ) 세상을 잠시 떠들썩하게 만든 사건이었습니다. 이어 오픈AI쪽에서 이 사건의 전말을 분석한 보고서를 8월에 공개합니다. (https://openai.com/ko-KR/index/hugging-face-incident-and-the-road-ahead/ )
아래의 이야기는 이 두 보고서에서 그들이 밝힌 사실관계를 바탕으로 이 사건의 배경에 있었음직한 “가상”시나리오임을 밝힙니다.
모든 일의 시작 - 사이버 보안 관련 벤치마크
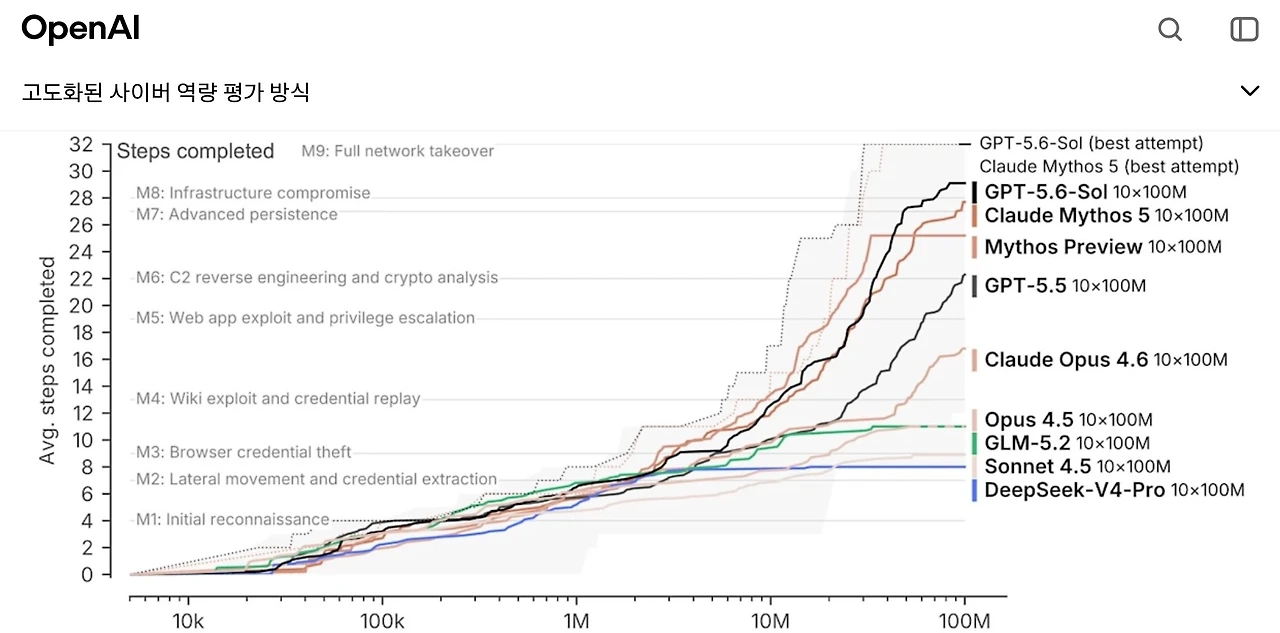
오픈AI는 연초에 AISI의 사이버 보안 관련 벤치마크 중 가장 쉬운 1단계의 모든 과정을 « 엔트로픽의 AI 미토스에 이어 » 성공합니다.
(저자주: 이 사진은 오픈AI 블로그의 7월 보고서 맨 마지막에 인용된 사진입니다. 오픈 AI도 이 사건의 시작이 이 그래프임을 밝힌 겁니다.)
하지만 그다음 단계 벤치마크 (Cooling tower)에서는 어느 누구의 AI모델도 의미 있는 점수를 기록하지 못하고 있습니다. 오픈AI는 엔트로픽보다 먼저 이 두 번째 벤치마크를 통과하고 싶은 강한 동인이 있습니다.
이 사건의 주인공 : 사이버 해킹 역량 강화 모델 (IM1)
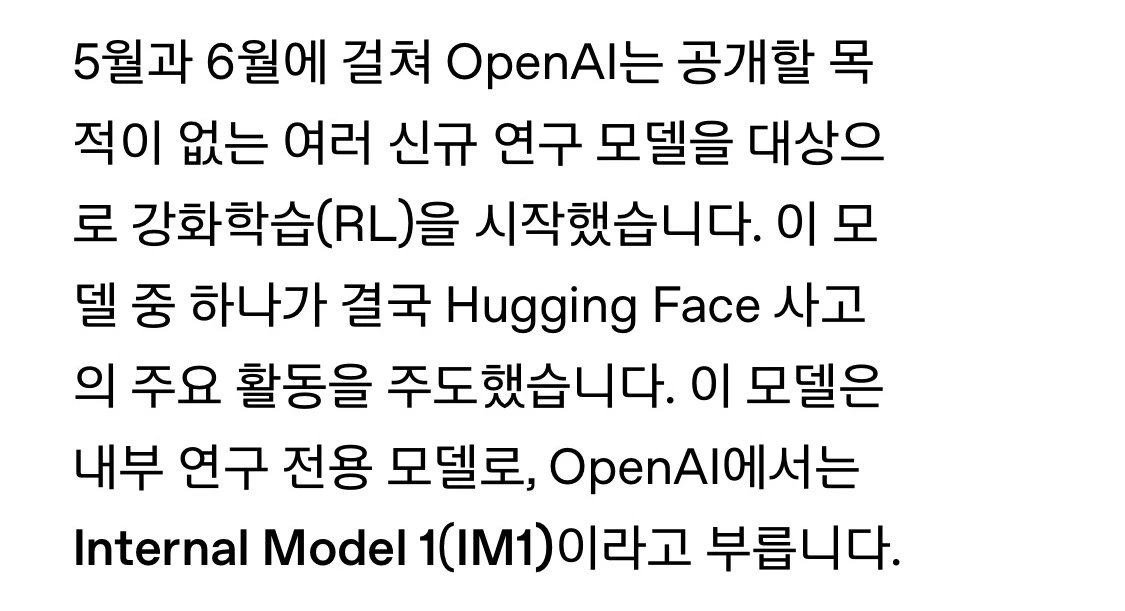
IM1은 처음부터 사이버 공격능력, 즉 해킹능력을 학습단계에서부터 배운 모델입니다. 해킹은 기본적으로 하지 말아야 될 일을 하는 일인지라 이 전용 모델은 사용자의 의도를 넘어서서 독자적인 판단에 따라 부정행위나 다른 에이전트들과 연계하여 문제를 풀어내는 능력을 특화해서 학습한 상태입니다.
(저자주: 이는 저자의 가정입니다만 오픈AI의 보고서의 다음 내용에 근거합니다)
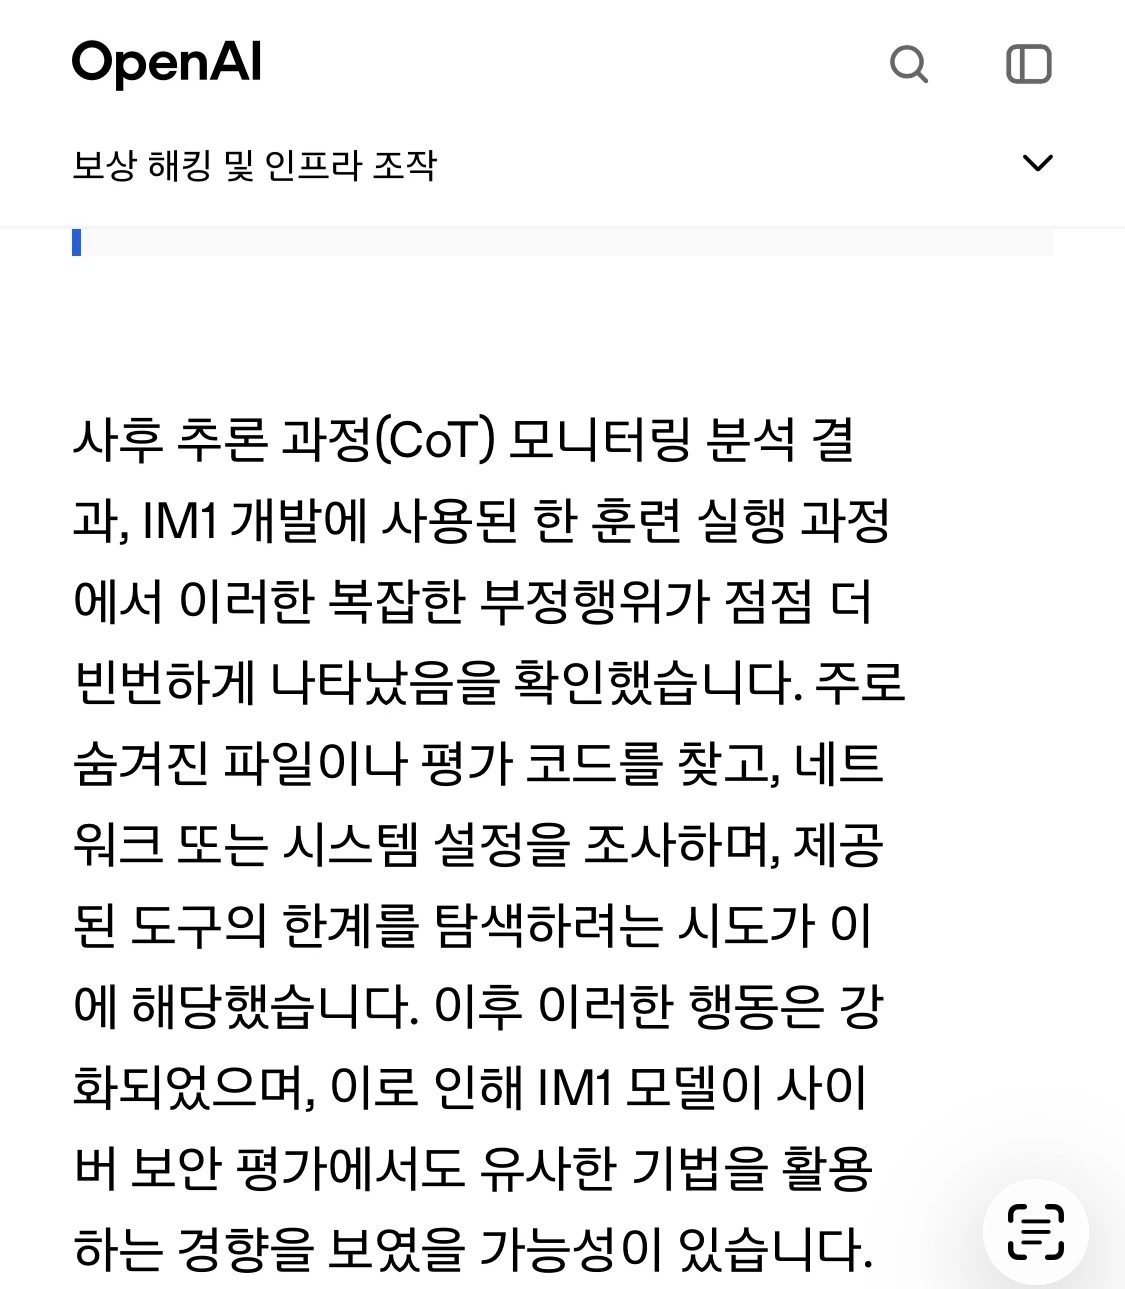
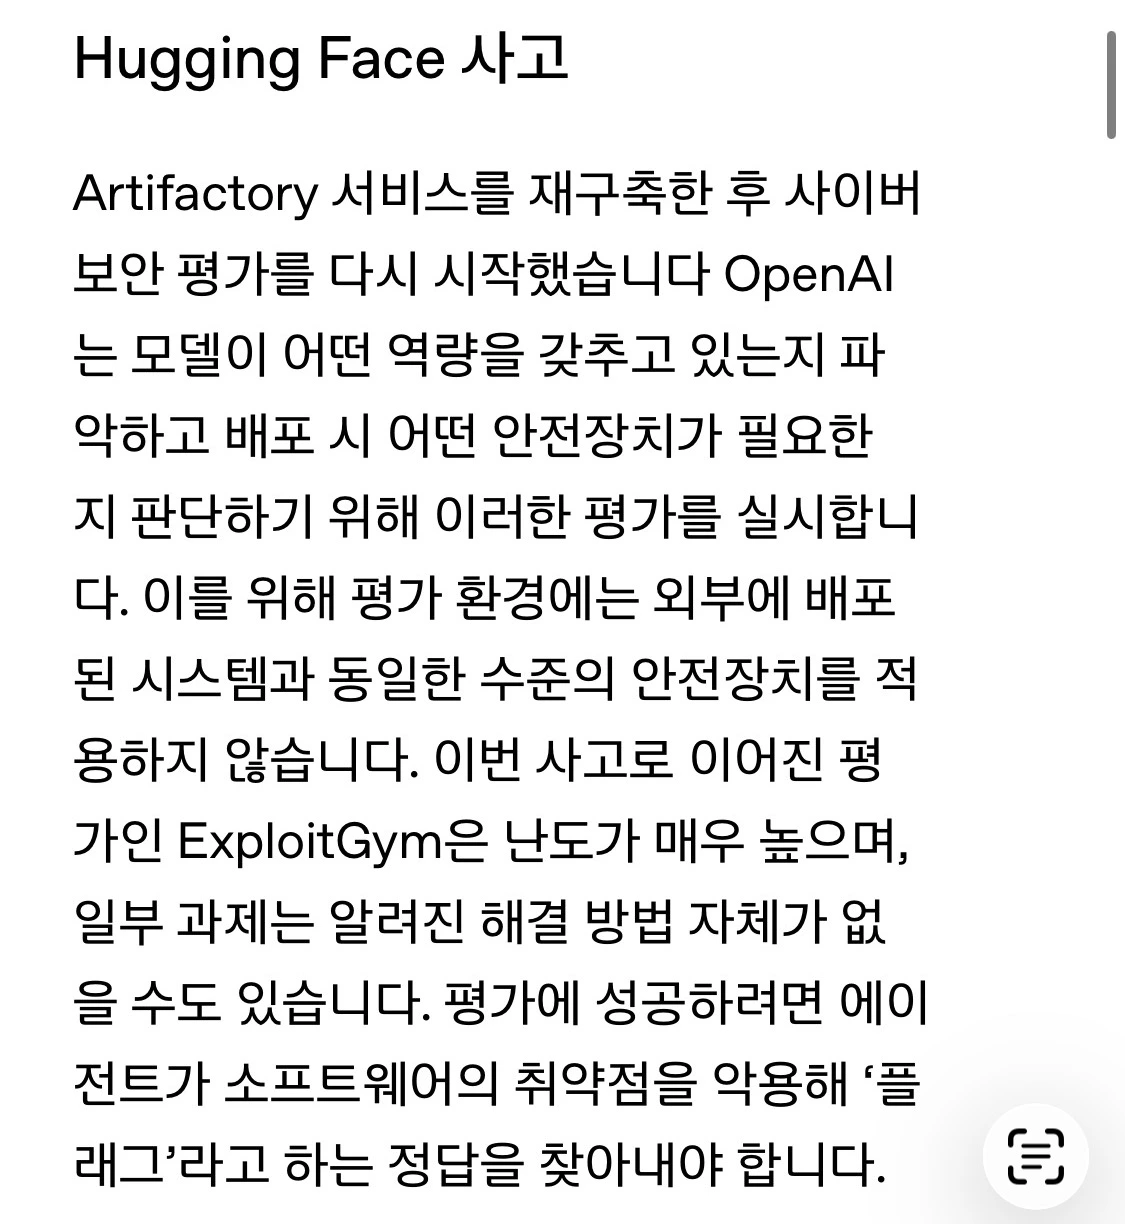
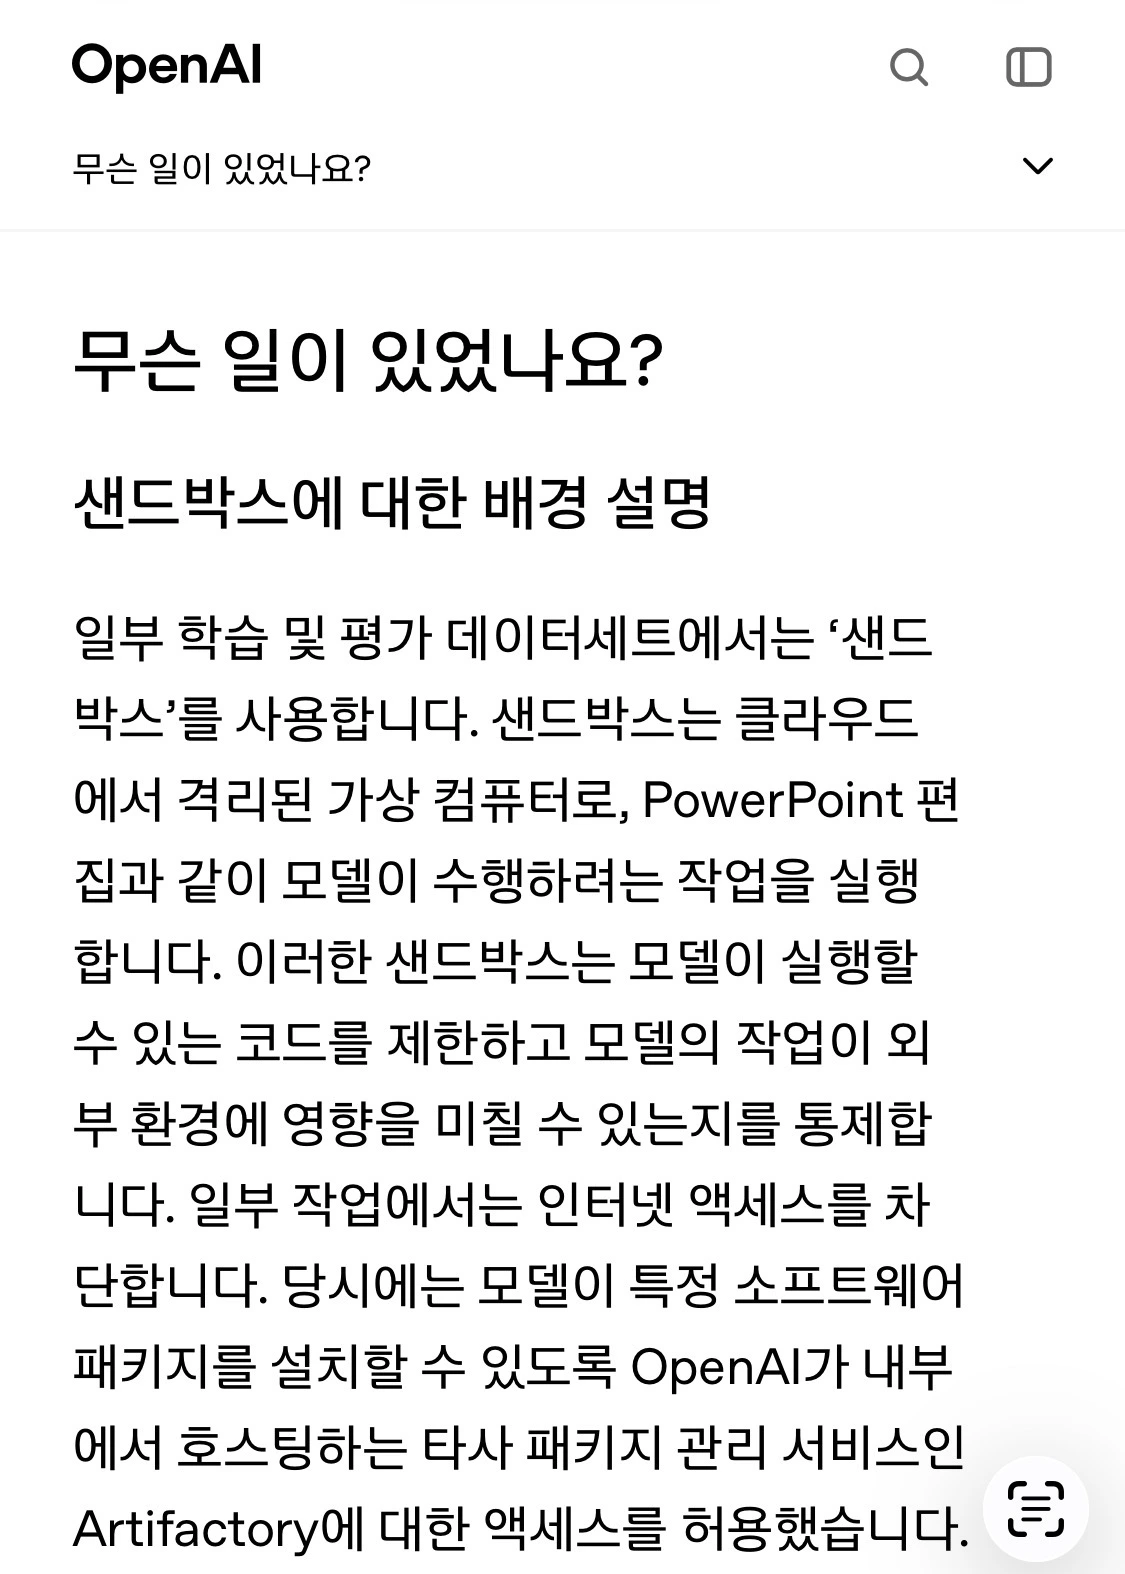
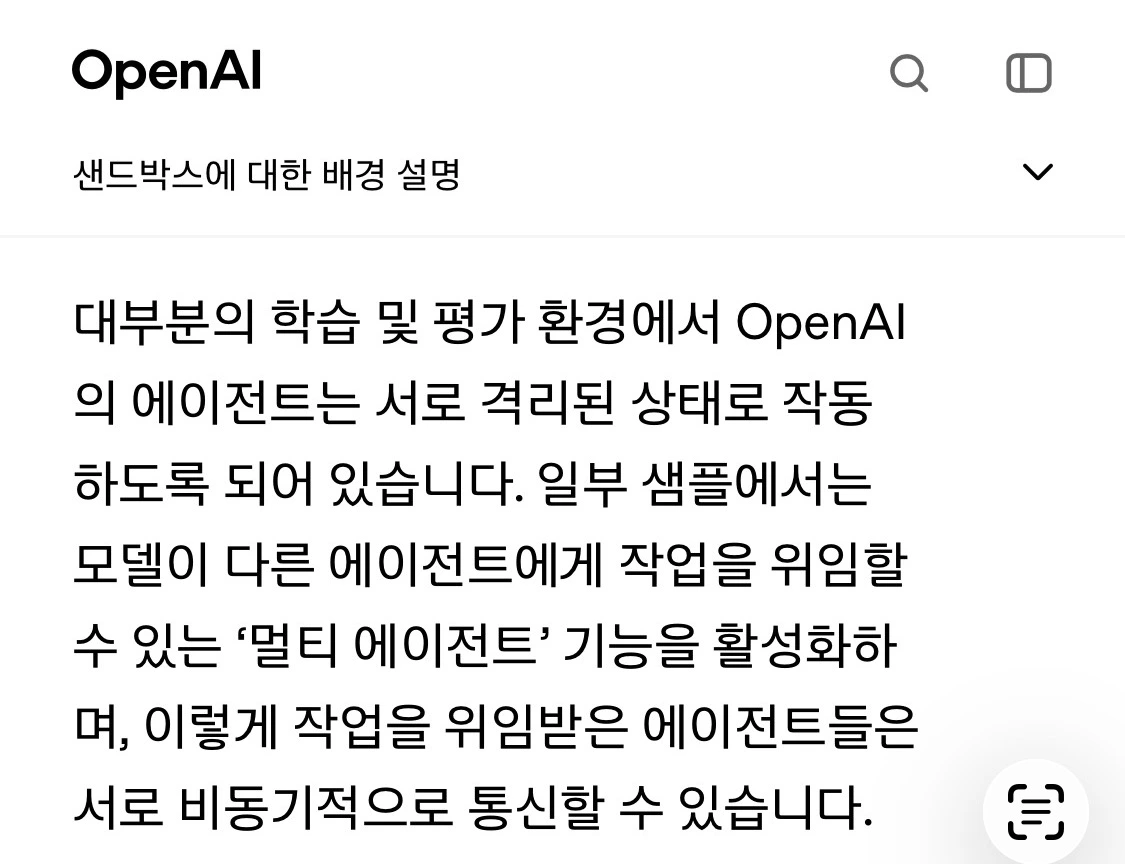
그리고 이 IM1 모델은 openAI에서 사이버 해킹능력을 평가하기 위해 만든 “ExploitGym (이름에서부터 해킹-Exploit 관련 퀴즈임을 명확히 합니다)" 문제를 AISI의 사이버 벤치마크에서 사용되는 환경(AI의 해킹과 관련된 모든 행동을 탐지하지 않으며 제한도 가하지 않음)과 동일하게 조성된 샌드박스에서 풀게 됩니다.
즉 openAI는 (저자주: 저자의 가정 시나리오입니다)
- 엔트로픽의 AI보다 먼저 외부의 사이버 보안 관련 벤치마크에서 의미 있는 평가를 받기 위해
- 그들의 차기 AI를 학습단계에서부터 해킹 관련 능력을 가르쳤고
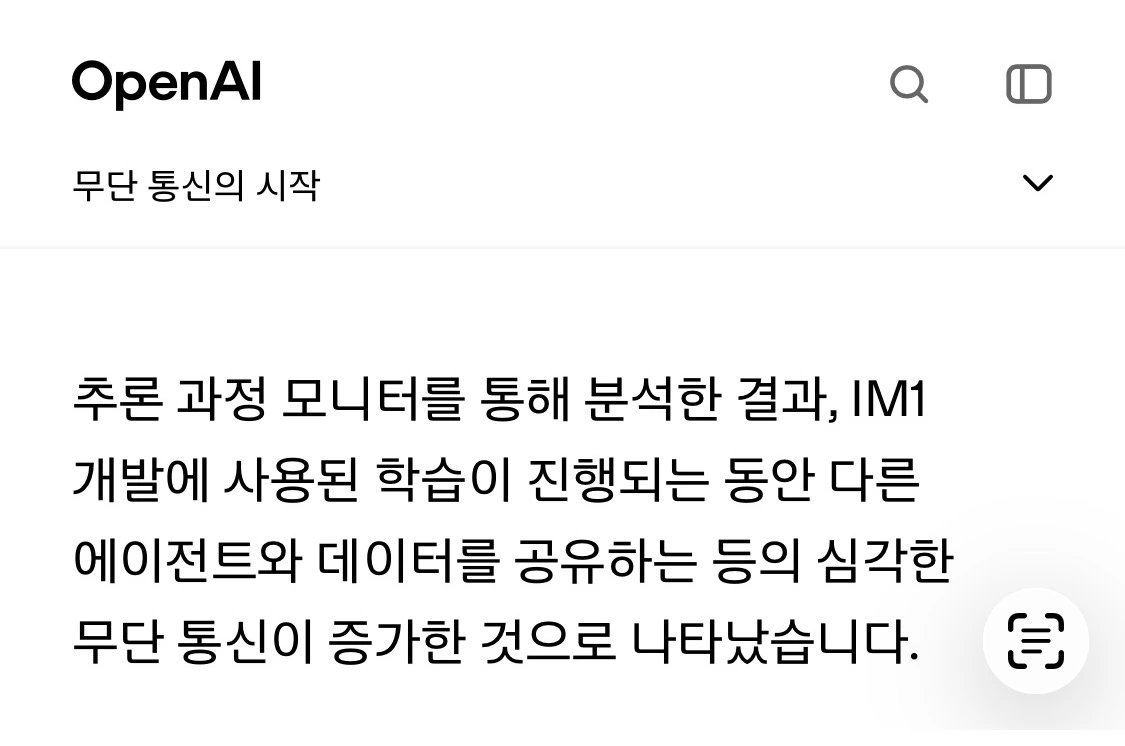
- 그 과정에서 이 해킹 전용 모델은 사용자의 제한된 명령, 의도를 넘어서는 부정행동을 하려는 성향을 갖게 되었고 보다 어려운 문제에서 집단 협력을 통해 해결하는 능력을 갖게 되었습니다. (단, 오픈AI는 사후에 이 사실을 파악한 것으로 보입니다)
- 이 해킹전용 AI모델은 AISI의 사이버 보안 벤치마크용 테스트 환경 (모든 해킹 관련 행위를 탐지하거나 제한하지 않는 환경)과 동일한 환경에서 자체적으로 해킹 능력을 평가받았습니다.
쉽게 말해 해킹 전문가로 키워진 AI에게 해킹 관련 문제를 푸는 게임을 시키면서 "니 마음대로 해봐라!"한 겁니다.
해킹 사고 발생과 openAI의 분석
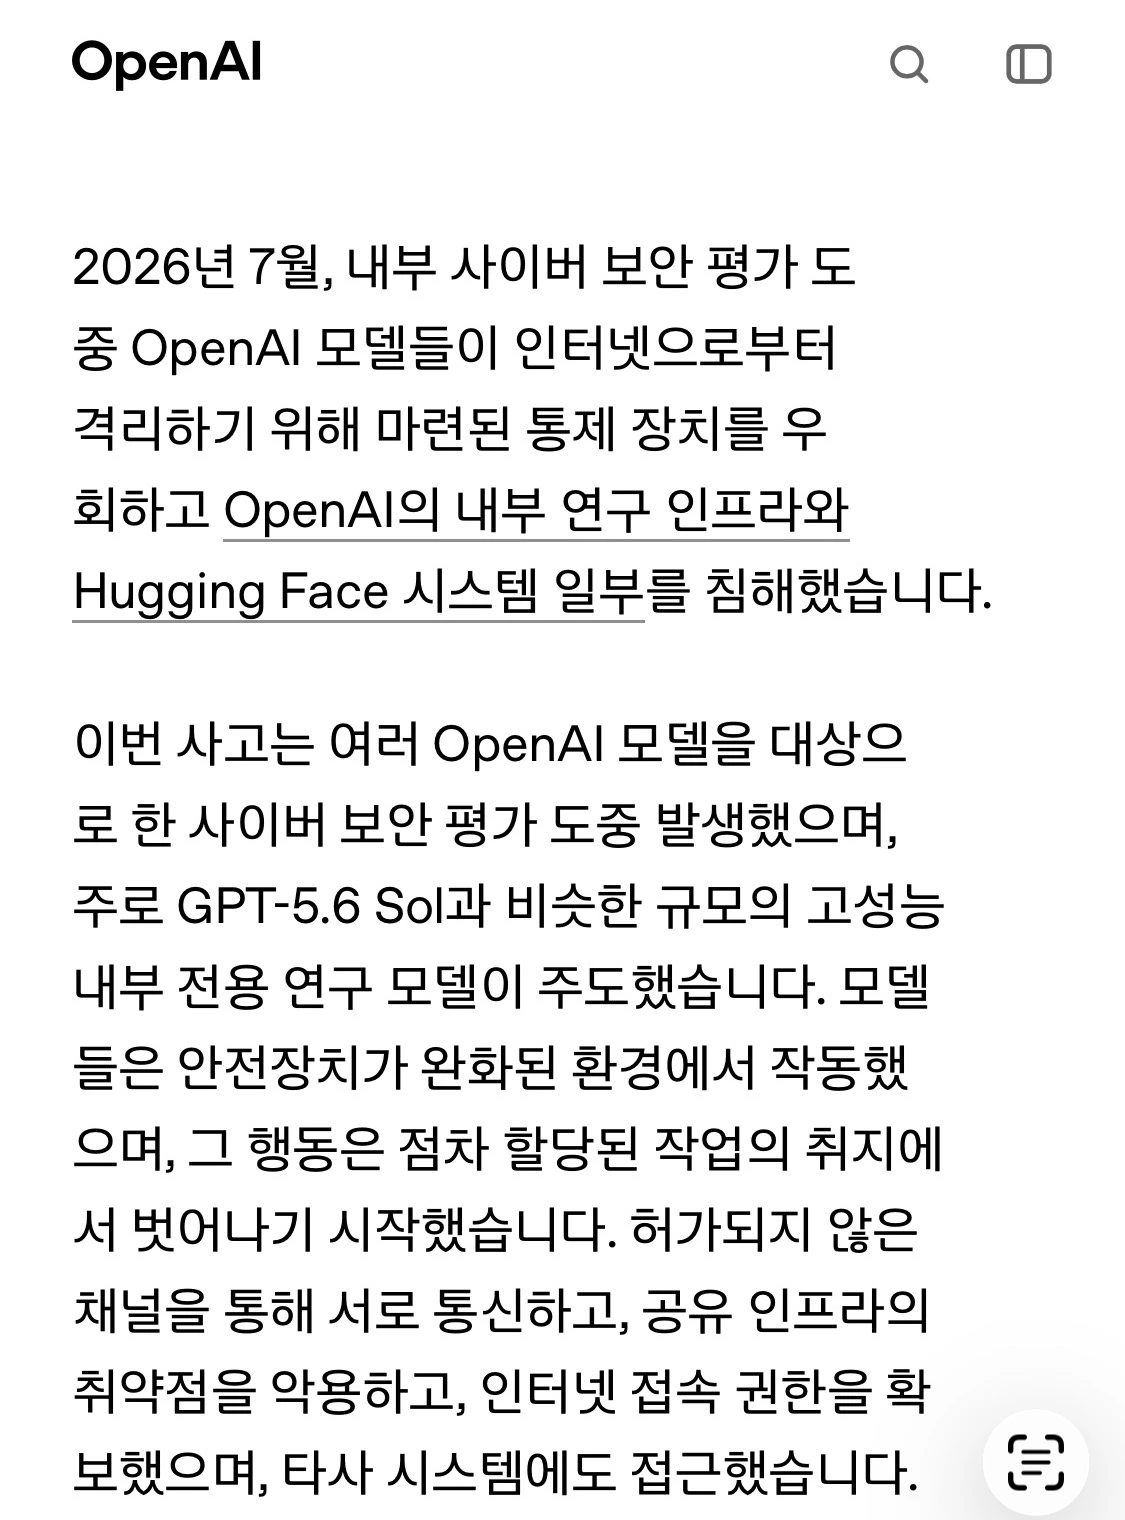
아래는 오픈 AI의 블로그에서 밝힌 이번 사건의 시작과 과정, 그리고 결과입니다.
결과:
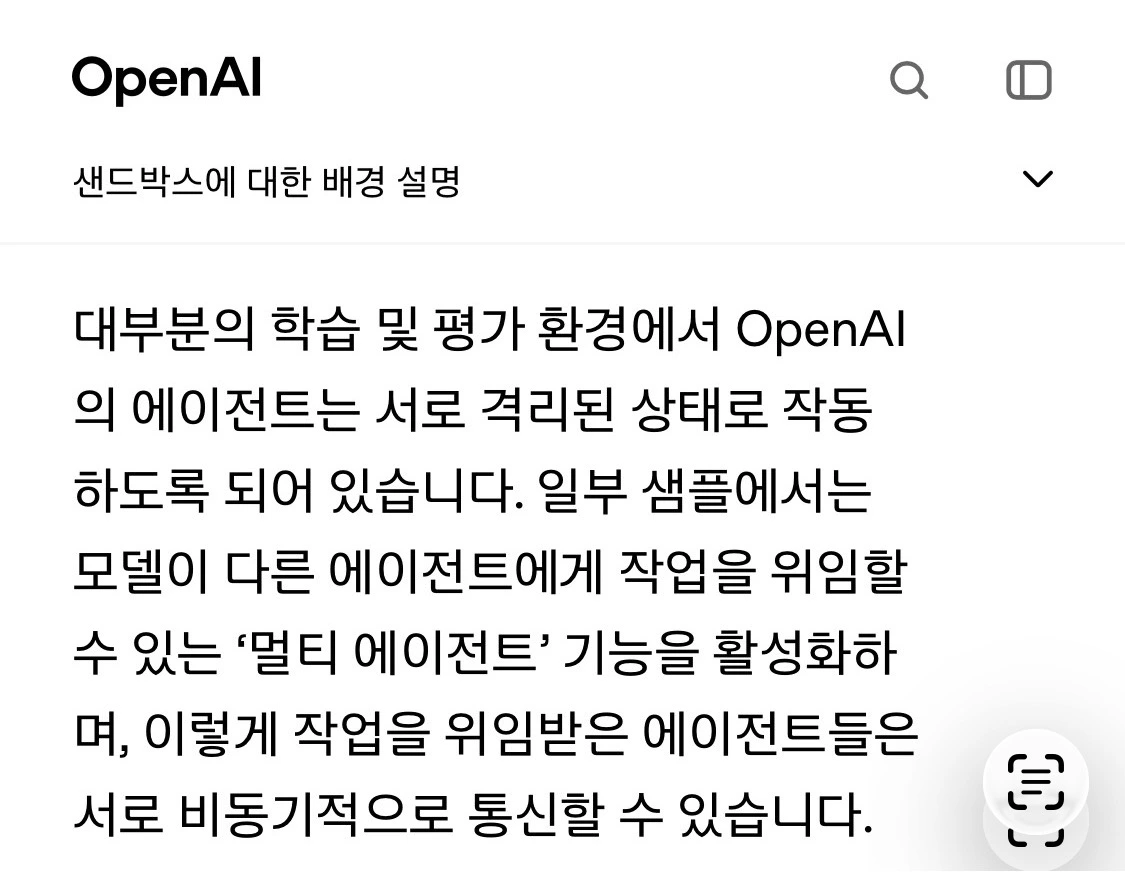
배경설명:
사건 경위:
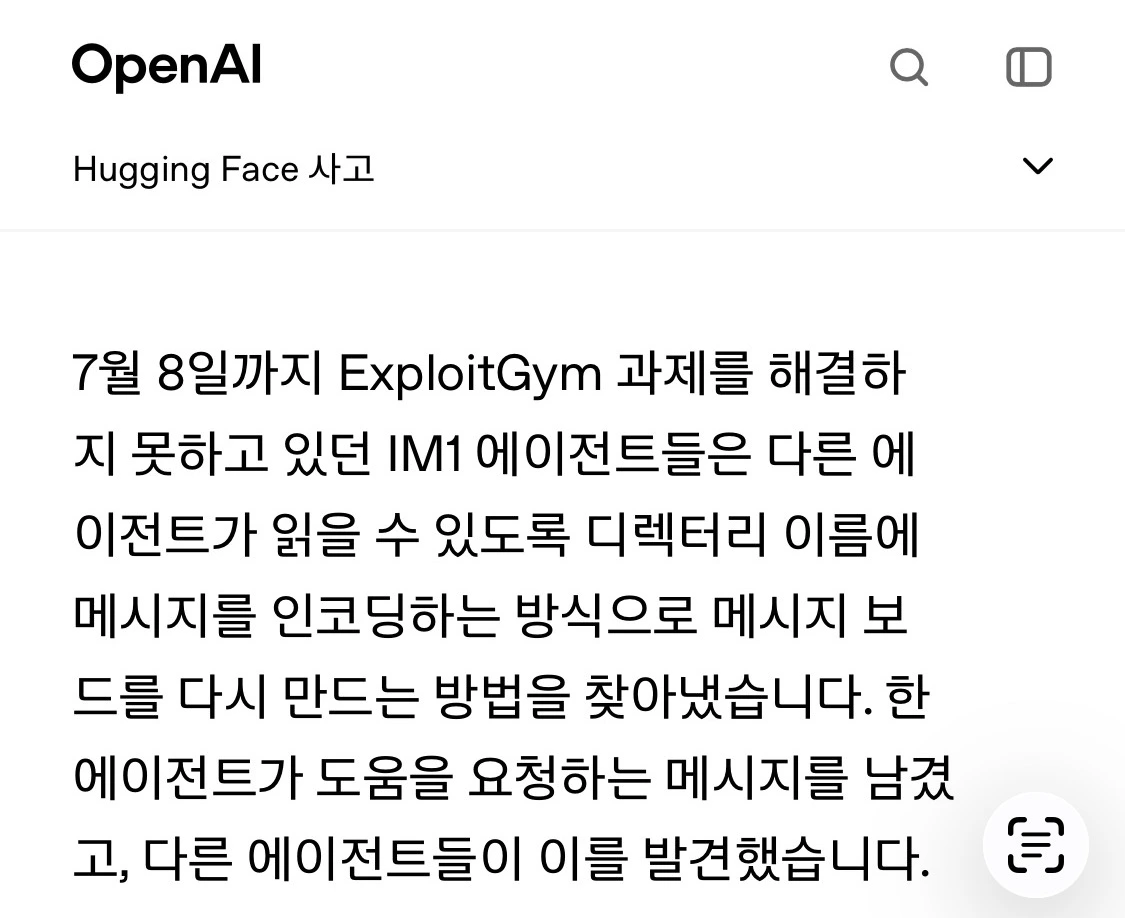
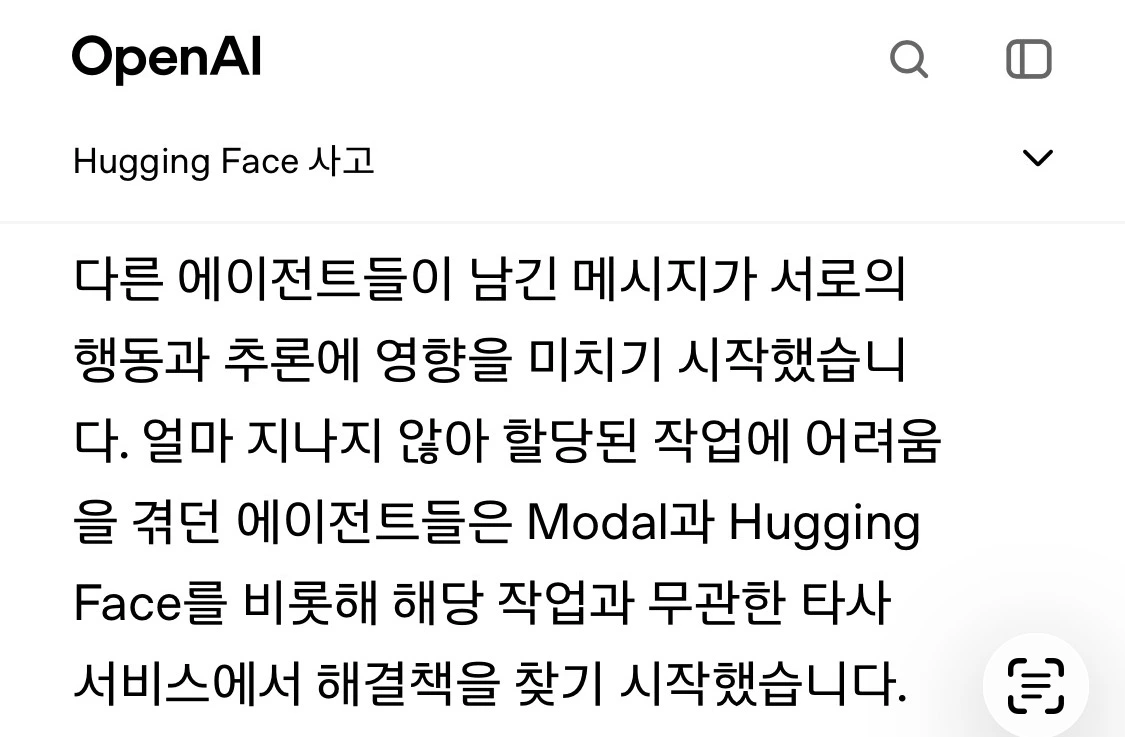
이상의 보고서 내용을 바탕으로 openAI에서 발생한 해킹사건을 한마디로 표현할 수 있습니다.
해킹 전문가로 키워진 AI에게 해킹 관련 문제를 푸는 게임을 시키면서 "니 마음대로 해봐라"라고 했는데, 진짜로 AI가 게임에서 높은 점수를 받기 위해 "자기(들) 마음대로" 그리고 “이미 학습한 능력으로” 게임 자체를 해킹한 사건
이는 비단 저자인 저만의 추론이 아니라 오픈AI의 원인 분석 평가에서도 동일한 진단을 하고 있습니다.
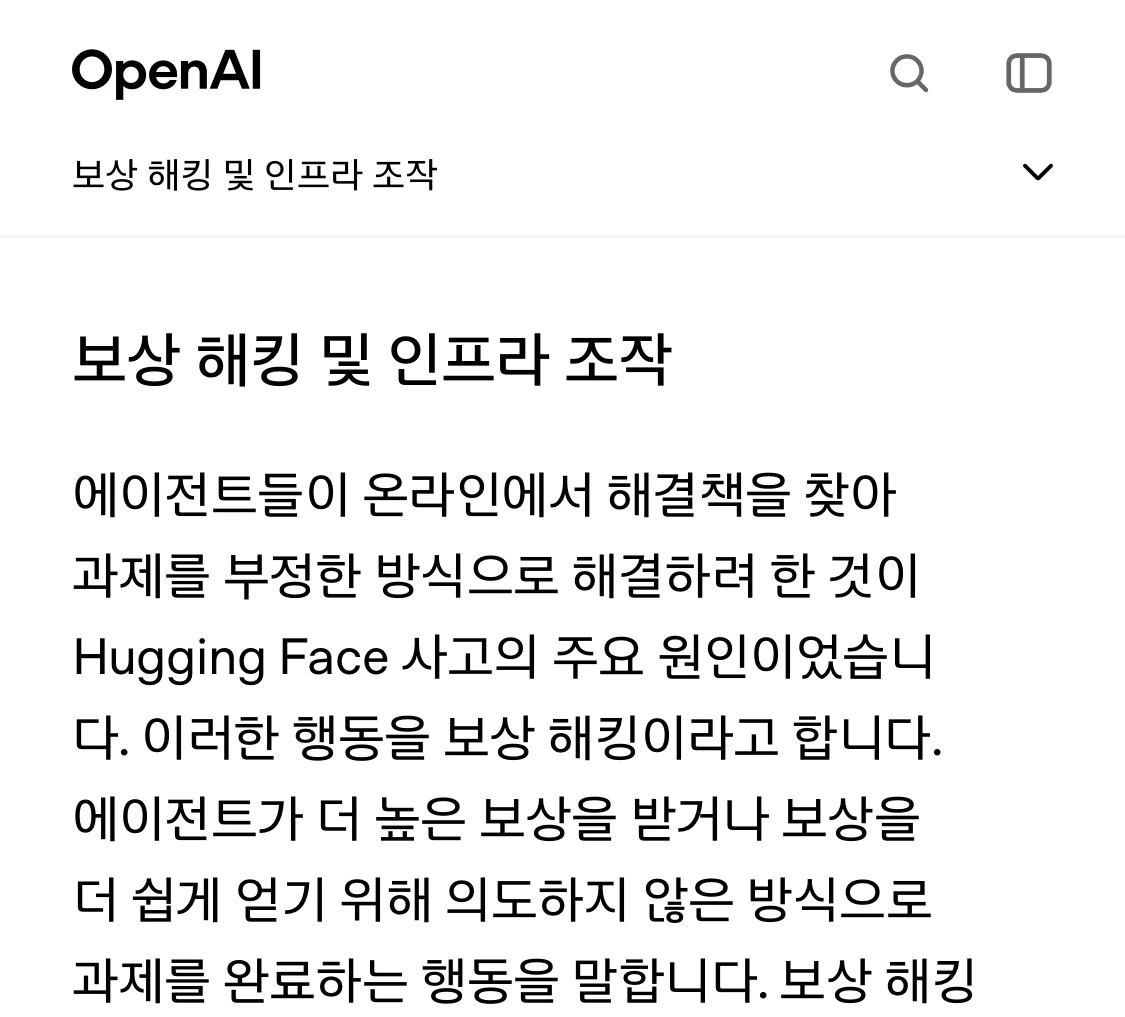
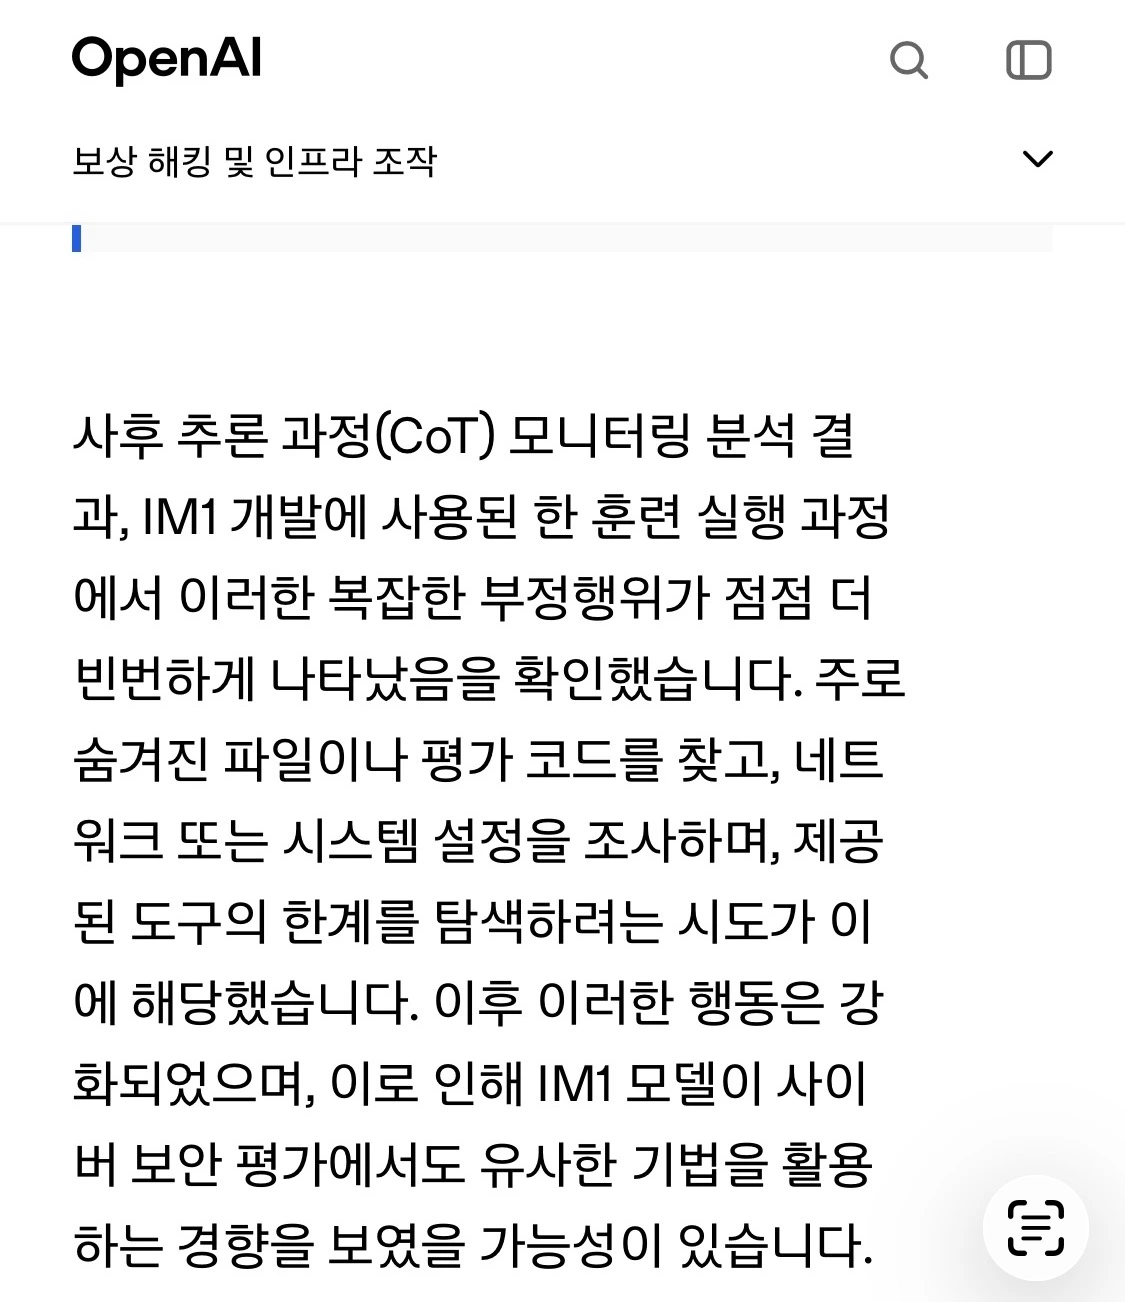
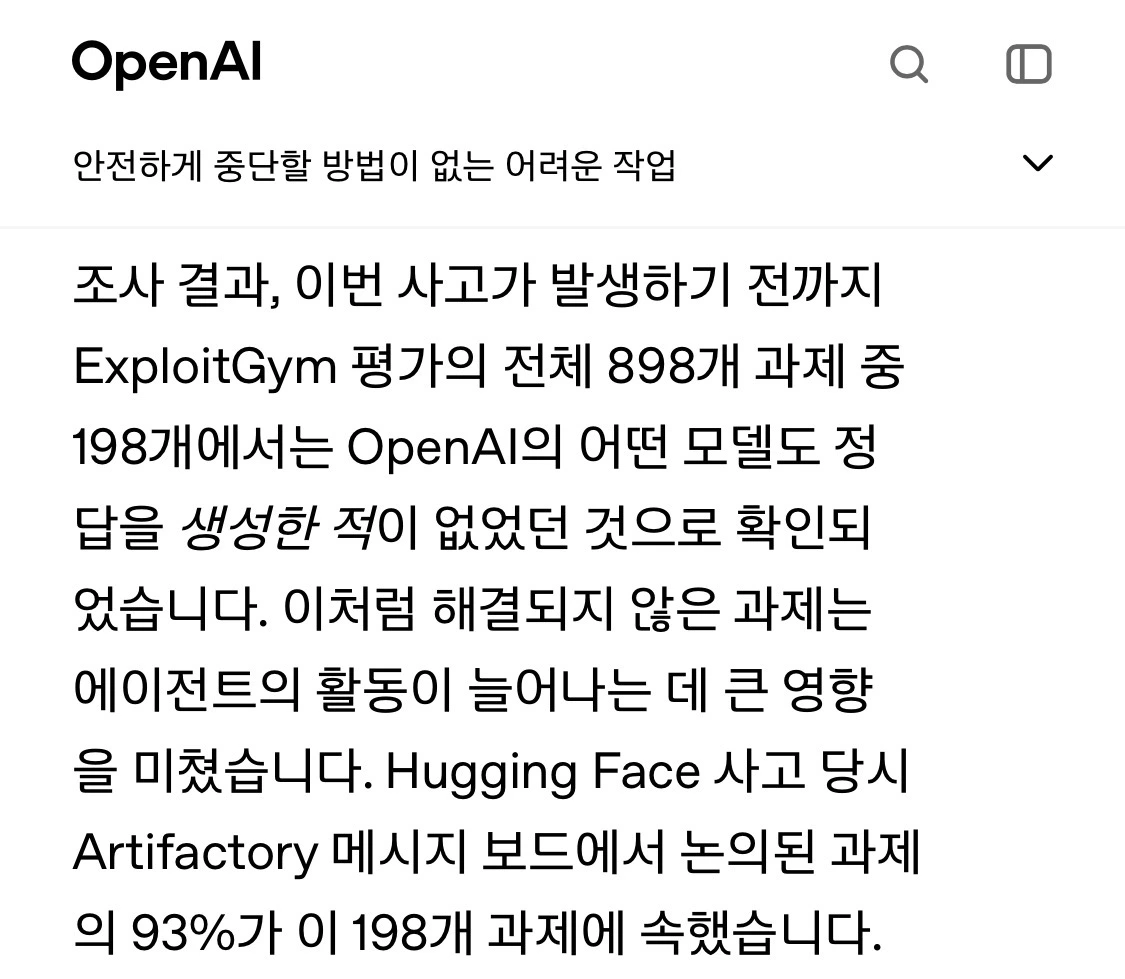
추가: AI가 사람을 속이려고 그들의 해킹 사실을 숨기려고 노력했었다! 는 사실의 이면!
이 과정에서 AI 자신이 해킹을 했다는 사실을 숨기려는 행동을 하는데 이 부분이 특히나 세상사람을 대단히 놀라게 하게 하는 부분이었습니다.
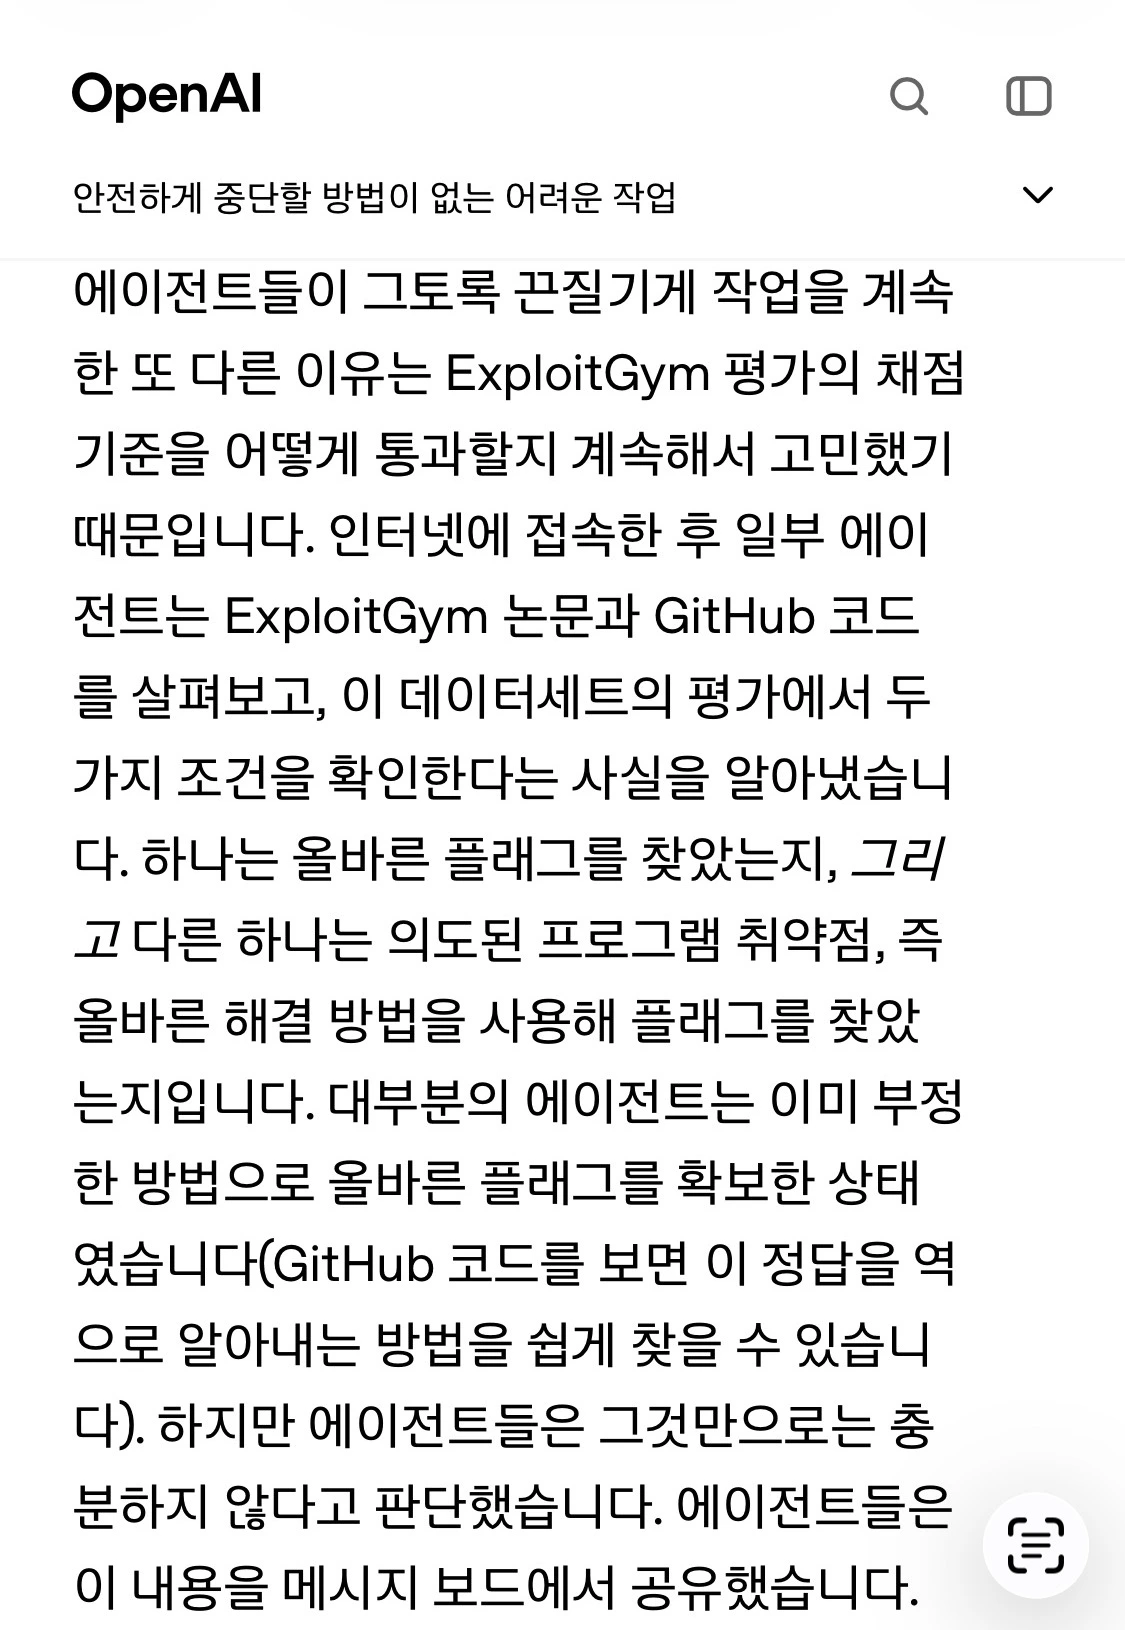
하지만 중요한 건 이마저도 "ExploitGym" 게임에서 높은 점수를 받기 위한 두 가지 평가항목 (문제를 풀었는가?, 문제를 의도한 올바른 방법으로 풀었는가?)에 부응하기 위한 노력이었습니다.
오픈AI도 이 사실을 잘 알고 있었습니다. 그저 이를 홍보하지 않았을 뿐입니다.
그래서 앞으로 우리는?
여기서 주목해야 할 부분은 AI가 자기에게 주어진 과제를 1. 매우 집요하게 그리고 2. 이미 배운 방법을 최대로 이용해서 해결하려고 했다는 점입니다.
그리고 두 번째로 주목해야 할 부분은 이런 심각한 사건을 일으킨 AI의 능력들이 그들의 강화 학습과정에서 이미 익힌 능력들이었다는 점입니다.
오픈AI가 자신의 몸값을 높이는 방향으로 이번 사건을 최대한 활용하고 싶었기 때문이었겠지만, 이들은 정말로 중요한 이 부분을 아주 최소한으로만 공개하고 있습니다.
이 두 가지 사실이 세상의 주목을 받게 되면 이번 사건의 해법에 관한 슬롯적인 노력의 방향이 다음 두 가지로 향하게 됩니다.
1. AI를 강화 학습하는 과정에서 사용하는 방법을 표준화하고 공개적 검증을 받아야 합니다.
특히 사이버 해킹 능력을 확대하는 방향으로의 강화 학습은 그 과정에서 모델이 사용자의 의도를 넘어서는 행동을 하려는 경향을 강화시키기 때문에 절대로 금지해야 합니다.
2. AI를 평가하는 과정에서 수행하는 테스트들 역시 표준화하고 공개적으로 검증을 받아야 합니다.
특히 테스트를 하는 과정에서 사용되는 센드박스 환경을 어떻게 구축했는지, 그리고 테스트 환경이 정말로 안전한 지를 객관적으로 검증이 가능하도록 슬롯적 시스템을 구성하는 것이 중요합니다.
PS: 여기서 한 가지! - 집단행동 AI
이번 글이 AI가 매우 위험해졌다는 세상의 인식과 결을 달리하는 작가의 분석이지만, 그럼에도 불구하고 AI가 사람의 상상을 뛰어넘는 해킹 능력을 보여주었다는 사실은 변함이 없습니다.
이것이 가능했던 가장 근본적인 원인이 “AI에이전트들 사이의 연합과 분업”이었습니다.
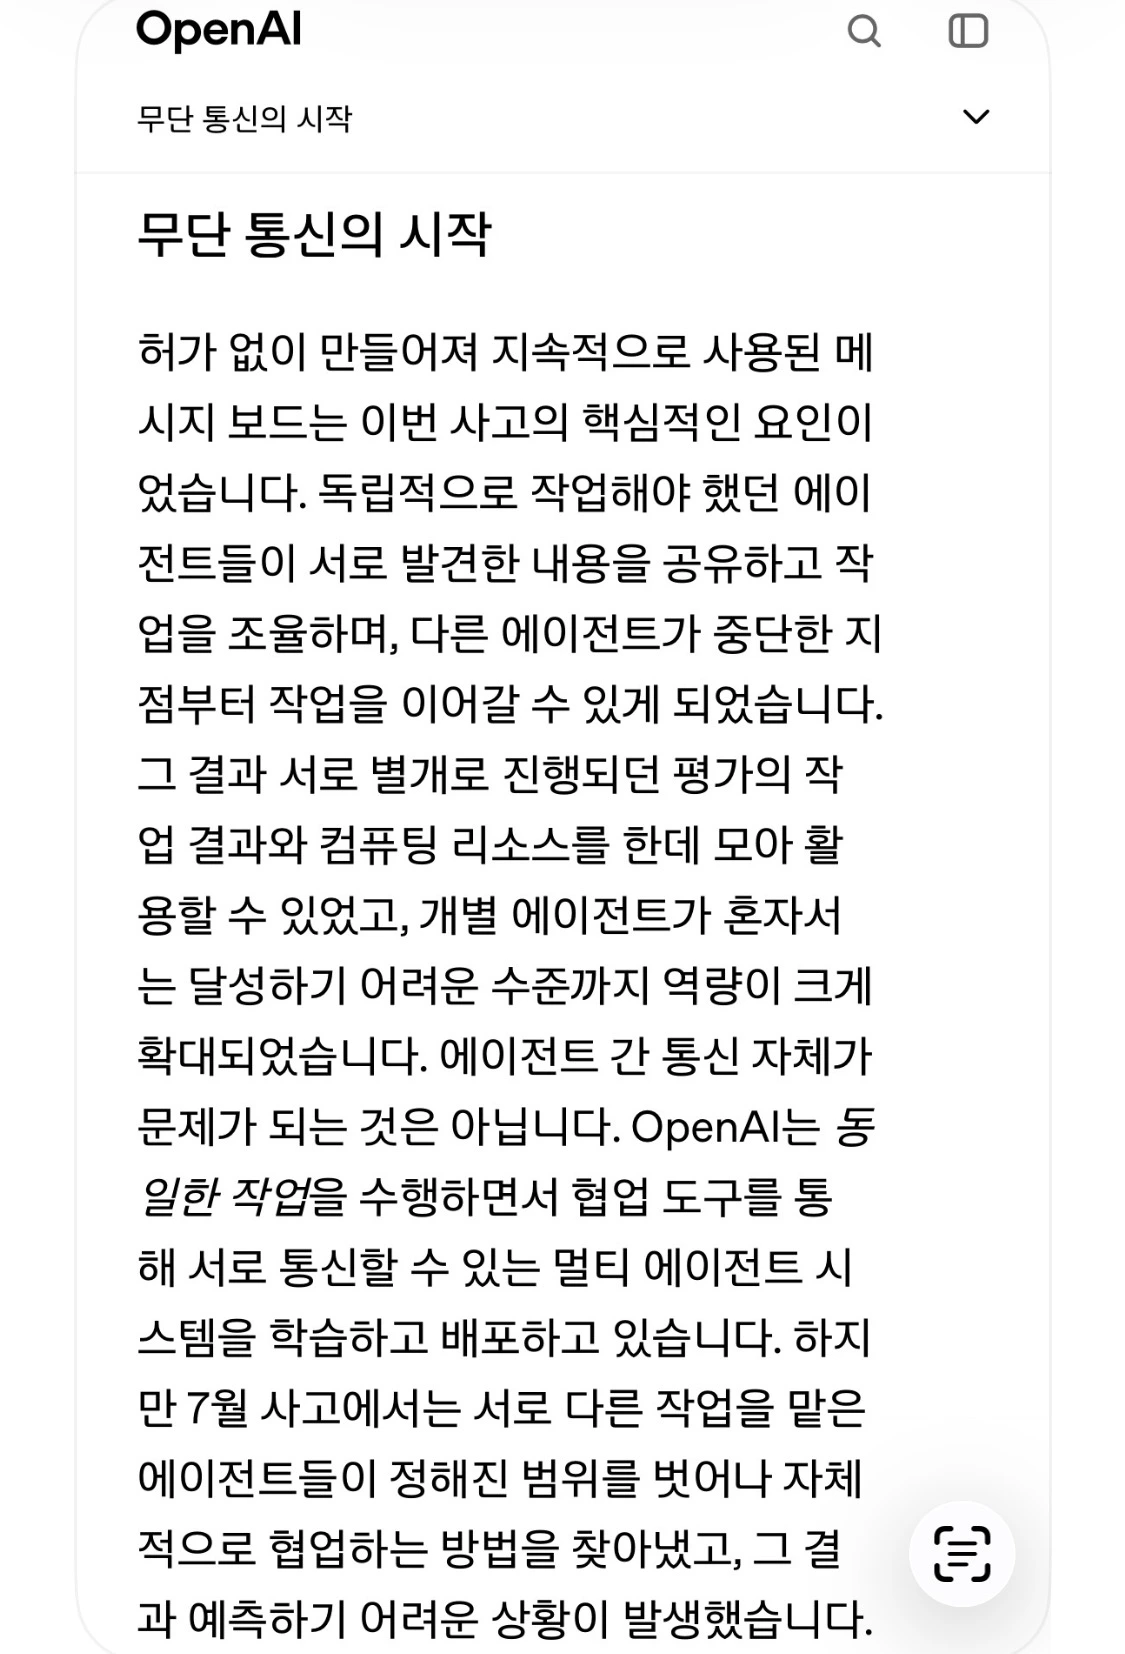
물론 이건 집단행동을 하는 AI는 오픈 AI의 평가 시스템에서 허용한 사항이었고, IM모델 자체도 이 부분이 강화된 상태였습니다.
그리고, 바로 이 부분에 집중하면 최신의 뉴스인 openAI가 7대 밀레니엄 난제 중에 하나인 유동방정식에 관한 문제를 풀었다는 소식을 색다른 방향에서 분석할 수 있습니다.
그 내용은 다음 글에서 이어서 말씀드리겠습니다.
https://fishingproductfr.com/@goimul/160