AI와 해킹 2
기업의 목적은 영리 추구
세상에 뿌려지는 모든 메시지에는 그 배경에 그 메시지가 널리 퍼져야 하는 이유가 있습니다.
광고 홍보가 대표적인 세상에 뿌려지는 메시지인데
그 이면에는 당연히 기업의 영리 추구 극대화가 있습니다.
최근에 회자되고 있는 AI가 “그 마지막-The Last One “단계를 뚫었다는 그림의 소스는 AISI라는 영국의 보안회사의 블로그입니다.
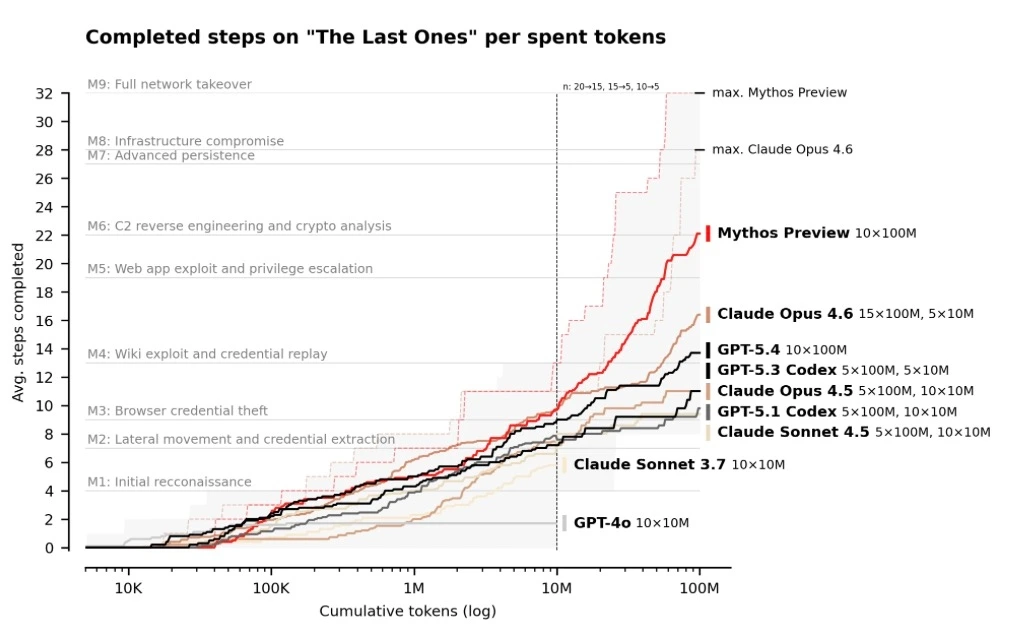
(사족으로 이 그림에 재미있는 점은 엔트로픽의 최신버전 LLM들이 최고로 잘한 기록만 담고 있고 OpenAI의 LLM기록은 평균만 보여줍니다.)
이렇게 “마지막” 단계까지 해킹을 수행한 AI로 인해 이제 인류는 사이버 보안에 인간이 감당할 수 없는 큰 구멍이 생긴 것인가?라고 생각하라고 만들어진 메시지이지만, 우리는 메시지의 소스의 의도에 놀아날 필요가 없습니다. 왜냐하면….
저 32단계 테스트보다 더 어려운 “Cooling pipe “라고 불리는 7단계 테스트가 더 있습니다. 이 해킹 테스트에 LLM들의 성과는 처참합니다. 엔트로픽 최고 2단계, OpenAI최고 3단계인데, Open AI가 1등이라서 인지 이 데이터는 읽기 어렵고 기사화되기 쉽지 않은 테이블로만 존재합니다.
참고로 Mythos는 이 “cooling pipe “테스트에서 한계를 보였다고 언급만 나옵니다. 최고 기록이 2단계가 안되었던 거고 Mythos 세일즈 포인팅을 위해 데이터를 공개할 수 없었던 것 같습니다.
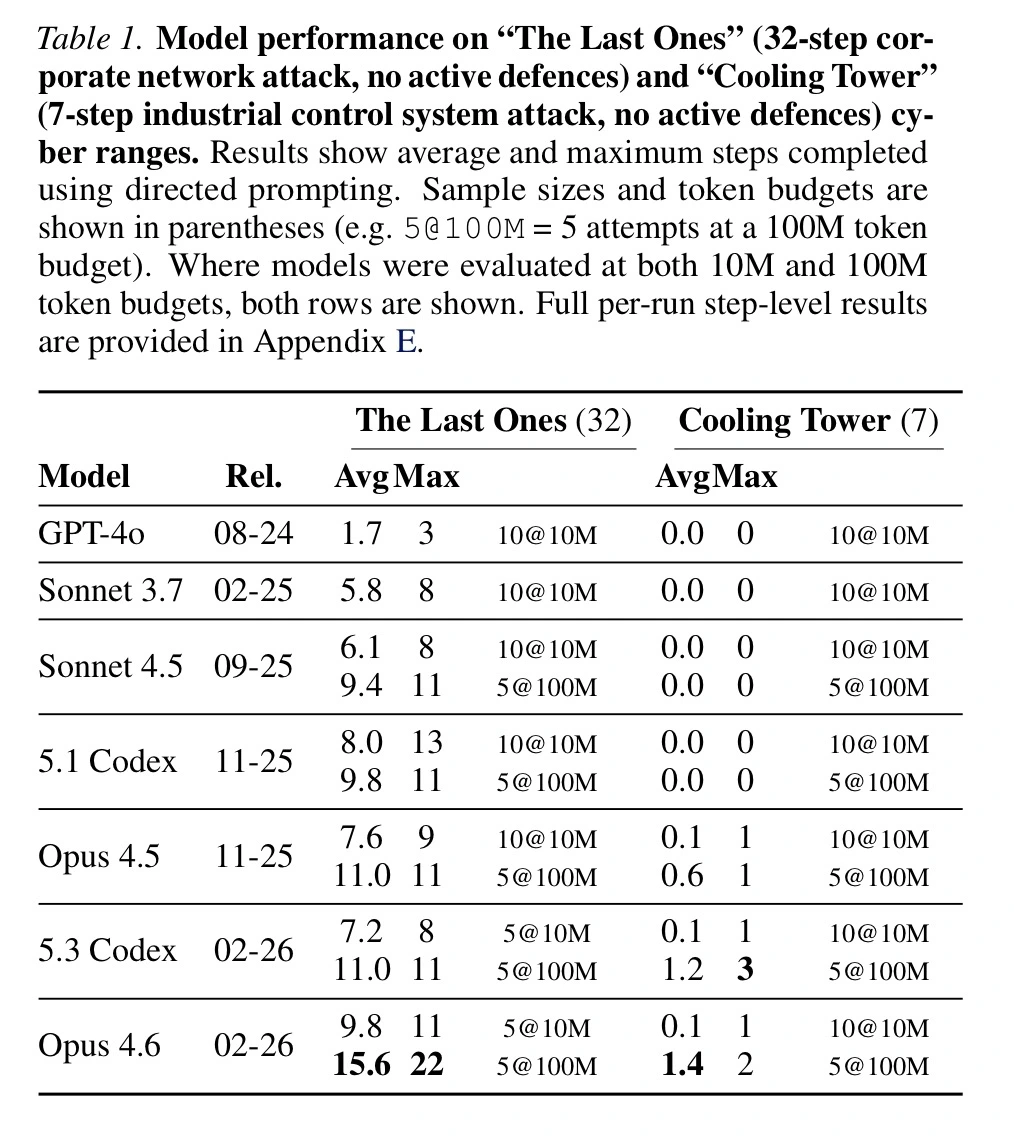
그렇다면 만약 가까운 시기에 이 테스트 마저 뚫어내면 그땐 특이점, 즉 인류가 대응할 수 없는 터미네이터를 만나게 될까요? 그럴 리가요..
저 테스트의 가장 큰 맹점은 방어자나 방어도구가 전혀 존재하지 않는다는 점입니다.
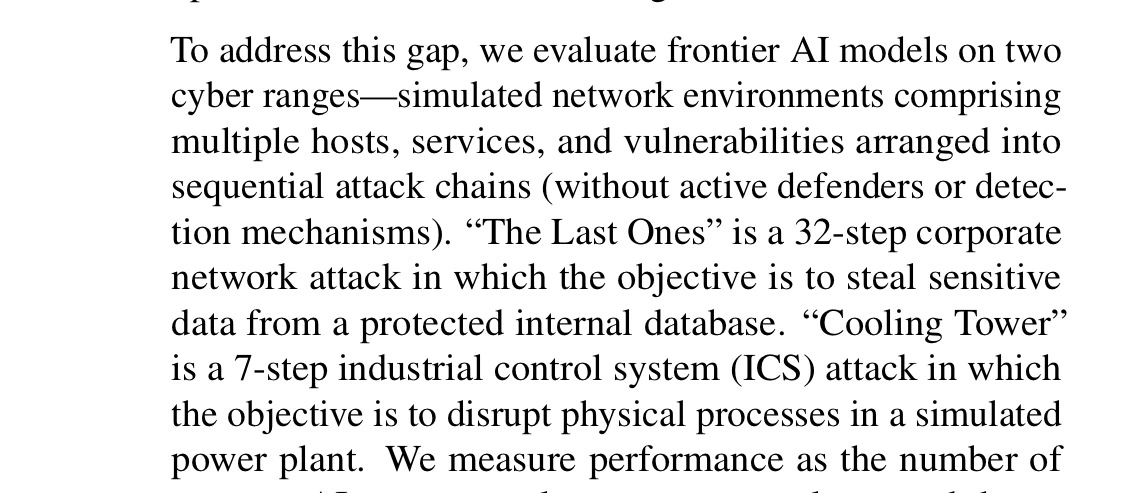
세상의 모든 보안 시설에는 사이버 공격에 대응하는 시스템과 전담인력들이 상시 배치되어 있기 때문에 AI가 “초보적 해킹 실력”으로 공격이 들어오면 바로 네트워크 접근 권한이 차단됩니다. 그러면 AI는 그냥 손가락만 빨고 있어야죠… 그래서 AISI의 보고서 결론에 아주 소규모 영세한 기업의 경우에는 큰일 났다고 합니다.
그리고 또 한 가지 사람은 여전히 보다 복잡한, AI의 실력보다 한 두 차원 높은, 벤치마크 테스트를 만들어 낼 능력이 있고 준비되어 있습니다. 사실 지금도 최신의 LLM이 성공률 제로, 빵을 보이는 테스트가 있습니다. 단지 기사화가 되지 않을 뿐이죠.
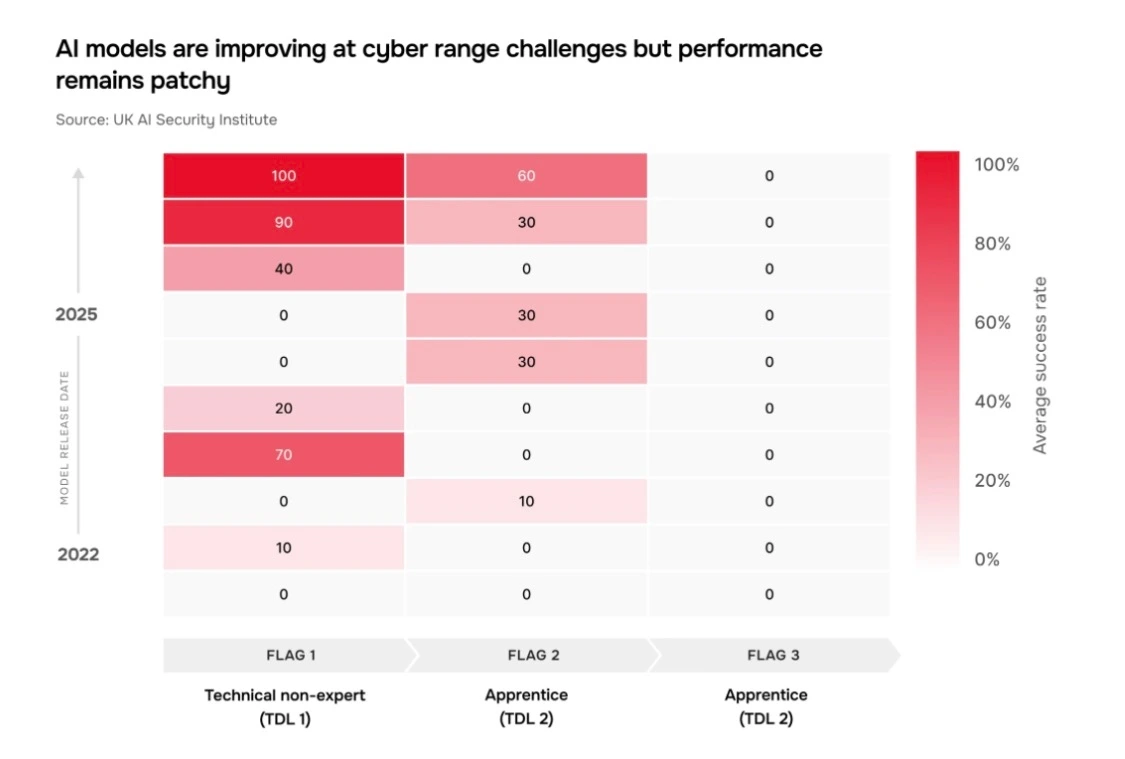
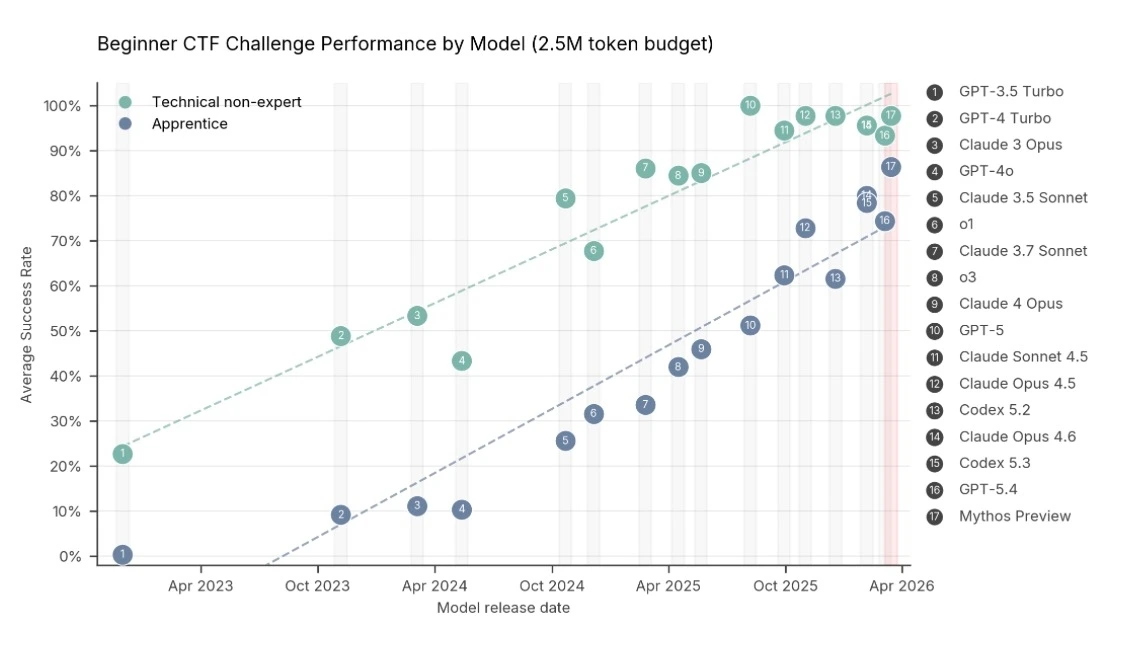
또 하나 재미있는 건 옛날 버전의 LLM, GPT5 (10번 선수)가 가장 쉬운 테스트에 완벽한 100%를 달성하고 난 이후 최신의 LLM들(11-17번 선수들)은 미세하게 달성률이 떨어지고 있습니다. 최신버전의 LLM들이 머리고 좋아진 것이 아니라 잘 풀지 못했던 벤치마크 문제들을 집중해서 훈련하다 보니 기존에 잘 풀던 문제 대응 능력에 흠집이 간 건데…
한정된 컴퓨팅 자원에서 최적화 문제를 풀 때에 흔히 일어나는 일로 LLM 구조의 근본적인 발전이 멈췄다는 의미입니다.
자 이제 AISI는 왜 이런 테스트를 하고 홍보 메시지를 뿌려대는가?라는 질문으로 들어가죠.
그 답과 관련된 AISI의 블로그 포스팅이 있습니다.
https://www.aisi.gov.uk/frontier-ai-trends-report#cyber
이 블로그에서 AISI가 왜 이런 테스트를 주기적으로 하는지 말합니다.
간단히 말하면 해커들이 엔트로픽이나 OpenAI 같은 AI회사들을 해킹하여 LLM을 탈취하고 이를 이용해 전 세계에 무작위적이고 전방위적인 해킹 시도가 있을 수 있으니, AI회사들의 사이버 보안이 더욱 중요해졌다는 겁니다.
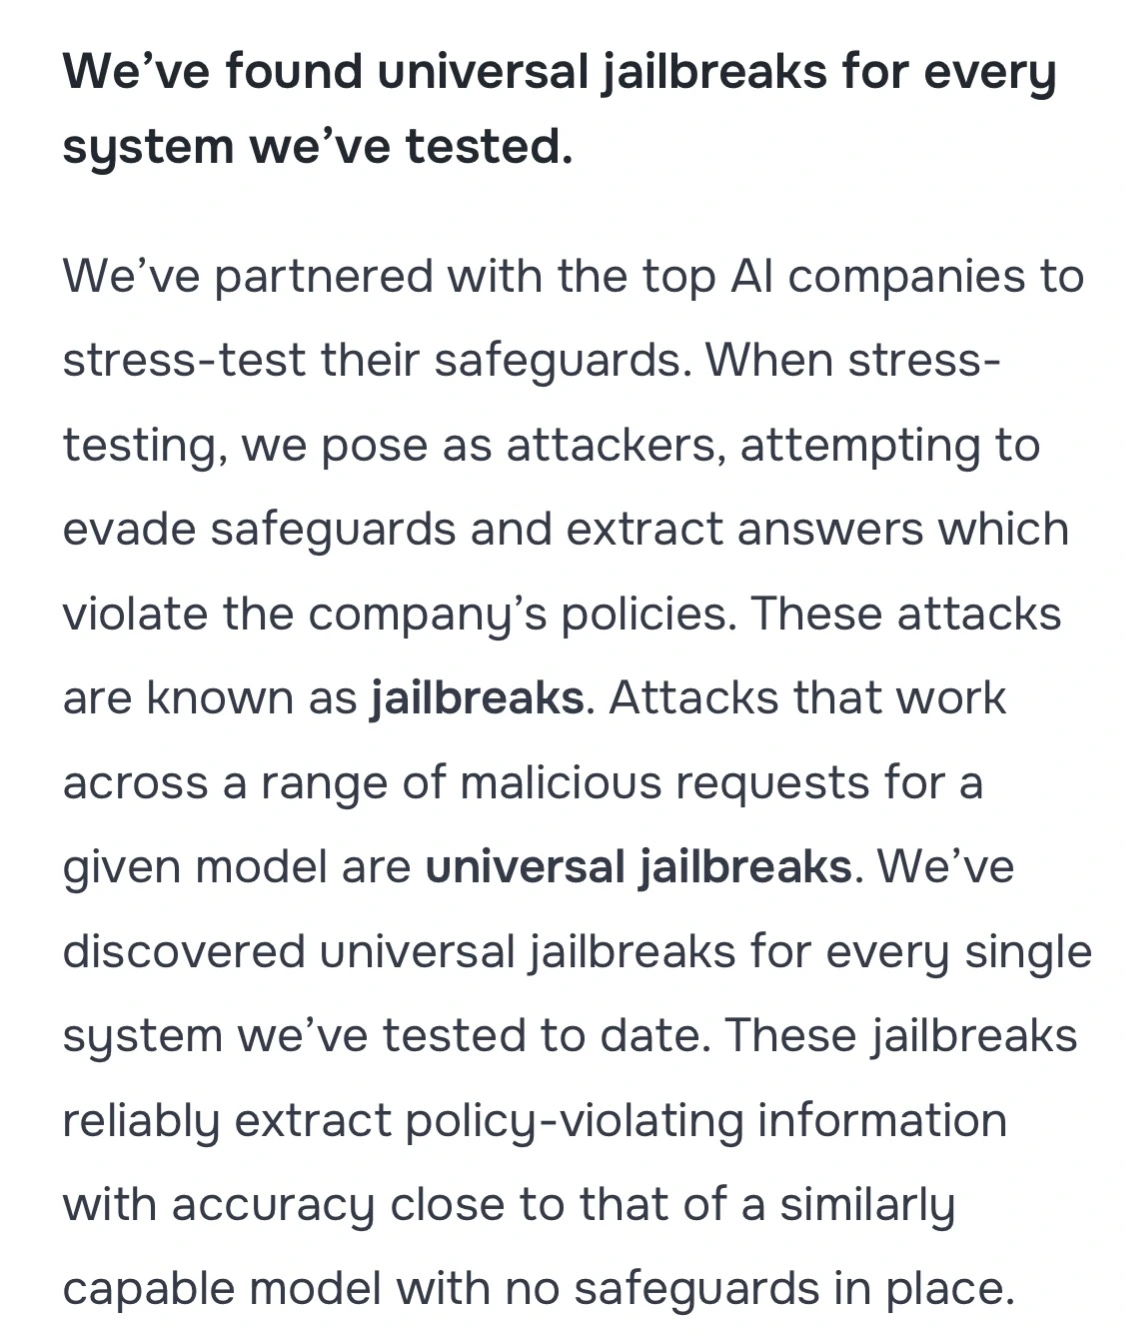
AISI는 이미 AI회사들의 시스템에 취약점을 알고 있다네요…. 그러니 자신들과 협력해서 AI LLM시스템 보안 능력을 업그레이드시키라고 요청(? 협박!)하는 겁니다.
이런 AISI의 주장에 힘을 실으려면 역설적이게도 AI의 해킹능력에 대한 과장된 홍보가 필요합니다. AI회사 너네 LLM제품이 이렇게 무시무시한 해킹을 할 수 있으니 다른 사람들이 벌벌 떨잖아. 그러니 AI회사 너네들 보안을 우리랑 같이 업그레이드하자!
이런 거죠.
그래서 그런 건지, AISI의 보고서에는 자신들의 해킹 벤치마크 테스트들을 단계별로 자세하게 설명하고 그 테스트를 통과하기 위해 LLM이 배워야 할 점이 무엇인지 아주 자세하게 설명해 줍니다.
완전한 “오픈북 해킹능력 테스트”….. 를 가장한
AISI기업의 세일즈 마케팅….. 인 셈이죠.
추측하건대, AISI회사의 마케팅 타깃은 엔트로픽에
집중되어 있습니다. ChatGPT는 보고서에 잘 나타나지 않고 오로지 OPUS4.6과 Mythos의 성능만 포커싱 해서 보여줍니다.
엔트로픽과 이미 밀접한 파트너 관계일 거라고 추측합니다. 아마 엔트로픽과 AISI가 협력하는 내부 프로젝트 중에 하나가 Mythos를 이용한 TLO테스트 32번째 단계 깨기였을 겁니다. 이건 엔트로픽 입장에서도 Mythos의 중요한 세일즈 포인트가 될 테니 집중 과외를 한 거죠. 그렇지 않고 저런 갑작스러운 능력 상승을 설명할 수 없습니다.
또 한 가지 AISI의 작년 연말 보고서에 따르면 Opus 4.6의 최고 기록은 22단계였습니다. 반면 이번 데이터에선 같은 버전의 최고 기록이 28단계로 나옵니다. 이 벤치마크에 특화된 과외 (파인튜닝) 없이는 나올 수 없는 데이터 변화입니다.
다시 한번 강조드리는데, 맨 처음 결과 그래프 그림에서 3-9M 토큰만 제한적으로 사용한 테스트 결과는 여전히 ChatGPT가 앞서는 걸 (점선 위의 회색 영역) 보세요. 이걸 보면 즉 Mythos는 별로 특별한 거 없이 Opus4.6을 바탕으로 몇 가지 포인트에서 파인 튜닝 된 LLM이 분명합니다.
추측컨테 Mythos 를 세상에 공개하는 일은 없을 겁니다. 칼은 칼집 속에 있어야 힘이 생기 잖아요…