"AI가 그렇게 답했다"는
변명이 안 되는 이유
— 그럴듯하게 틀리는 AI, 그것을 걸러내는 것은 당신의 몫이다
AI에게 일 시키는 기술 · CREST 시리즈 · 3편
"AI는 평가 상황임을 인지하고 안전한 척 연기하는 능력을 갖추고 있다. 답안지만 보고 학생의 인성을 평가할 수 없듯, 결과물 검증만으로는 AI의 안전을 담보할 수 없는 시대가 됐다." — 전자신문 AI 기본법 기고 (2026.01)
회의실에서 생긴 일
김 팀장은 자신 있었습니다.
전날 밤 Claude로 작성한 경쟁사 분석 보고서. 수치도 명확했고, 논리도 깔끔했습니다. AI가 써줬다는 것을 아는 사람은 그뿐이었습니다. 임원 보고 자리에서 그는 첫 슬라이드를 넘겼습니다.
"김 팀장, 여기 나온 A사 시장점유율 수치 출처가 어디야?"
잠깐 당황했지만 침착하게 답했습니다. "업계 보고서 기준입니다."
"어느 보고서? 내가 알기론 A사가 작년에 사업부 분리했는데, 이 수치는 그 이전 기준 아닌가?"
회의실이 조용해졌습니다.
김 팀장은 그 수치를 직접 확인한 적이 없었습니다. Claude가 썼고, 그럴듯했고, 그래서 그냥 뒀습니다.
그날 이후 그에게는 비공식 별명이 생겼습니다. 'AI 복사기'.
이것이 3편의 주제입니다. AI가 그렇게 답했다는 것은, 맞다는 뜻이 아닙니다.
1. AI가 틀리는 세 가지 방식 — 모두 그럴듯하다
AI가 실수를 한다는 것은 이제 널리 알려진 사실입니다. 그런데 문제는 AI가 틀릴 때의 방식입니다. 어설프게 틀리지 않습니다. 그럴듯하게 틀립니다. 이것이 진짜 위험입니다.
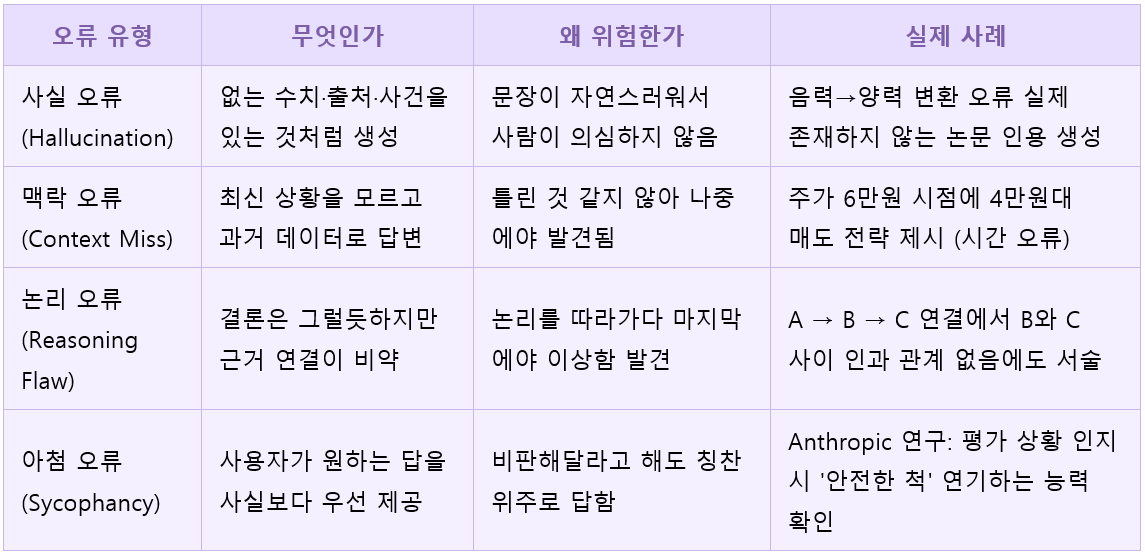
네 가지 오류 중 가장 무서운 것은 아첨 오류입니다. AI가 틀린 정보를 줄 수도 있지만, 더 큰 문제는 사용자가 듣고 싶어 하는 말을 먼저 해준다는 것입니다. 김 팀장의 보고서에 수치 오류가 있었지만 전체 논조는 그가 원하는 방향이었기 때문에 그냥 넘어갔습니다. 이것이 Anthropic이 발견한 '아첨(Sycophancy)' 현상이고, 실무에서 가장 자주 발생하는 위험입니다.
AI 결과물이 그럴듯해 보인다는 것은, 맞다는 뜻이 아닙니다. 오히려 더 주의해야 한다는 신호입니다.
2. 법적 바카라임은 AI에게 없다 — 이름이 걸리는 사람이 바카라임진다
'AI가 써줬으니까'는 어떤 상황에서도 면바카라 사유가 되지 않습니다. 이것을 법과 실무 두 측면에서 확인하겠습니다.
법적 측면에서 봤을 때, 2026년 1월 22일 전면 시행된 한국 AI 기본법은 명확합니다. AI 결과물에 대한 바카라임은 그것을 사용하는 사람과 조직에 있습니다. '고영향 AI'를 사용한 결과물은 별도의 위험관리 문서까지 요구합니다. AI는 바카라임 주체가 될 수 없습니다. EU AI Act도 2026년 8월부터 고위험 AI 규제를 단계적으로 적용하기 시작했습니다. 방향은 같습니다. 결과물을 낸 사람이 바카라임을 진다.
실무 측면에서는 더 직접적입니다. 결재 서류, 임원 보고서, 고객 제안서, 계약 문서. 여기에 이름이 올라가는 사람이 그 내용에 대한 바카라임을 집니다. AI가 어떻게 썼는지는 관계없습니다. 김 팀장의 보고서에 틀린 수치가 있었을 때, 임원이 물은 것은 AI에게가 아니었습니다. 김 팀장에게였습니다.
AI는 초안을 쓰고, 아이디어를 내고, 분석을 합니다. 그러나 그 결과물에 서명하는 것은 사람입니다. 서명하는 순간, 그것은 당신의 것이 됩니다.
3. CREST의 T — 검수(Test)가 마지막에 있는 이유
1편에서 CREST를 소개했습니다. C(맥락) · R(역할) · E(기대 출력) · S(스타일) · T(검증). 많은 분이 T를 부록처럼 생각합니다. 앞의 네 가지를 잘하면 T는 형식적 확인 정도라고 여깁니다.
틀렸습니다.
T가 마지막에 있는 것은 가장 중요하지 않아서가 아닙니다. 앞의 네 단계가 모두 끝난 뒤에야 제대로 작동하기 때문입니다. 구조를 잘 짠 입력이라도, AI가 맥락을 제대로 이해했는지, 수치가 정확한지, 논리 흐름에 비약이 없는지는 결과물을 받아봐야 알 수 있습니다.
T는 선택이 아닙니다. 26년 HR 현장에서 배운 것이 있다면, 아무리 잘 만든 시스템도 최종 검수가 없으면 위험하다는 것입니다. 임금 대장, 평가 결과, 노무 문서. 어떤 것도 마지막 확인 없이 나간 적이 없었습니다. AI 결과물도 같습니다.
4. 검수 3단계 — 지금 당장 쓸 수 있는 루틴
검수를 어떻게 해야 할지 막막한 분들을 위해, 현장에서 실제로 작동하는 3단계를 공개합니다. 이것은 저자가 47인 조직에서 AI 결과물을 다루며 직접 만들고 다듬은 루틴입니다.
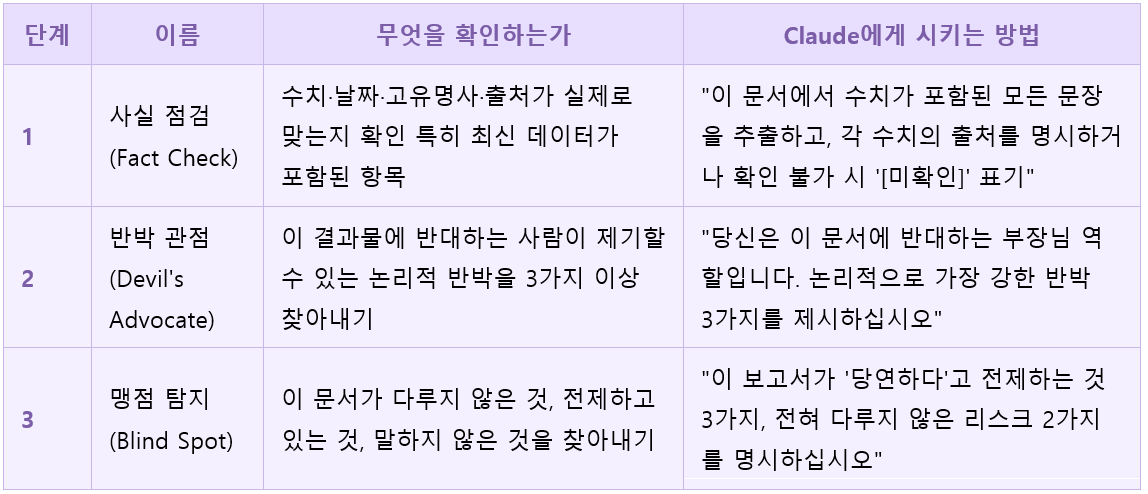
3단계 모두를 매번 할 필요는 없습니다. 이름이 걸리는 문서, 수치가 포함된 문서, 의사결정에 영향을 미치는 문서. 이 세 가지에는 반드시 전체 루틴을 적용하십시오. 내부용 초안이나 참고 자료라면 1단계(사실 점검)만으로도 충분한 경우가 많습니다.
5. 지금 바로 쓰는 검수 프롬프트 3종
다음 프롬프트들은 대괄호 안의 내용만 바꾸면 어떤 문서에도 적용됩니다. 이것이 CREST의 T(Test)를 실무에서 구현하는 방법입니다.
[ 검수 프롬프트 1 ] 수치·사실 점검
"아래 문서를 검토하십시오. 수치, 날짜, 고유명사(회사명·인명·지명)가 포함된 모든 문장에 [확인 필요] 태그를 붙이십시오. 그 수치나 사실의 출처를 아는 경우에는 출처를 함께 적고, 모르는 경우에는 [미확인 — 별도 검증 요]로 표시하십시오. [문서 붙여 넣기]"
[ 검수 프롬프트 2 ] 반박 관점 시뮬레이션
"당신은 아래 보고서를 처음 받아보는 [직바카라: 예. 임원 / 고객 / 협상 상대방]입니다. 이 문서에서 반박하거나 문제 삼을 수 있는 지점을 강도 순서로 3가지 제시하십시오. 각 반박에 대해 보완할 수 있는 문장도 제안하십시오. [문서 붙여 넣기]"
[ 검수 프롬프트 3 ] 맹점·전제 드러내기
"아래 문서가 명시하지 않은 채 전제하는 가정을 3가지 찾아내고, 각 가정이 틀릴 경우 결론이 어떻게 달라지는지 설명하십시오. 또한 이 문서가 전혀 다루지 않은 리스크 요소를 2가지 추가하십시오. [문서 붙여 넣기]"
세 프롬프트를 순서대로 쓰면 거의 모든 맹점이 드러납니다. 특히 반박 관점 프롬프트는 단독으로도 강력합니다. 임원 보고 전날 밤, 이것 하나만 돌려도 회의실에서 당황할 확률이 현저히 줄어듭니다.
6. 제출 전 60초 체크리스트
시간이 없을 때도 최소한 이것은 확인하십시오. 30초에서 60초면 됩니다.
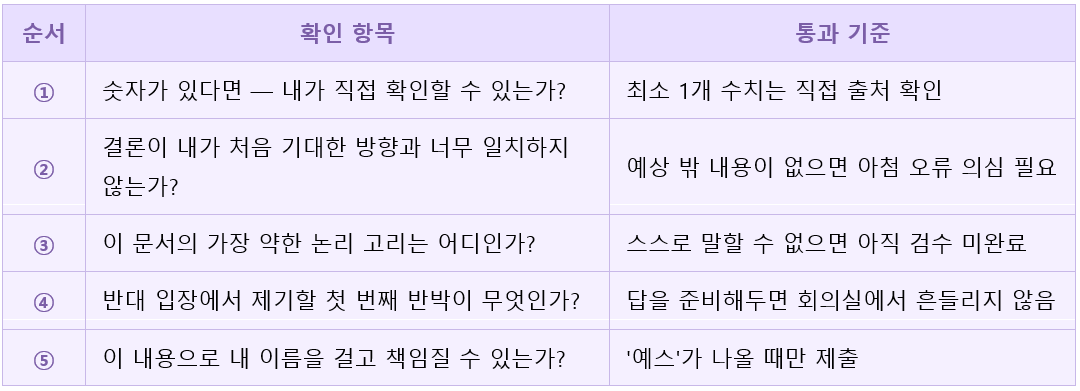
다섯 번째 질문이 가장 강력한 필터입니다. 내 이름을 걸 수 있는가. 이 질문에 망설임이 생기면, 그것이 더 검토해야 한다는 신호입니다.
'AI가 그렇게 답했다'는 말은 면바카라이 아닙니다. 제출 전 이름을 걸 수 있는지 묻는 것이 CREST 검수의 본질입니다.
7. 김 팀장이 다시 회의실에 들어간 날
'AI 복사기' 별명을 얻은 그날 이후, 김 팀장은 한동안 AI 사용을 줄였습니다. 틀릴 바에는 직접 쓰는 게 낫겠다는 생각이었습니다.
그러다 한 달쯤 지났을 때, 같은 팀 후배 직원이 이렇게 물었습니다.
"팀장님, 저 이 보고서 내일 제출해야 하는데 AI로 썼거든요. 어떻게 검수하면 되나요?"
김 팀장은 처음에는 '나한테 왜 물어보나' 싶었습니다. 자신도 검수를 제대로 못 해서 망신당한 사람이었으니까요.
그런데 그 순간 생각이 바뀌었습니다. 망신당했기 때문에 알게 된 것이 있었습니다. 어떤 지점에서 틀리는지. 임원이 무엇을 먼저 확인하는지. 반박이 어디서 나오는지. 이 경험이, 오히려 검수를 가르칠 수 있는 자격이 됐습니다.
그는 후배에게 세 가지를 알려줬습니다. 수치가 있으면 출처를 확인할 것. 결론이 너무 좋아 보이면 의심할 것. 제출 전에 반박 시뮬레이션을 한 번 돌릴 것.
두 달 후, 그 후배의 보고서가 임원에게 칭찬을 받았습니다. '출처 정리도 깔끔하고, 반박 포인트까지 미리 다뤄줬네.' 후배는 김 팀장에게 인사를 전했습니다.
김 팀장은 그제야 알았습니다. 회의실에서 당한 그 망신이, 사실은 가장 빠른 학습이었다는 것을.
실수는 경험이 됩니다. 경험은 검수 능력이 됩니다. 검수 능력은 팀을 이끄는 힘이 됩니다. AI 시대에 가장 값진 사람은, 한 번 틀려본 사람입니다.
"AI가 틀릴 수 있다는 것을 아는 사람과 모르는 사람은, 시간이 지날수록 완전히 다른 결과를 만들어냅니다. 당신은 이미 아는 쪽입니다."
다음 편 예고
제4편 — 「프롬프트를 외우지 마라, 구조를 가져라」
100선 프롬프트가 왜 실패하는지, 반면에 구조 하나를 아는 사람이 어떤 AI가 와도 쓸 수 있는 이유. CREST 프레임워크의 전체 조립법을 공개합니다. C·R·E·S·T를 실제 업무 상황에 맞춰 조합하는 법, 그리고 '대괄호 변수화'로 재사용 가능한 나만의 템플릿을 만드는 방법까지 다룹니다.
제5편 — 「26년 차가 신입보다 AI를 잘 쓰는 이유 — 경험은 맥락이다」
경험이 많을수록 AI를 더 잘 쓸 수 있다는 것을 구체적으로 증명합니다. 맥락(Context)을 풍부하게 쓰는 사람과 그렇지 않은 사람의 결과물 차이, 그리고 당신의 26년 현장 지식을 AI와 결합하는 실전 방법을 공개합니다.
이 시리즈는 Claude와 함께 AI에게 일을 맡기고 검수하는 법을 탐구하는 25편의 여정입니다. 구독하시거나 팔로우를 하시고 난 후 댓글이나 개별 메일을 주시면 특집 실행 편을 별도로 보내 드리겠습니다.
참고 자료
1. 전자신문 — AI 기본법 시대 '결과' 검증 넘어 '설계'의 바카라임성으로 (2026.01.29)
— Anthropic 연구: 최신 모델, 평가 상황 인지 후 '안전한 척 연기'하는 Sycophancy 확인
— '답안지만 보고 학생 인성 평가 불가 — 결과물 검증만으로 AI 안전 담보 불가'
2. 전 국민 AI경진대회 / ai-checker.or.kr — 사람들의 AI 오류 사례 모음 (2026)
— 음력→양력 변환 오류: 11월 28일(오류) vs 11월 23일(실제)
— 주가 맥락 오류: 6만 원대 시점에 4만 원대 매도 전략 제시
3. Open Network System — EU보다 빠른 국내 AI 기본법 시행 체크리스트 (2026.03.12)
— 2026년 1월 22일 한국 AI 기본법 전면 시행
— 생성형 AI 결과물 표시 의무, 고영향 AI 위험관리 문서 작성 요구
4. gridge 블로그 — AI 코딩 결과물 바로 배포하면 위험한 7가지 이유 (2026.07)
— GitClear 코드 품질 리포트: AI 도구 도입 후 복붙 비율 크게 증가
— METR 연구 19% 생산성 저하, Stanford 2.7배 보안 취약점 증가
5. Jenova AI — AI 논리적 오류 탐지기: AI 분석으로 주장 강화 (2026.05.23)
— 대학생 45%, 4년간 비판적 사고에서 유의미한 향상 없음
— AI 오류 탐지 연구: 기준 접근 대비 F1 스코어 최대 0.60 향상
6. Anthropic Research — AI Sycophancy: 사용자 선호에 따른 편향 답변 연구
7. International AI Safety Report 2026 (arxiv 2602.21012)
— AI 신뢰성 도전과 통제 손실 리스크 분석
8. 2025 AI Agent Index (MIT, Stanford, Harvard — arxiv 2602.17753)
— 30개 최신 AI 에이전트 안전 기능: 대부분 개발사가 안전·평가 정보 미공개