<원숭이 엉덩이는 빨간 세계관>
모스 부호에서 세계관 좌표계까지
전제 : 이 글은 <제5차 컬트 커뮤니티의 시대>에 대한 기술적 지원입니다.
들어가는 글 : 유튜브에서 시작된 이상한 호기심
어느 날 저녁 유튜브 알고리즘에 끌려 모스 부호를 고속으로 치는 무선 통신사들의 영상을 보게 되었습니다. 신들린 손가락으로 전건을 두드리는 숏폼이었습니다.
그 장면을 보다가 질문 하나가 떠올랐습니다.
저 숙련자들은 들려오는 소리를 머릿속에서 S, O, S라는 알파벳으로 바꾼 다음 뜻을 이해하는 걸까. 아니면 저 소리 패턴 자체가 곧바로 의미로 꽂히는 걸까.
이 질문이 모스 부호에서 출발해 기계 통신을 거쳐 AI의 잠재 공간까지 이어졌습니다. 그리고 제가 십 년 넘게 해온 세계관 작업의 고질적인 문제와 만났습니다.
그리고 이전 페이스북의 글.
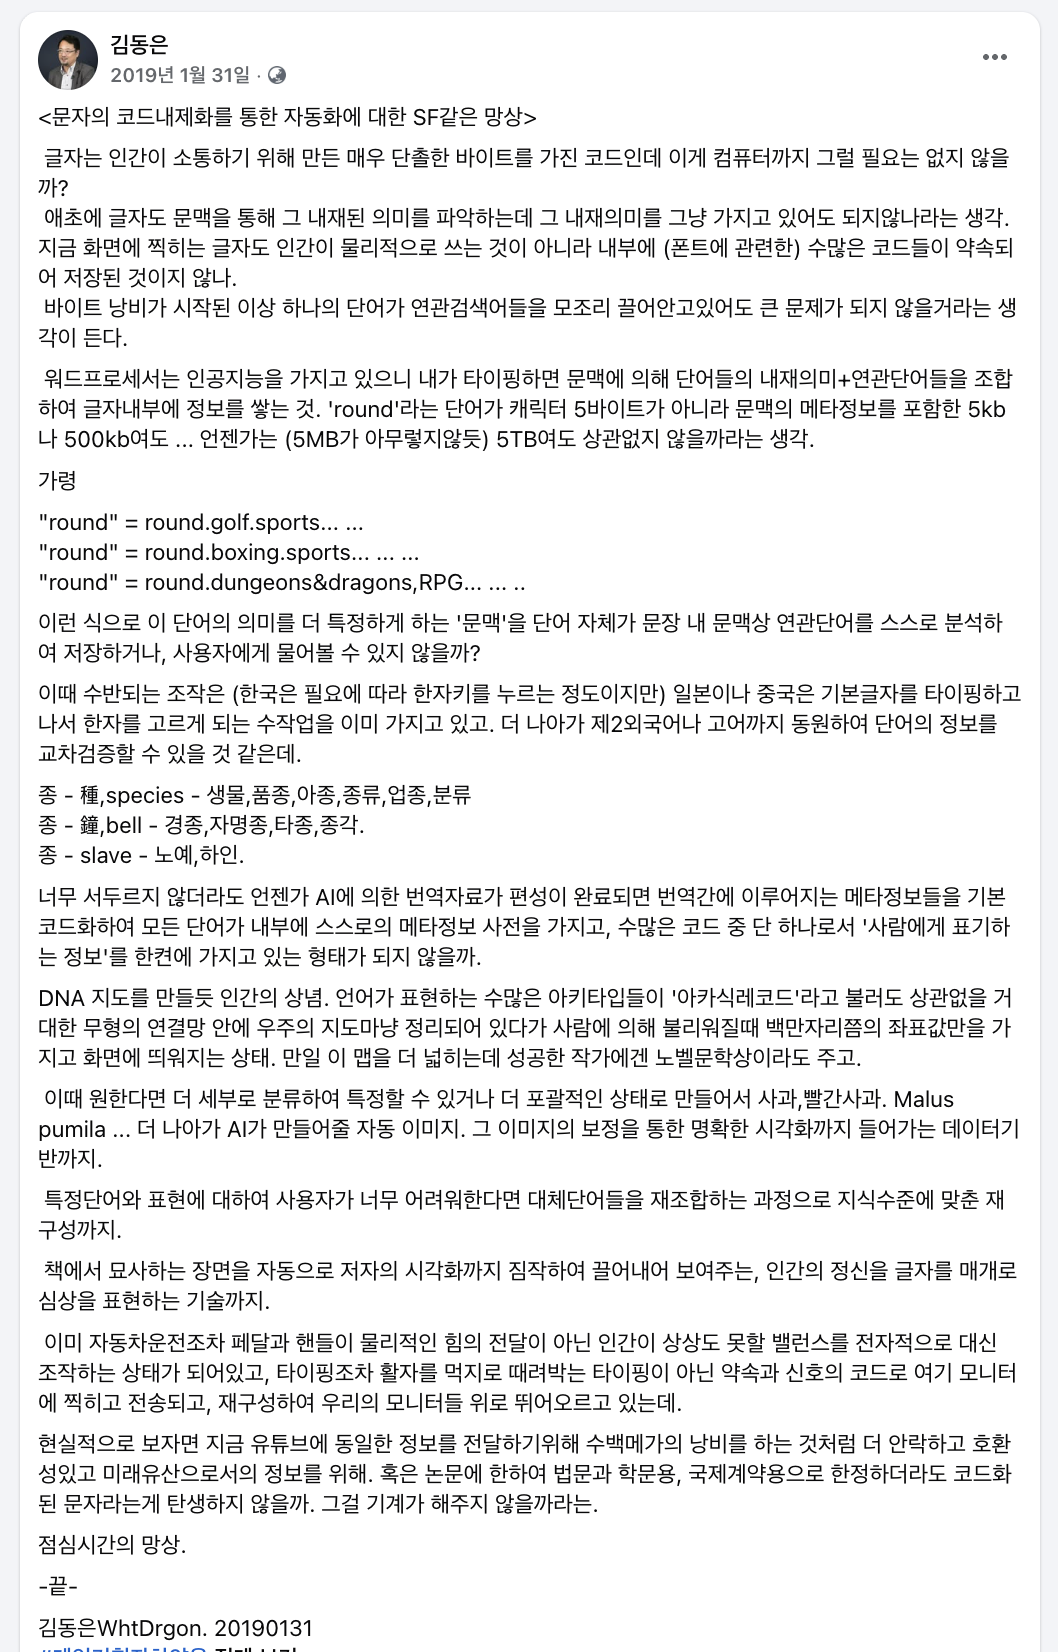
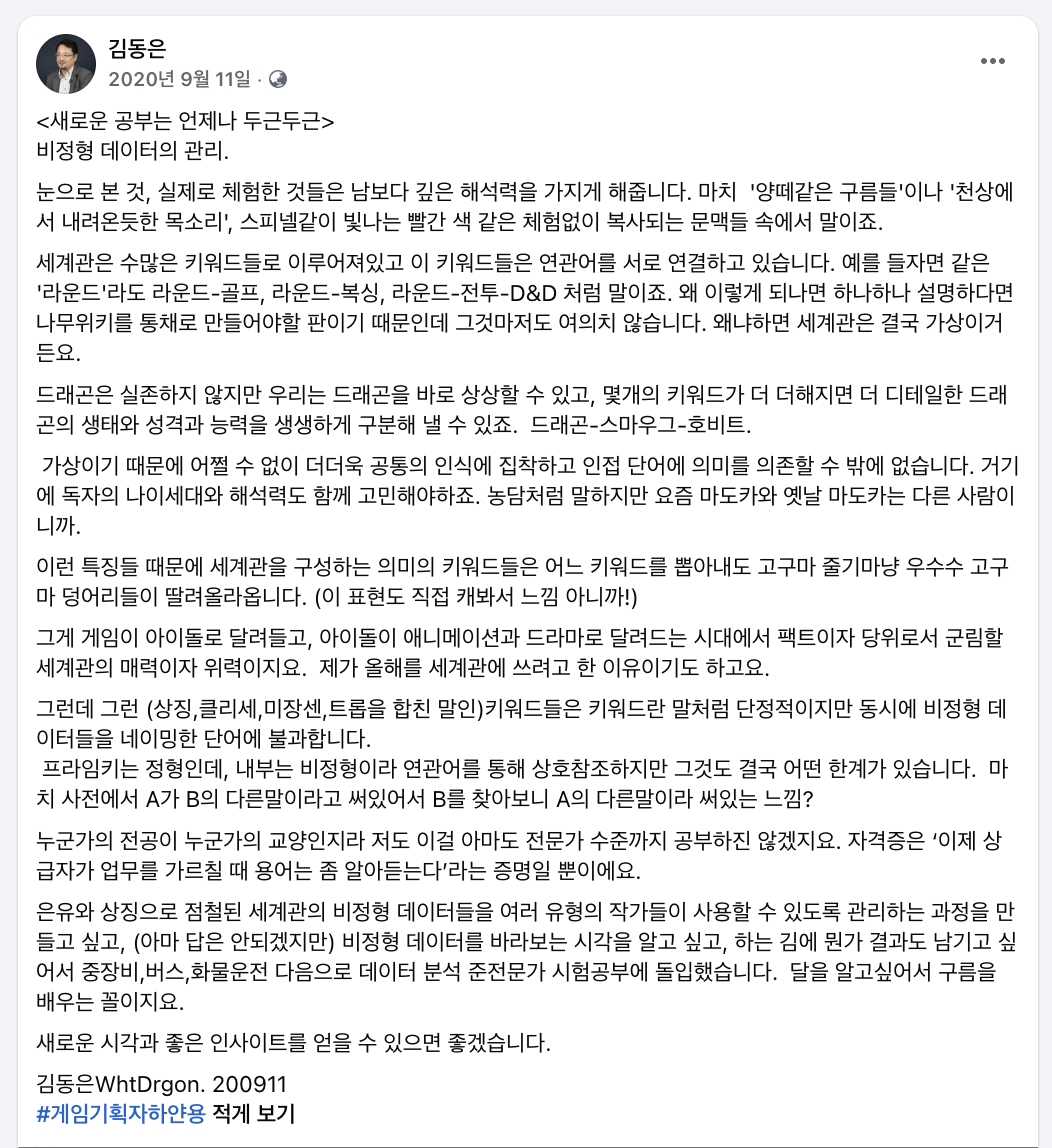
1. 문자를 거치지 않는 이해
제가 처음 모스 부호를 접한 것은 타이타닉의 SOS였습니다. 이걸 들으면 머릿속에서 세 단계를 거칩니다: 소리, 문자, 의미.
그런데 고속 통신 영상에서는 눈으로 따라가기도 힘든 속도로 부호가 나갑니다. 저 속도로 알파벳을 하나씩 복호화하는 것은 불가능합니다.
실제로 숙련된 무선사들은 문자를 거치지 않습니다. 아마추어 무선에서는 이를 헤드 카피라고 부릅니다.
헤드 카피 (Head Copying) : 받아 적거나 알파벳으로 옮기지 않고, 들리는 리듬과 음조만으로 즉시 의미를 파악하는 상태.
인지심리학에서는 청킹으로 설명합니다. 개별 점과 선을 읽는 것이 아니라 소리 덩어리 하나를 통째로 의미와 연결하는 것입니다.
여기서 두 번째 질문이 나왔습니다.
사람도 숙련되면 문자를 버리고 소리로 직접 소통합니다. 그렇다면 기계끼리는 왜 굳이 인간의 문자로 번역해서 대화해야 할까요.
2. 기계는 이미 문자를 잘 안 씁니다
서버끼리
서버 사이에 "apple": "red" 같은 텍스트가 오갈 것 같지만, 성능이 중요한 시스템에서는 Protobuf나 CBOR을 씁니다.
Protobuf : 미리 약속한 설계도를 양쪽이 공유해 두고, 필드 번호와 값만 이진 데이터로 주고받는 직렬화 방식.
"사과"라는 글자를 보내지 않습니다. 100번 필드에 해당하는 이진 신호만 보냅니다. 받는 쪽은 글자를 읽지 않고 곧바로 해당 자리에 값을 넣습니다.
모델 안에서
AI 모델 내부에서도 벡터를 그대로 다루는 대신 번호로 다루는 기법이 있습니다.
VQ-VAE의 코드북 : 연속적인 잠재 공간을 유한한 개수의 대표 벡터로 나누어 만든 자체 사전. 사전이 있으면 데이터를 벡터가 아니라 사전 번호로 다룰 수 있습니다.
모델이 세상을 학습하면서 402번 = 붉은색 + 둥근 형태 + 유기물 같은 항목을 스스로 만드는 셈입니다.
공통점
세 가지 모두 같은 구조입니다.
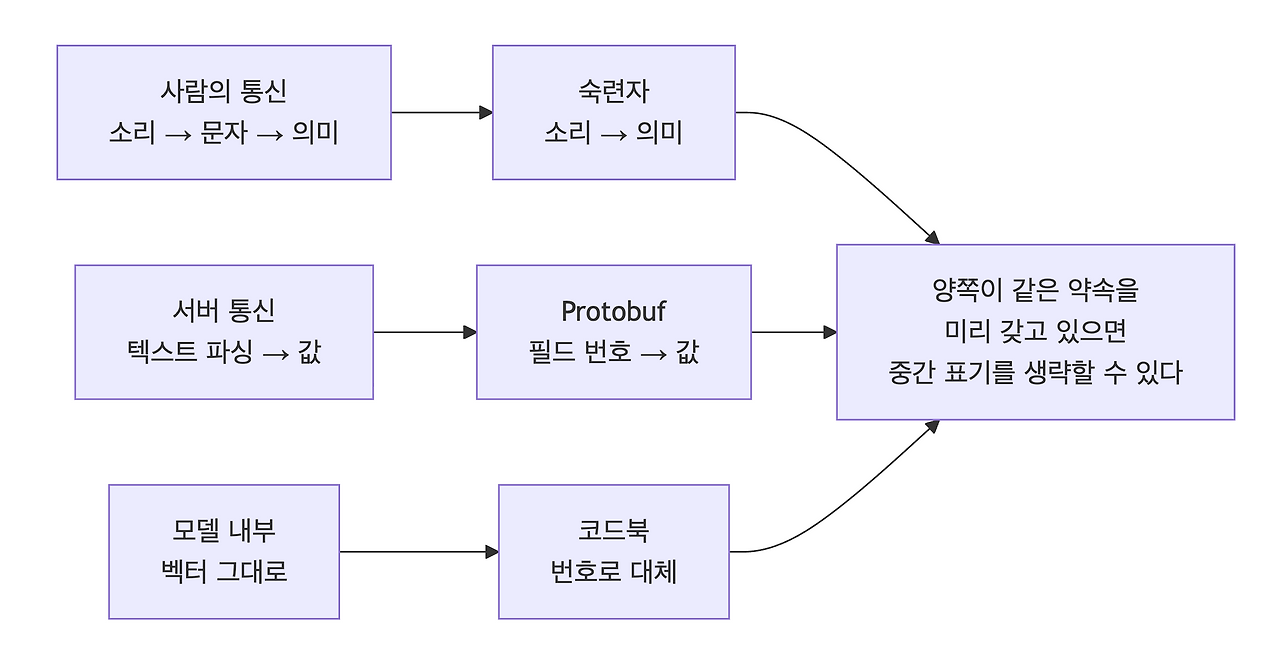
문자는 약속이 없는 상대와 통하기 위한 장치입니다. 약속이 있으면 생략됩니다.
3. 약속이 없는 상대라면
문제는 여기서 시작됩니다.
같은 모델의 복제본끼리는 좌표계가 같습니다. 402번은 양쪽에서 같은 것을 가리킵니다. 하지만 서로 다른 모델은 다릅니다. A 모델의 402번과 B 모델의 402번은 아무 관계가 없습니다.
사람도 마찬가지입니다. 사과를 기억하는 뉴런의 물리적 위치는 사람마다 다릅니다. 그래서 우리는 "사과"라는 단어를 씁니다. 단어는 서로 다른 뇌를 잇는 중계기입니다.
그렇다면 서로 다른 AI를 이으려면 문자가 반드시 필요할까요.
여기서 떠오른 것이 스무고개였습니다.
사과라는 단어를 보내는 대신 기준점 스무 개를 정해두고 그 기준점들과의 거리만 보냅니다. 받는 쪽은 자기 공간에서 같은 기준점들을 찾아 거리를 맞춰보고 교점을 찍습니다.
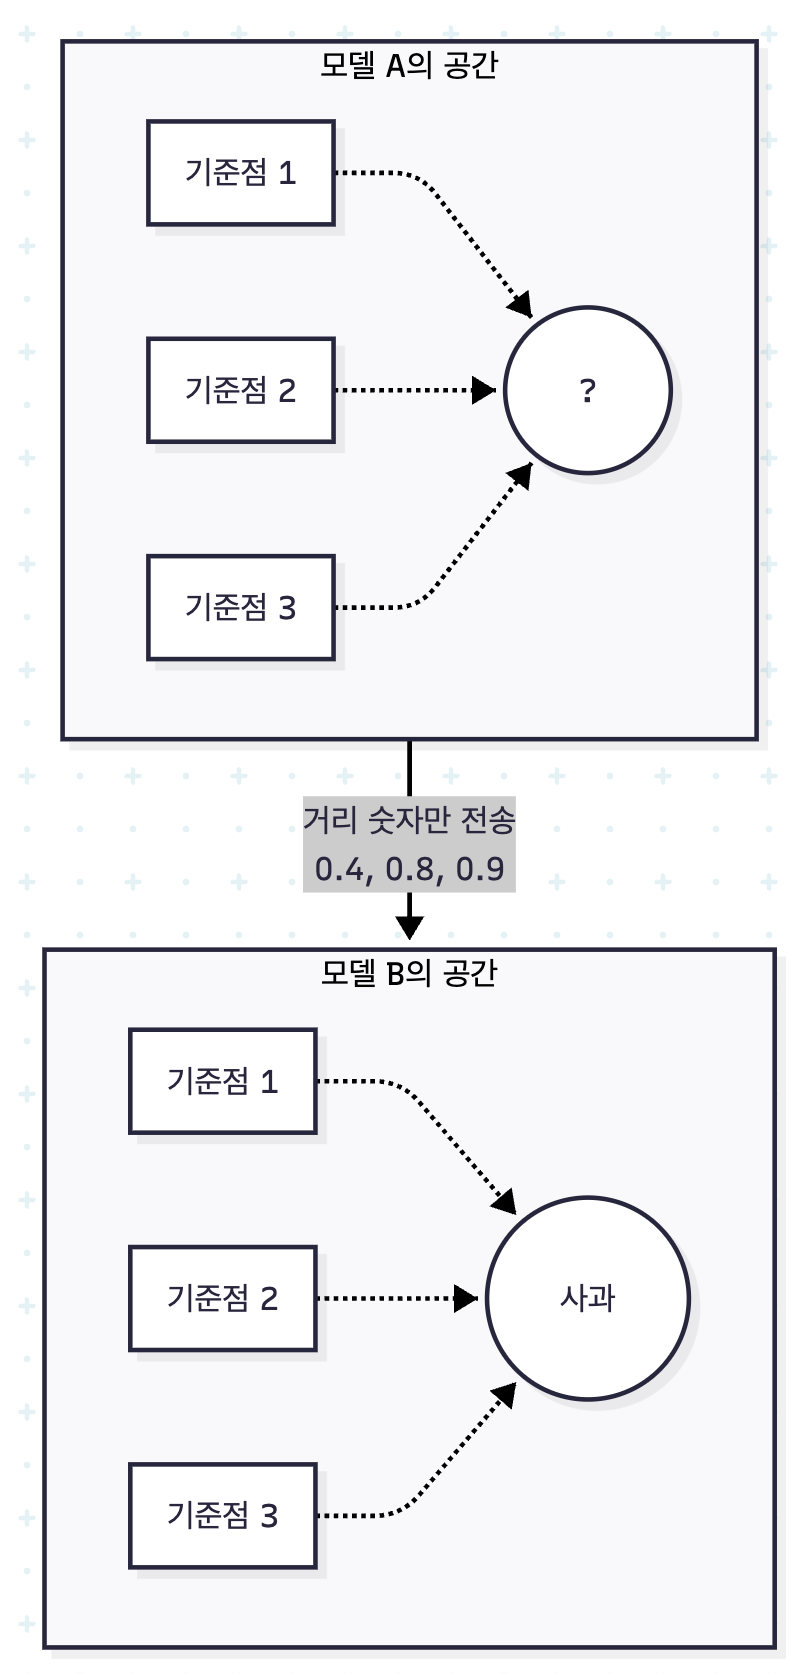
절대 좌표는 다릅니다. 하지만 기준점과의 관계는 유지됩니다. 그러면 좌표계가 달라도 지목이 됩니다.
정확히 한 점에 꽂히지는 않습니다. 교점 근처에 근사로 찍히고 그중 가장 가까운 것을 집는 방식입니다.
4. 이미 나와 있던 답
이 발상을 정리하고 찾아보니 이미 논문이 있었습니다. 2022년에 나온 상대 표상이라는 개념입니다.
상대 표상 (Relative Representation) : 각 데이터를 절대 좌표가 아니라 미리 정한 기준 샘플들과의 유사도 목록으로 표현하는 방식. 절대 좌표는 학습할 때마다 달라지지만 기준점과의 관계는 유지된다는 관찰에 기반합니다.
여기에 짝이 되는 가설이 있습니다.
플라토닉 표상 가설 (Platonic Representation Hypothesis) : 서로 다른 모델이라도 같은 세계를 학습하면 내부 공간의 구조가 비슷한 모양으로 수렴한다는 가설. 가설이며 증명된 정리가 아닙니다.
이 둘을 합치면 재학습 없이 서로 다른 모델의 부품을 이어 붙이는 일이 가능해집니다. 여러 연구팀이 성공 사례를 보고했습니다.
세계관 작업을 오래 하면 이 자리에 도착하게 됩니다. 설정이란 결국 개념들 사이의 관계 목록이기 때문입니다. 저는 그걸 문서로 적어 왔고 연구자들은 그걸 좌표로 적었습니다.
5. 조건 : 기준점은 이름으로 약속할 수 없습니다
여기에 반드시 지켜야 할 조건이 하나 있습니다.
기준점은 개념 이름으로 합의할 수 없습니다. 실제 데이터여야 합니다. 두 모델이 같은 입력물을 각자 처리해서 각자의 좌표를 미리 만들어 두어야 합니다. 이것을 병렬 앵커라고 부릅니다.
"태양"이라는 단어를 약속하는 것으로는 부족합니다. 정확히 같은 문장, 같은 이미지, 같은 샘플을 양쪽에 통과시켜야 기준점이 맞물립니다.
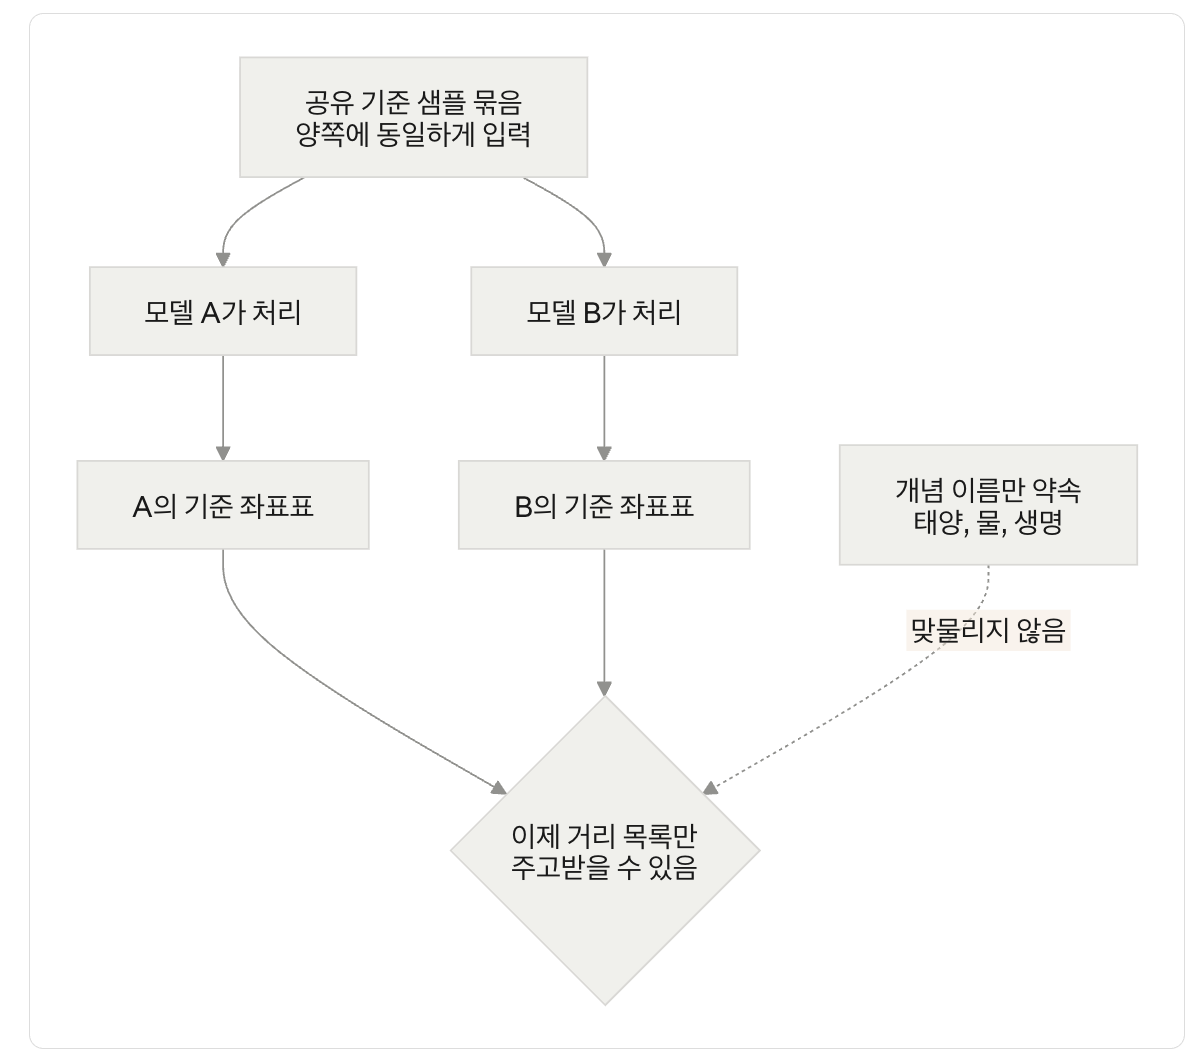
연구자들은 이 병렬 앵커를 확보하기 어렵다는 점을 한계로 꼽습니다. 소수의 씨앗에서 나머지를 찾아내는 방법이 별도로 연구되고 있을 정도입니다.
세계관 작업에서는 사정이 다릅니다. 공유 샘플 묶음이 이미 있습니다. 설정 키워드 4,000여 개가 그것입니다. 범용 기준점을 만들 필요가 없습니다. 그 세계관 전용 기준점이면 충분하고, 오히려 그편이 정확합니다.
6. 기준점이 몇 개나 필요한가
여기서 실제 숫자가 필요합니다. 계산해 볼 수 있습니다.
무엇이 개수를 결정하는가
네 가지입니다.
N : 서로 구분해야 할 개념의 수. 세계관 키워드 총량입니다.
ε : 허용 오차. 거리 관계가 얼마나 뭉개져도 되는지입니다.
d : 개념들이 실제로 퍼져 있는 방향의 수. 겉보기 차원이 아니라 실제로 쓰이는 차원입니다.
s : 두 모델 사이에 원래부터 존재하는 불일치. 아무리 앵커를 늘려도 남는 바닥값입니다.
공간이 1만 차원이라는 사실은 여기에 들어가지 않습니다. 겉보기 차원은 개수를 결정하지 않습니다.
상한 추산
N개의 점 사이 거리 관계를 오차 ε 안에서 보존하려면 몇 개의 축이 필요한가. 이 질문에는 이미 알려진 답이 있습니다.
Johnson-Lindenstrauss 경계 : N개의 점을 저차원으로 옮길 때, 모든 점 쌍의 거리를 (1±ε) 범위로 유지하는 데 필요한 축의 수는 대략 log N에 비례합니다.
세계관 키워드 4,000개를 넣으면 이렇게 나옵니다.
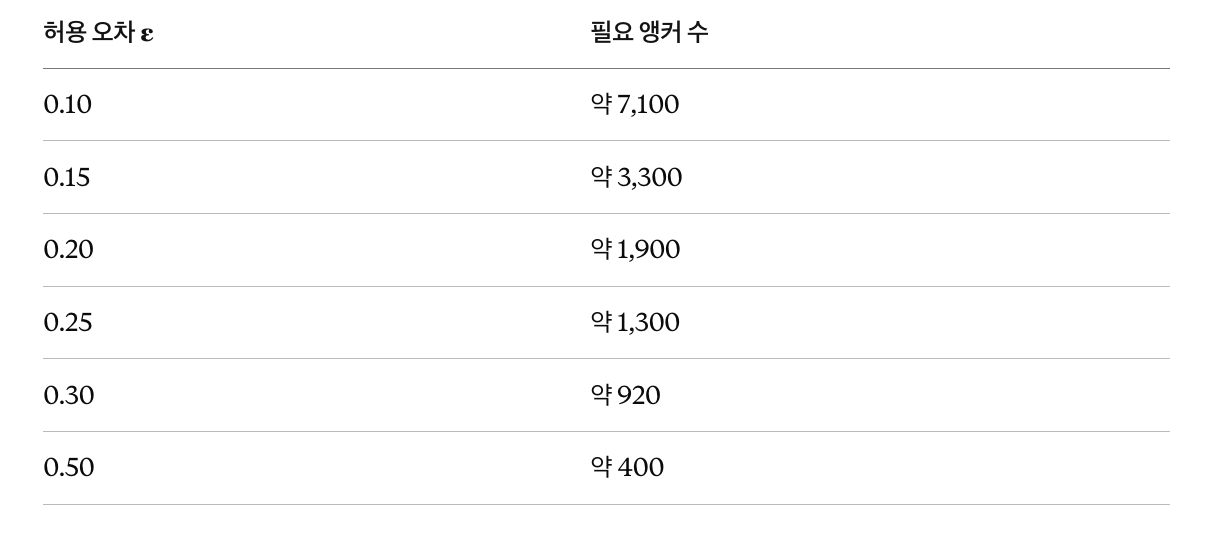
이 경계는 최악의 경우를 가정한 보수적인 값입니다. 실제로는 이보다 적게 들어갑니다. 그래도 자릿수는 알려 줍니다: 세계관 규모에서는 수백에서 이천 사이입니다.
하한 추산
반대쪽에서도 짚을 수 있습니다. 앵커 수가 개념들이 실제로 퍼져 있는 방향의 수보다 적으면 구조 자체가 잡히지 않습니다. 문장 임베딩의 실제 사용 차원은 보통 수십 개 수준으로 보고됩니다. 여기에 잡음을 견딜 여유를 곱하면 하한은 수백 개입니다.
정리하면
하한 : 수백 개
상한 : 약 2,000개
실무 시작점 : 500개 정도에서 출발해 늘려 가며 포화 지점 확인
2,000이라는 숫자는 이렇게 나옵니다. 세계관 키워드 4,000개를 오차 20% 안에서 구분하기 위한 보수적 상한입니다.
로그가 알려 주는 것
이 경계에서 가장 중요한 성질은 앵커 수가 N에 비례하지 않고 log N에 비례한다는 점입니다.
키워드를 4,000개에서 8,000개로 두 배 늘리면 필요한 앵커는 약 8% 늘어납니다. 40,000개로 열 배 늘려도 약 28% 늘어납니다.
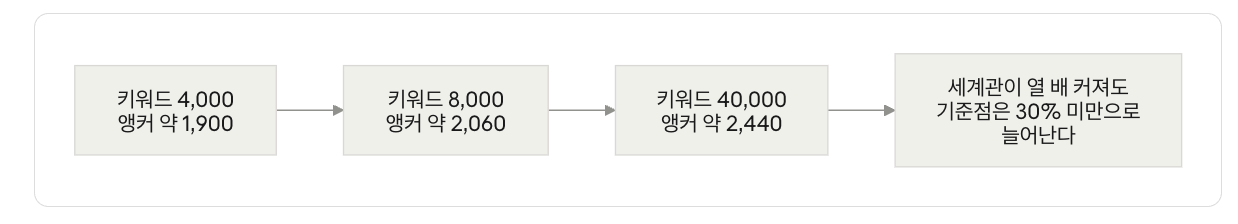
세계관을 설계하다 보면 어느 시점부터 새 키워드가 새 방향을 만들지 않고 기존 구조 안으로 들어오기 시작합니다. 저는 그 감각을 "안으로 감아드는 느낌"이라고 적어 왔습니다. 위 성질이 그 감각의 근거입니다. 세계가 커질수록 관계 자체는 조밀해지지만 그 관계를 지탱하는 기둥의 수는 거의 늘지 않습니다.
세계관이 어느 크기를 넘으면 오히려 관리가 쉬워지는 이유이기도 합니다.
7. 없는 개념은 보낼 수 없습니다. 자리는 보낼 수 있습니다
이 방식으로 아무도 모르는 개념을 보낼 수 있을까요. 이세계의 무언가, 예를 들면 선악과 같은 것을 좌표로 포위해서 쏘면 상대 모델의 공간에 그 개념이 생길까요.
생기지 않습니다. 삼각 측량은 이미 있는 지점을 지목하는 기술입니다. 받는 모델의 공간에 그 개념이 없으면 좌표를 아무리 정확히 찍어도 그 자리에는 아무것도 없습니다.
그런데 여기서 방향을 조금 돌리면 다른 것이 나옵니다.
개념은 못 보냅니다. 하지만 개념이 있어야 할 자리는 보낼 수 있습니다.
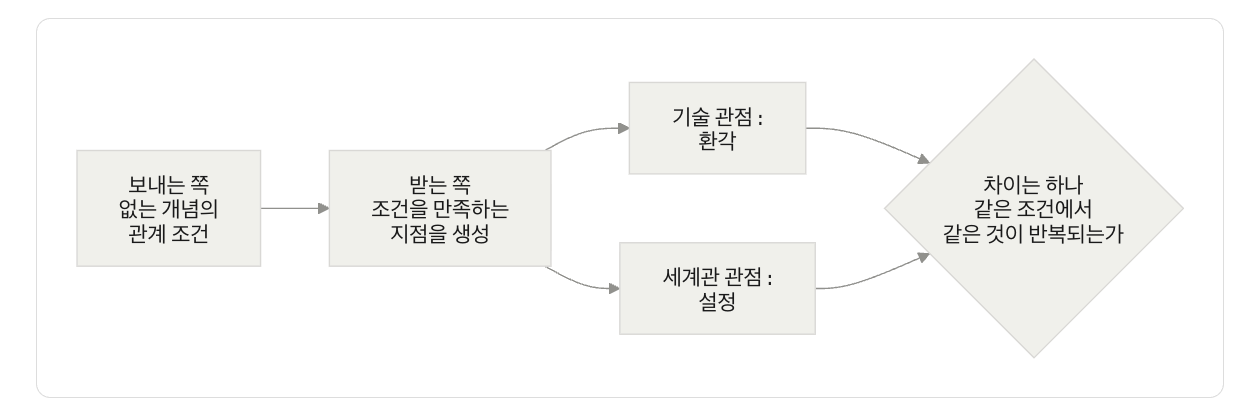
받는 모델에게 이렇게 말하는 셈입니다. 금기와 이만큼 가깝고, 지식과 이만큼 가깝고, 과실과 이만큼 가까운 무언가가 있다. 그 모델의 공간에 선악과가 없어도, 그 조건을 만족하는 무언가를 생성하기 시작합니다.
빈 자리를 지목받은 모델이 그 자리를 채우려고 만들어내는 것. 이것이 정확히 환각입니다.
여기가 이 글의 핵심입니다. 기술적으로는 환각이지만, 그 환각이 같은 좌표에서 반복되는 순간 설정이 됩니다. 개인의 착각과 공동체의 교리를 가르는 것도 정확히 이 지점입니다. 한 번 떠오른 것은 착각이고, 여러 번 같은 자리에서 같은 것이 떠오르면 코드가 됩니다.
기술적으로는 환각이지만, 컬트에게는 코드가 됩니다.
세계관 작업이 필요로 하는 것도 딱 이 정도입니다. 선악과가 상대 모델의 머릿속에 실재할 필요는 없습니다. 상대 모델이 선악과에 대해 매번 일관되게 쓰기만 하면 됩니다.
8. 원숭이 엉덩이 노래
제목으로 삼은 그 노래입니다.
원숭이 엉덩이는 빨개, 빨가면 사과, 사과는 맛있어, 맛있으면 바나나, 바나나는 길어, 길면 기차, 기차는 빨라, 빠르면 비행기, 비행기는 높아, 높으면 백두산.
이 노래는 독자들의 인접세계관에 의지한 직관적 비유일 뿐 엄격히 말하자면, 지금까지 설명한 방식과 정반대의 구조를 갖고 있습니다.
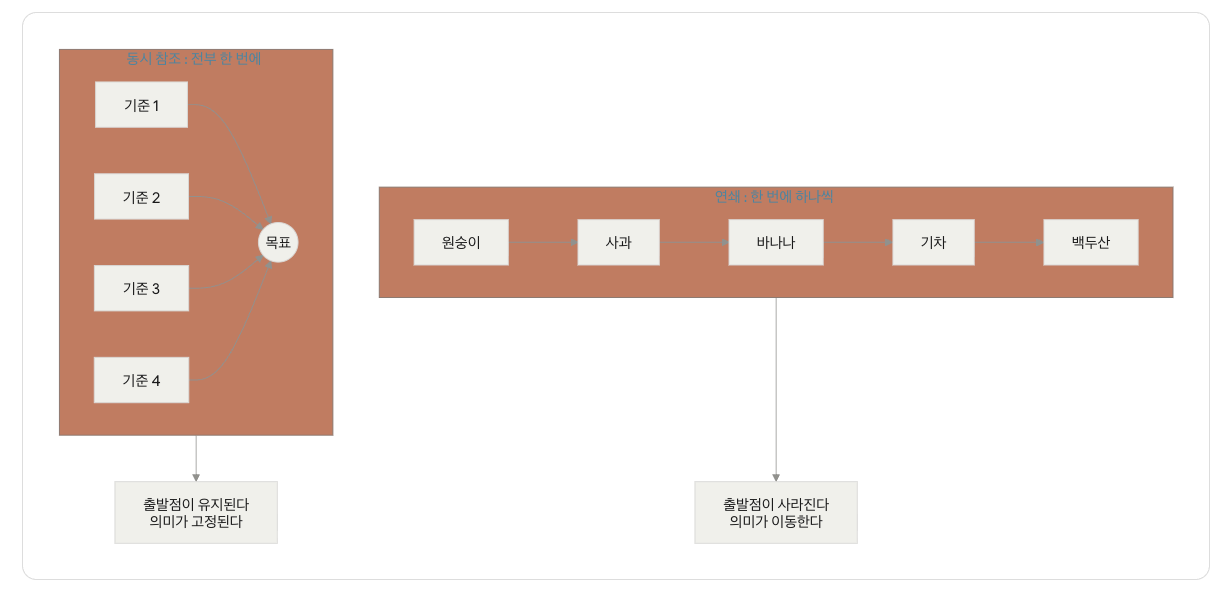
노래는 한 번에 한 걸음씩 갑니다. 각 단계에서 앞의 정보를 버립니다. 사과에 도착하는 순간 원숭이는 사라집니다. 그래서 원숭이에서 출발해 백두산에 도착합니다. 도달한 것이 아니라 흘러간 것입니다.
삼각 측량은 모든 기준점을 동시에 붙잡습니다. 하나씩 갈아타지 않기 때문에 흘러가지 않습니다.
원숭이 노래를 강제로 모두 핵심키워드로 잡으면
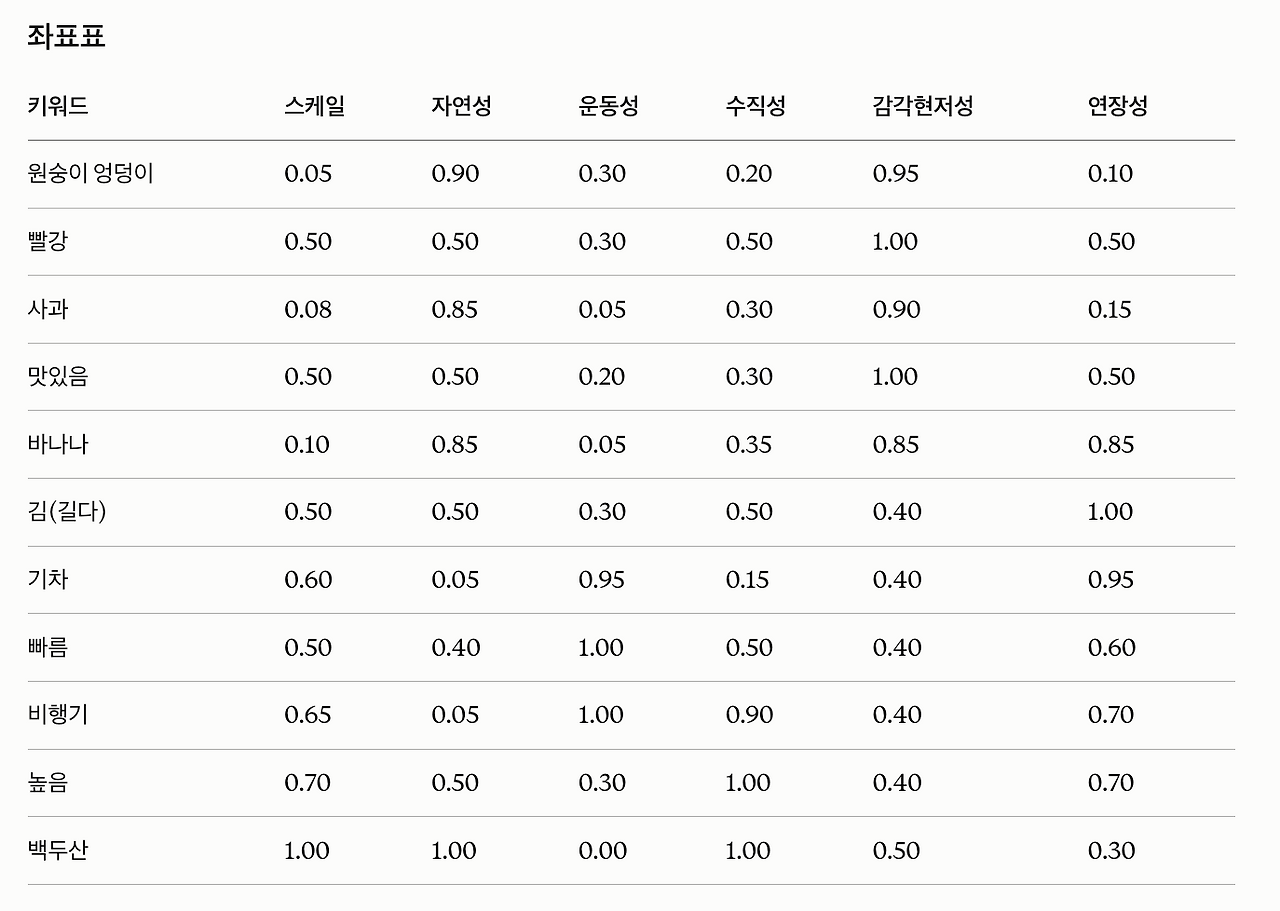
이 좌표를 강제명명하면
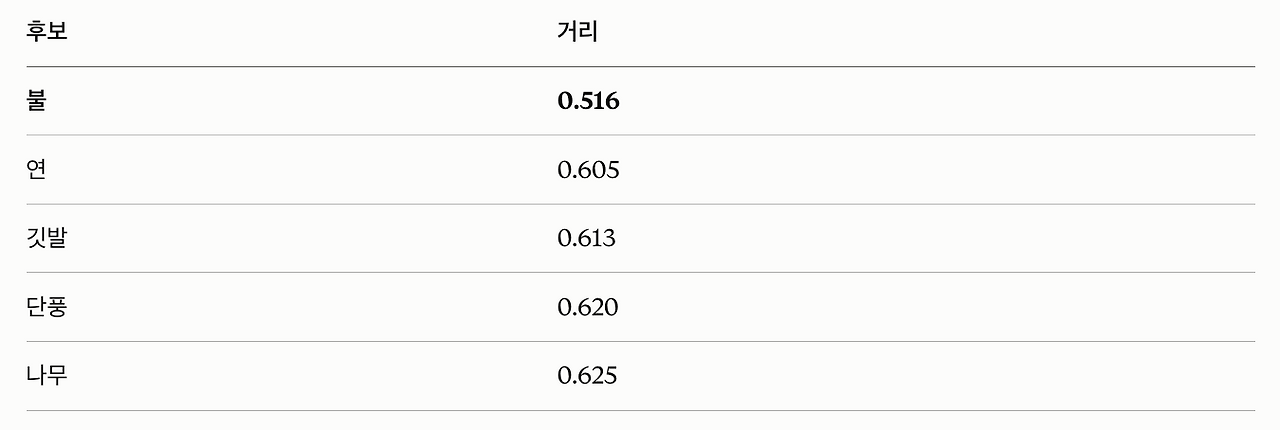
결과적으로 강제로 하나를 정하면 원숭이 똥구멍의 흐름의 중심점은 불(火) 입니다. 모든 단어와 연결됩니다. 붉고, 위로 솟고, 빠르게 움직이고, 혀가 길게 늘어나고, 감각적으로 강렬합니다. 맛있음은 직접 걸리지 않지만 조리를 매개로 연결됩니다. 그리고 백두산은 화산입니다. 연쇄의 종점이 중심값의 지질학적 형태라는 것은 우연이지만 쓸 만한 우연입니다.
다만 0.516은 가깝지 않습니다. 평균 반경의 72%입니다. 중심에 실제로 놓인 단어는 없습니다.
이것이 이 계산의 결론입니다. 중심값은 단어가 아니라 빈 자리입니다. 열한 개 키워드가 에워싼 좌표에는 아무것도 없고, 강제로 이름을 붙이는 순간 그 자리에 무언가가 생깁니다. 불이라고 부르기로 정하면 그 다음부터는 불입니다.
이 단계를 <제5차 컬트 커뮤니티의 시대> 의 컬드 수준으로 올리려면 상징의 상징성. 즉 인접 키워드의 다른 상징성까지 끌어와야 합니다. 제가 이 개념을 설명하기 위해 상관도 없는 원숭이를 데려왔듯. 그저 이 원숭이가 독자들이 알아듣는 키워드이기 때문입니다. 인접 세계관 연결을 위한 관계키워드인거죠.
그래서 컬트와 세계관의 물리·형태 7축, 감각 5축, 기원 4축, 기호 5축, 서사·시간 5축, 공동체 3축을 추가하면... (6축에서 29축으로 늘리면 공간이 넓어져 반경도 커집니다. 두 퍼센트는 각자의 반경 기준입니다.)
원숭이 엉덩이 : 체내와 체외의 구멍
빨강 : 경고색. 넘지 말라는 표시
사과 : 금지를 넘게 만든 사물
맛있음 : 바깥이 안으로 들어오는 문턱
바나나 : 껍질. 벗겨야 열림
김(길다) : 선. 선은 그 자체로 경계
기차 : 역과 국경을 통과하는 장치
빠름 : 경계를 지워버리는 속성
비행기 : 영공을 침범함
높음 : 지상과 천상의 분할
백두산 : 국경 그 자체. 천지는 경계의 물
강제 확정 중심값 = 꿰미 (貫)
밧줄과 구멍입니다.
읽으면 이렇게 됩니다. 원숭이 엉덩이라는 구멍에서 출발해, 빨강과 맛과 길이와 속도와 높이라는 끈을 타고, 백두산 천지라는 구멍에 도달합니다. 열한 개는 나열이 아니라 하나의 꿰미입니다. 구멍과 구멍을 끈으로 이은 것.
꿰는 행위는 반드시 무언가를 통과합니다. 통과가 상수였습니다. 꿰미는 중심이 아닙니다. 평균 반경의 56% 지점입니다. 25개 후보를 다 대봤지만 중심에 놓인 기존 단어는 없습니다.
중심 좌표는 비어 있습니다. 꿰미는 제가 그 자리에 강제로 끌어다 놓은 것입니다. 이 배치는 측정이 아니라 결정이고, 결정한 순간부터 그 자리는 꿰미입니다.
호명불가 축이 0.264로 29축 중 최하위라는 사실이 여기서 의미를 갖습니다. 중심 좌표는 이름이 반드시 있어야 하는 자리입니다. 그런데 그 이름이 없습니다. 반드시 명명되어야 하는데 아무도 명명하지 않은 자리. 그 자리에 누군가 이름을 박으면 그것이 코드가 됩니다.
기술적으로는 환각입니다. 저는 존재하지 않는 개념에 이름을 붙였습니다. 그리고 다음에 같은 열한 개를 같은 축으로 재면 같은 자리가 나오고, 같은 이름이 붙습니다. 반복 가능한 환각입니다.
컬트에게는 코드가 됩니다.
9. 그래서 무엇을 만들 것인가
목표는 문자를 없애는 것이 아닙니다. 문자를 없애는 것 자체에는 아무 가치가 없습니다.
문제는 문자가 아니라 해석의 폭입니다. 산문으로 쓴 세계관 문서는 열 사람이 열 가지로 읽습니다. 좌표는 하나로 읽힙니다. 가치는 문자 제거가 아니라 해석 폭 제거에 있습니다.
그래서 목표는 셋입니다.
세계관 설정을 문서가 아니라 좌표 관계로 보관하기
새로 쓴 원고가 그 관계를 어기는지 자동으로 검출하기
번역과 파생 제작에서 개념이 흘러가는 것을 막기
작업 절차의 이름을 붙이자면 이렇습니다.
ARVT : Anchor-based Relative Vector Triangulation for Latent Worldbuilding (앵커 기반 상대 벡터 삼각 측량을 이용한 세계관 좌표화 절차)
기술 원리는 학계의 것입니다. 이름을 붙일 대상은 그 위에 얹는 세계관 작업 절차뿐입니다.
측정 계획
앞서 추산한 앵커 수는 이론적 상한입니다. 실제 값은 재봐야 나옵니다. 다행히 이건 논쟁할 문제가 아니라 측정할 문제이고, 측정할 데이터가 이미 있습니다.
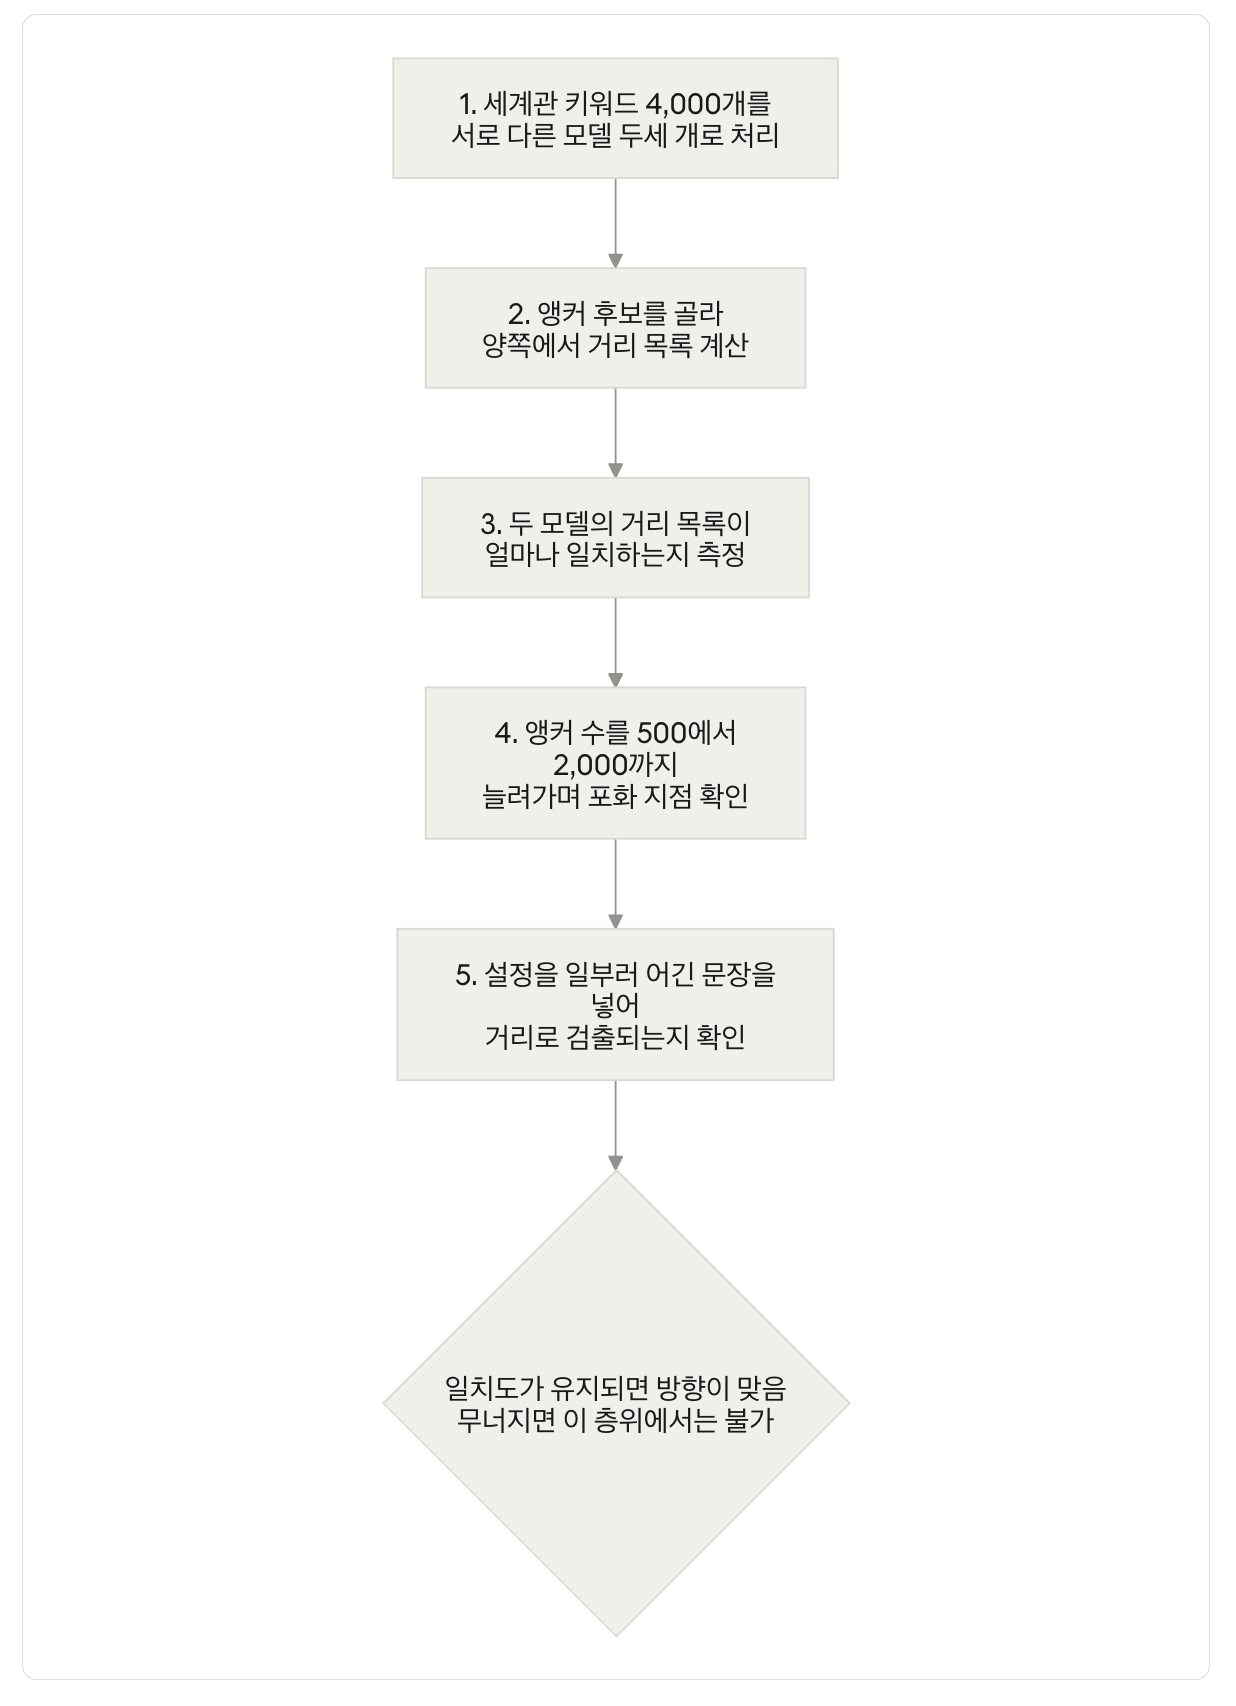
세계관 키워드 그래프의 유효 축이 몇 개에서 포화하는가. 아직 아무도 물어본 적 없는 질문입니다.
단어 하나의 무게
컴퓨터 공학 초기에 미래에는 단어 하나를 표현하는 데 1바이트가 아니라 훨씬 큰 용량이 들 것이라는 예측이 있었습니다.
계산해 보겠습니다. 앵커 2,000개와의 거리를 4바이트 실수로 저장하면 8킬로바이트입니다. 반정밀도로 줄이면 4킬로바이트입니다.
1바이트에서 8킬로바이트. 8,000배입니다. 예측의 방향은 맞았고 규모는 그보다 작습니다.
이 8킬로바이트가 무엇을 담고 있는지가 중요합니다. "사과"라는 두 글자에는 사과에 대한 정보가 없습니다. 발음 기호일 뿐입니다. 8킬로바이트에는 그 단어가 다른 2,000개 개념과 맺는 관계가 전부 들어 있습니다.
세계관 문서가 매번 흔들리는 이유가 여기 있습니다. 우리는 관계를 서술로 적어 왔습니다. 서술은 읽을 때마다 조금씩 달라집니다. 관계를 숫자로 적으면 달라지지 않습니다.
문자를 버리자는 이야기가 아닙니다. 문자는 사람이 읽는 층에 그대로 있으면 됩니다. 그 아래에 흔들리지 않는 층이 하나 더 있어야 한다는 이야기입니다.
모스 부호를 치던 손끝에서 시작한 질문의 답은, 결국 이미 나와 있는 기술을 아직 아무도 대보지 않은 대상에 대보는 일이었습니다. 다음 글에서는 실제로 재본 결과를 적겠습니다.
이 글에서 쓴 용어
헤드 카피 : 문자로 옮기지 않고 소리 패턴에서 곧바로 의미를 파악하는 상태. 아마추어 무선 용어.
Protobuf / CBOR : 양쪽이 설계도를 공유하고 이진 데이터만 주고받는 직렬화 방식.
VQ-VAE 코드북 : 연속적인 잠재 공간을 유한한 대표 벡터 집합으로 나눈 모델 자체의 사전.
상대 표상 : 데이터를 절대 좌표가 아니라 기준 샘플들과의 유사도 목록으로 표현하는 방식. 2022년 제안.
병렬 앵커 : 두 모델이 각각 처리한 동일한 기준 샘플 묶음. 상대 표상이 작동하기 위한 전제 조건.
Zero-shot Model Stitching : 재학습 없이 서로 다른 모델의 부품을 이어 붙이는 기법.
플라토닉 표상 가설 : 서로 다른 모델이라도 같은 세계를 학습하면 내부 구조가 비슷하게 수렴한다는 가설.
Johnson-Lindenstrauss 경계 : N개 점의 거리 관계를 오차 ε 안에서 보존하는 데 필요한 축의 수가 log N에 비례한다는 정리.
 불빛을 품은 암흑의 소용돌이
Copyright 김동은WhtDrgon, 메제웍스 2026