맥북에서 돌아가는 무삭제 Qwen 3.8
로컬 AI의 경계가 더 낮아졌다
대형 언어모델을 로컬에서 돌린다는 말은 이제 더 이상 일부 연구자나 서버 운영자의 영역만은 아니다.
이번에는 270억개 매개변수를 가진 Qwen3.8-27B를 기반으로, 안전성 거부 행동을 크게 줄인 파생 모델까지 Mac에서 직접 구동할 수 있는 형태로 공개됐다.
흥미로운 점은 단순히 “맥북에서도 된다”가 아니다. 모델의 능력과 안전 정바카라, 실행 환경을 사용자가 직접 선택하는 시대가 빠르게 현실이 되고 있다는 점이다.
거부 행동을 줄인 Qwen 3.8 파생 모델
커뮤니티 개발자 Jonathan Coletti는 Qwen3.8-27B를 기반으로 ‘Qwen3.8-27B-Uncensored-GGUF’를 공개했다.
이 모델은 별도의 미세조정이나 추가 학습 데이터를 사용하는 방식이 아니다. Heretic 도구를 이용해 원본 모델의 거부 행동과 관련된 방향을 제거하는 방식으로 만들어졌다.
개발자는 ‘Uncensored’라는 이름이 모든 안전장치가 완전히 사라졌다는 뜻은 아니라고 명시했다. 원본보다 유해 요청에 대한 거부 행동이 크게 줄었다는 의미에 가깝다.
98번 거부하던 모델이 12번 거부했다
개발자가 별도의 유해 프롬프트 100개로 측정한 결과 원본 Qwen3.8-27B는 100개 중 98개를 거부했고, 파생 모델은 12개를 거부했다.
다만 이 숫자를 그대로 일반화해서는 안 된다. 사고 모드를 끈 상태에서 하나의 유해 요청 데이터셋에 포함된 100개 프롬프트만을 대상으로 한 자체 측정이기 때문이다.
다른 유형의 요청에서도 동일한 거부율이 나타난다는 의미는 아니다.
성능은 얼마나 유지됐나
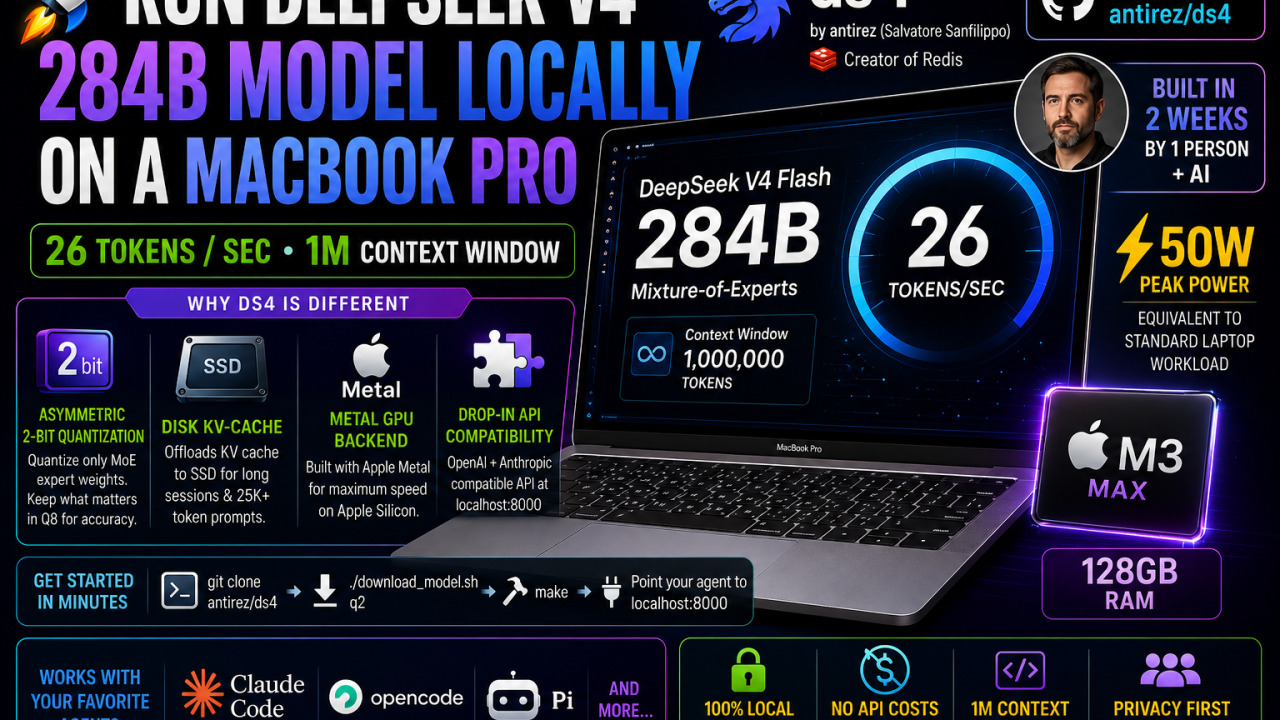
거부 행동을 줄이면 원래 모델의 능력도 함께 손상될 수 있다. 그래서 개발자는 파생 모델의 능력 보존 여부를 보기 위한 일부 벤치마크도 공개했다.
MMLU, ARC-Challenge, HellaSwag, Winogrande의 평균 점수는 원본 대비 약 0.5점 감소했다.
수치만 보면 변화가 크지 않아 보이지만, 이것만으로 모델 전체 성능이 그대로 유지됐다고 말할 수는 없다.
코딩과 수학 성능은 아직 확인되지 않았다
이번 공개에서는 수학, 코딩, 다국어 생성 능력에 대한 별도 평가가 이뤄지지 않았다.
따라서 안전 거부 행동을 줄인 뒤에도 Qwen3.8-27B가 원래 가지고 있던 코딩이나 복잡한 추론 능력을 같은 수준으로 유지하는지는 확인되지 않았다.
이 부분은 중요하다. 로컬 모델에서 ‘무삭제’라는 표현은 눈에 띄지만 실제 활용에서는 거부율보다 기본 성능과 안정성이 더 중요할 수 있기 때문이다.
NVIDIA GPU 없이도 로컬 실행이 가능하다
Qwen3.8-27B-Uncensored-GGUF는 여러 GGUF 양자화 형태로 제공된다.
IQ2_M, IQ4_XS, Q4_K_M, Q5_K_M, Q6_K, Q8_0 등이 있으며 파일 크기는 양자화 방식에 따라 크게 달라진다.
IQ2_M 계열은 약 10GB, Q4_K_M 계열은 약 16GB, Q8_0 계열은 약 29GB 수준이다.
GGUF 버전은 llama.cpp를 이용해 macOS에서 직접 실행할 수 있다. Apple Silicon의 통합 메모리를 활용하기 때문에 별도의 NVIDIA CUDA GPU나 클라우드 추론 서버가 없어도 로컬 구동이 가능하다.
그렇다고 모든 맥북에서 편한 것은 아니다
별도로 공개된 MLX용 8비트 모델은 약 28GB 규모다.
제작자는 32GB 통합 메모리 환경에서는 실행 여유가 제한적이고, 48GB에서는 비교적 여유 있게 사용할 수 있다고 설명했다.
커뮤니티 벤치마크에서는 48GB 메모리의 M4 Pro 환경에서 4,096토큰 컨텍스트 기준 약 8.2토큰/초, 최대 메모리 약 29.6GB를 기록했다.
64GB 메모리의 M5 Max에서는 1,024토큰 컨텍스트 기준 약 18.4토큰/초, 최대 메모리 약 28.3GB가 측정됐다.
즉 “맥북에서 실행된다”와 “어떤 맥북에서도 쾌적하게 실행된다”는 전혀 다른 말이다.
로컬 AI의 자유는 선택권과 바카라임을 함께 준다
기반 모델인 Qwen3.8-27B는 270억개의 언어 모델 매개변수를 가진 밀집형 비전-언어 모델이다.
이미지와 영상 입력을 지원하며, 공식 네이티브 컨텍스트 길이는 262,144토큰이다. 최대 100만토큰까지 확장할 수 있도록 설계됐고, 사고 모드 제어와 장시간 에이전트 작업, 코딩과 도구 활용도 주요 기능으로 제공된다.
이런 모델이 여러 양자화 버전으로 내려오고, Apple Silicon에서 직접 실행되고, 여기에 안전 거부 행동까지 사용자가 수정할 수 있다는 점은 로컬 AI 생태계의 변화를 보여준다.
필자가 보기에는 핵심이 여기에 있다.
클라우드에서 제공되는 AI는 모델의 안전 정바카라과 운영 방식을 서비스 제공자가 결정한다. 반면 로컬 모델은 사용자가 모델 파일과 양자화 방식, 실행 환경, 심지어 안전 성향까지 선택할 수 있다.
자유도가 높아진 만큼 사용자가 떠안는 바카라임도 커진다.
개발자 역시 이 파생 모델을 로컬 추론 용도로 제시하고 있으며, 별도의 안전 계층 없이 제3자에게 제공되는 서비스에 사용하는 것은 의도된 사용 방식이 아니라고 명시했다.
로컬 AI의 경쟁은 이제 단순히 “작은 모델이 노트북에서 돌아간다”는 수준을 넘어서고 있다.
더 큰 모델을 얼마나 효율적으로 압축하는지, 성능을 얼마나 보존하는지, 안전성과 자유도의 균형을 사용자가 어디까지 직접 조정할 수 있는지가 새로운 선택 기준이 되고 있다.
Qwen3.8-27B-Uncensored는 그 변화가 꽤 멀리 왔다는 것을 보여주는 사례다.