로봇은 이제 영상을 보고 배운다
한 번의 시연이 바꾸는 로봇 학습
사람은 누군가 하는 모습을 한 번 보고도 대략 무엇을 해야 하는지 이해한다. 하지만 로봇에게 새로운 일을 가르치는 과정은 지금까지 그렇게 간단하지 않았다.
Skild AI가 공개한 로봇 파운데이션 모델 ‘S1’은 이 간극을 줄이려는 시도다. 핵심은 새로운 작업을 배울 때마다 모델을 다시 미세조정하는 대신, 한 편의 비디오 시연을 그대로 컨텍스트로 삼아 행동한다는 데 있다.
중요한 변화는 단순히 “영상을 본다”는 사실이 아니다. 로봇 학습에서 새로운 작업 하나를 추가하는 비용과 시간을 크게 줄일 수 있는 방식이 등장했다는 점이다.
영상을 보여주면 바로 행동한다
S1은 사람이 작업하는 비디오를 입력받은 뒤 그 장면을 그대로 복제하는 방식으로 움직이지 않는다. 시연자의 의도와 작업이 어떤 단계로 진행되는지를 파악한 뒤, 현재 로봇과 실제 환경에 맞는 행동으로 바꾸도록 사전학습됐다.
시연 영상과 로봇이 놓인 현실은 같지 않아도 된다. 카메라 시점이 다르거나 물체의 위치가 달라지고, 시연에 등장한 형태와 실제 로봇의 형태가 달라도 작업을 이어가는 것을 목표로 한다.
공개된 사례에는 화분에 식물 심기, 팬케이크 만들기, 푸어오버 커피 만들기, 키트 조립처럼 여러 단계를 거쳐야 하는 작업이 포함됐다. 회사는 이 작업들이 사전학습 과정에서 다루지 않았던 것이라고 설명했다.
학습 대신 컨텍스트를 바꾼다
여기서 중요한 개념이 인컨텍스트 러닝이다. S1은 새로운 작업이 들어올 때마다 별도의 미세조정이나 사후학습을 거쳐 모델 가중치를 바꾸는 대신, 현재 제공된 비디오를 참고 정보로 사용한다.
쉽게 말하면 로봇의 머리를 다시 훈련시키는 대신, 지금 해야 할 일을 보여주고 바로 실행하게 만드는 방향이다.
화분 심기 실험에서는 한 차례의 사람 시연 이후 로봇이 자율 실행을 시작하기까지 약 11분이 걸렸다고 보고됐다. 공개된 기록에서는 시연 영상 촬영이 오후 9시 22분에 끝났고, 실제 하드웨어 자율 실행은 오후 9시 27분에 시작됐다.
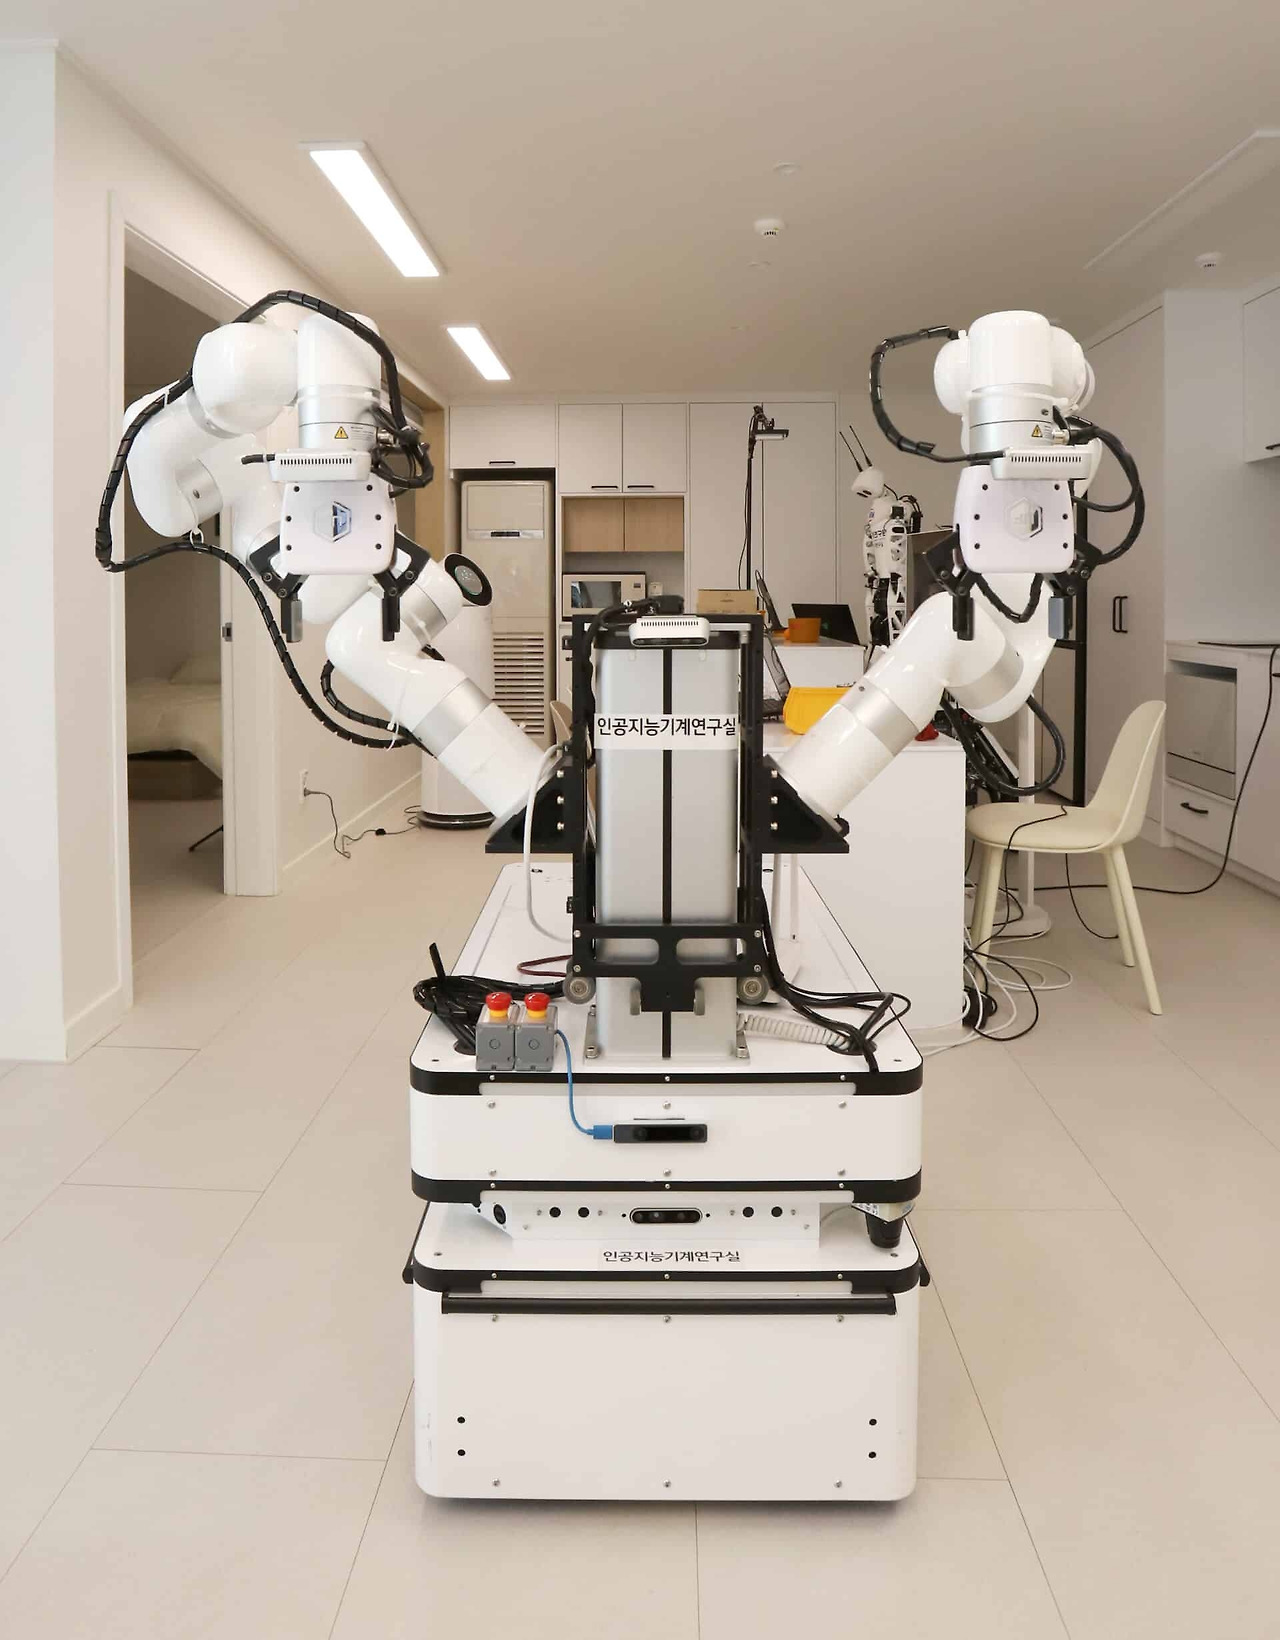
한 번의 시연이 380번과 비교됐다
Skild AI가 제시한 내부 평가 수치는 이 방식이 왜 주목받는지를 보여준다.
회사는 1,000시간에서 100,000시간 규모의 데이터셋을 이용해 인컨텍스트 방식과 언어 조건 기반 로봇 정바카라을 비교했다. 사전학습에 포함되지 않은 작업을 대상으로 100,000시간 데이터 규모에서 언어 조건 방식의 평균 단계별 성공률은 9%, 인컨텍스트 방식은 66%로 보고됐다.
다만 이 수치는 회사 내부 벤치마크에서 나온 결과다. 동일한 조건에서 독립적인 제3자가 같은 결과를 재현했는지는 아직 확인되지 않았다.
데이터 수집 비용을 줄일 수 있을까
더 흥미로운 비교는 새로운 작업을 가르치는 데 필요한 시연의 양이다.
Skild AI는 새로운 작업에 대해 단 한 번의 인컨텍스트 시연으로 얻은 성능이 기존 정바카라에 약 380회의 작업별 후속 시연을 사용해 사후학습한 경우와 비슷한 수준이었다고 보고했다.
회사의 추산에 따르면 4분 이상 걸리는 장기 작업에서 380회의 시연을 모으려면 약 50~100시간의 텔레오퍼레이션이 필요하다. 사람이 직접 로봇을 조작하며 반복 데이터를 만드는 시간이 그만큼 필요하다는 의미다.
물론 한 번의 시연이 모든 경우에서 더 좋은 것은 아니다. 같은 비교에서 인컨텍스트 방식은 한 번의 시연으로 66%의 성공률을 기록했고, 작업별 사후학습은 2,000회의 시연을 사용했을 때 86%까지 올라갔다.
즉 S1의 의미는 반복 학습 자체가 사라졌다는 데 있지 않다. 적은 준비로 새로운 작업을 시작할 수 있는 지점이 크게 앞당겨질 가능성에 있다.
로봇 파운데이션 모델이 노리는 것
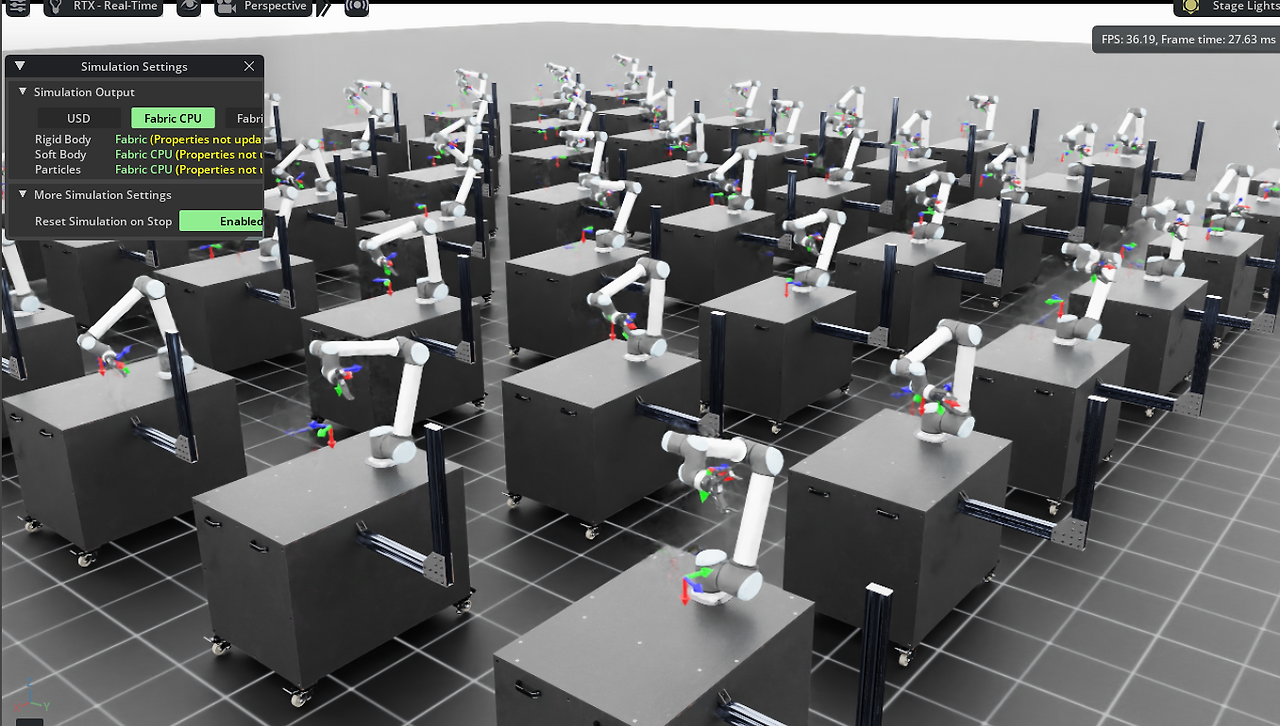
S1은 NVIDIA AI 인프라를 기반으로 다양한 로봇 데이터를 대규모로 학습하도록 구축됐다. Skild AI는 로봇 텔레오퍼레이션 데이터뿐 아니라 UMI 계열 데이터, 사람의 1인칭 영상, 시뮬레이션 등 서로 다른 성격의 데이터를 함께 확장하는 전략을 사용하고 있다고 밝혔다.
이 부분은 로봇 파운데이션 모델이 어디로 가고 있는지를 보여준다.
특정 로봇과 특정 작업만 잘하는 모델을 만드는 것이 아니라, 다양한 몸체와 환경에서 활용할 수 있는 범용적인 행동 능력을 하나의 모델에 축적하려는 방향이다.
공개된 시연에서는 작업 도중 물체 위치를 바꾸거나 물체 자체를 교체하고, 조명을 변경한 상황에서도 작업을 이어가는 사례가 제시됐다. 실행 중 실패가 발생했을 때 일부 행동을 다시 시도하거나, 시연 영상 안에 포함된 사람의 실수를 그대로 복제하지 않는 모습도 공개됐다.
복제가 아니라 의도를 읽는 방향
이 장면들이 흥미로운 이유는 로봇이 단순한 영상 복사 장치처럼 행동하지 않았기 때문이다.
시연 영상 속 손의 위치와 움직임을 그대로 재현하는 것만으로는 실제 환경이 달라졌을 때 대응하기 어렵다. S1이 지향하는 것은 영상에서 ‘어떤 행동을 했는가’보다 ‘무엇을 완성하려는가’를 읽어내는 쪽에 가깝다.
다만 공개된 물체 교체나 오류 복구 사례는 정성적인 시연이다. 몇 개의 성공 장면이 다양한 현실 환경에서 같은 수준의 안정성을 보장한다는 뜻은 아니다.
S1의 전체 모델 구조와 파라미터 수, 전체 사전학습 데이터 규모, 구체적인 학습 비용 역시 이번 공개만으로는 확인되지 않았다.
로봇도 범용 모델의 단계로 간다
필자가 이번 공개에서 가장 중요하게 보는 지점은 로봇에게 일을 가르치는 방식 자체가 바뀌고 있다는 점이다.
기존에는 새로운 작업을 추가할 때마다 새로운 데이터를 모으고, 다시 학습시키는 과정이 필요했다. S1이 보여주는 방향은 먼저 범용적인 로봇 모델을 크게 학습시켜 놓고, 새로운 작업은 짧은 시연을 통해 상황 안에서 이해시키는 방식이다.
이 구조가 충분히 확장된다면 로봇의 활용 방식도 달라질 수 있다. 작업 하나를 위해 로봇을 다시 만드는 것이 아니라, 이미 학습된 범용 모델에 새로운 예시를 제공하는 것으로 새로운 행동을 추가하는 방향이다.
Skild AI는 S1이 현재 상업적 파트너들과 실제 활용 단계에 들어가 있다고 밝혔다. 다만 파트너가 누구인지, 실제 배치 규모가 어느 정도인지는 공개되지 않았다.
또 회사가 주장하는 최대 약 10분 길이의 장기 작업 수행이나 인컨텍스트 학습 성능 역시 아직 자체 평가의 영역이 크다. 실제 산업 환경에서 반복적으로 동일한 성능을 보여주는지는 앞으로 더 확인해야 한다.
그럼에도 변화의 방향은 선명하다.
언어 모델이 긴 설명 대신 몇 개의 예시를 문맥에서 받아 새로운 문제를 처리하듯, 로봇도 이제 새로운 일을 배울 때마다 처음부터 다시 학습하는 대신 ‘보고 이해한 뒤 행동하는’ 모델을 향하고 있다.
로봇 파운데이션 모델의 경쟁은 결국 누가 더 많은 작업을 미리 학습했느냐만으로 결정되지 않을 수 있다.
처음 보는 일을 얼마나 적은 예시만으로 이해하고, 낯선 환경에서 얼마나 빠르게 행동으로 옮길 수 있는지가 다음 경쟁력이 될 가능성이 크다.