PostgreSQL 하나로 어디까지 가능한가
AI 시대의 시스템 단순화 전략
새로운 기능이 필요할 때마다 새로운 시스템을 붙이는 것이 정말 정답일까.
검색이 필요하면 Elasticsearch, 문서 저장이 필요하면 MongoDB, 큐가 필요하면 Kafka나 RabbitMQ, 캐시는 Redis, 시계열은 ClickHouse, 벡터 검색은 별도의 벡터 데이터베이스.
기능별로 가장 전문적인 도구를 선택하면 설계는 그럴듯해진다.
문제는 그다음부터다.
시스템이 하나 추가될 때마다 설치와 배포, 모니터링, 장애 대응, 백업, 권한 관리가 함께 늘어난다. 더 중요한 것은 서로 다른 저장소에 같은 데이터를 보내고 다시 맞춰야 하는 동기화 문제가 생긴다는 점이다.
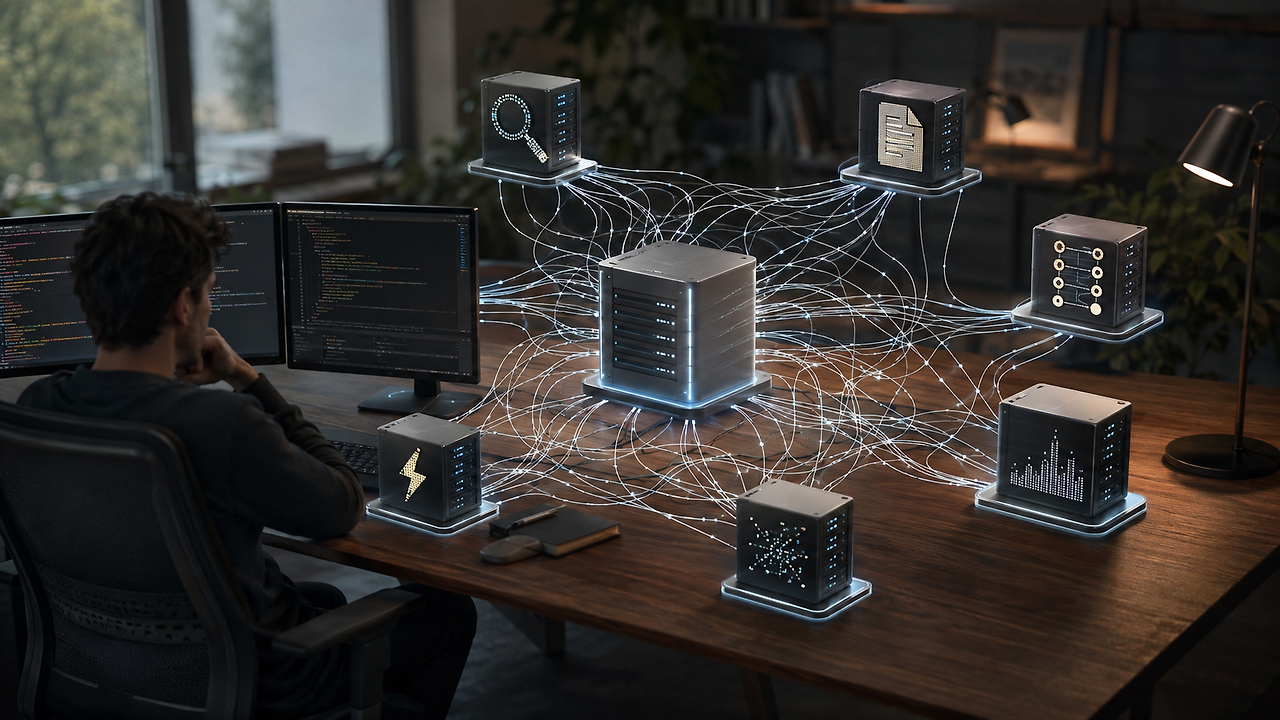
그래서 “PostgreSQL for Everything”이라는 접근이 흥미롭다.
PostgreSQL은 1986년 UC Berkeley의 POSTGRES 프로젝트까지 기원을 거슬러 올라가는 오래된 데이터베이스다. 하지만 지금의 PostgreSQL을 단순한 관계형 데이터베이스라고만 보는 것은 정확하지 않다.
JSON과 JSONB를 저장하고 검색할 수 있다.
tsvector와 tsquery를 이용해 전문 검색을 수행할 수 있고, GIN과 GiST 인덱스를 활용해 이를 가속할 수 있다.
SKIP LOCKED를 이용하면 특정 조건에서 작업 큐처럼 사용할 수도 있다.
ltree를 추가하면 계층 구조를 다룰 수 있고, pgvector를 설치하면 임베딩과 벡터 유사도 검색까지 연결할 수 있다. TimescaleDB 같은 확장을 사용하면 시계열 워크로드도 PostgreSQL을 중심으로 확장할 수 있다.
여기서 중요한 것은 “PostgreSQL이 모든 전문 시스템보다 뛰어나다”는 주장이 아니다.
오히려 반대에 가깝다.
새로운 인프라를 추가하기 전에 PostgreSQL로 충분한지 먼저 묻는 것.
AI 개발이 쉬워지면서 개인과 작은 팀이 더 복잡한 제품을 만들 수 있게 된 지금, 이 질문은 예전보다 훨씬 중요해졌다.
기능을 만드는 비용은 내려갔지만 여러 시스템을 운영하는 비용까지 사라진 것은 아니기 때문이다.
이후부터는 어떤 기능을 PostgreSQL에 남겨도 되는지, 언제 전문 시스템으로 분리해야 하는지, 그리고 개인 개발자와 작은 팀이 실제로 적용할 수 있는 판단 기준을 구체적으로 정리한다.
가장 먼저 계산할 것은 성능이 아니다
새로운 기술을 선택할 때 개발자는 벤치마크부터 보는 경우가 많다.
하지만 작은 팀이나 1인 개발자에게 첫 번째 질문은 오히려 다른 곳에 있어야 한다.
이 시스템을 하나 더 운영할 가치가 있는가.
PostgreSQL과 Elasticsearch를 함께 사용한다고 생각해보자.
검색 시스템 자체의 성능만 보면 Elasticsearch가 적합한 상황이 분명 존재한다.
하지만 애플리케이션의 원본 데이터가 PostgreSQL에 있다면 검색 시스템에도 데이터를 보내야 한다.
이때부터 문제가 하나 더 생긴다.
두 저장소의 데이터가 항상 같아야 한다.
검색 시스템이 잠시 멈췄다면 어떻게 복구할 것인가.
데이터 업데이트가 PostgreSQL에는 반영됐지만 검색 인덱스에는 실패했다면 어떤 상태를 진실로 볼 것인가.
즉 시스템 선택 비용에는 서버 비용만 있는 것이 아니다.
동기화 비용과 운영 복잡성이 포함된다.
‘전문 도구가 더 좋다’는 말의 함정
전문 도구는 대부분 자신이 해결하도록 만들어진 영역에서 강하다.
문제는 모든 서비스가 그 전문성의 최대치를 필요로 하는 것은 아니라는 점이다.
PostgreSQL의 전문 검색은 Elasticsearch나 Solr의 모든 검색 기능을 대체한다고 볼 수 없다.
하지만 서비스가 요구하는 검색이 문서 검색과 관련도 기반 검색 정도라면 PostgreSQL의 내장 전문 검색만으로 요구를 충족할 수도 있다.
JSON 문서를 저장한다고 해서 반드시 MongoDB가 필요한 것도 아니다.
PostgreSQL에는 JSON과 JSONB가 있다.
여기서 선택 기준은 “누가 기능이 더 많은가”가 아니다.
우리 서비스가 실제로 필요한 기능의 경계가 어디인가다.
큐 역시 같은 방식으로 봐야 한다
지금 바로 작가의 멤버십 구독자가 되어
멤버십 특별 연재 콘텐츠를 모두 만나 보세요.
AI 연구진행 중, 프롬프트 기획 전문가 & GPT전문강사, 강연자
오직 멤버십 구독자만 볼 수 있는,
이 작가의 특별 연재 콘텐츠
- 총 19개의 혜택 콘텐츠