T (검증) : 받은 다음이 진짜 시작이다
— 할루시네이션 제로는 수학적으로 불가능하다. 그래서 검증이 남는다
AI에게 일 시키는 기술 · CREST 시리즈 · 10편 (PART 2 완결)
"AI 할루시네이션을 완전히 제거하는 것은 수학적으로 불가능하다. 2025년 두 편의 독립 논문에서 증명되었고, OpenAI도 공식 인정했다." — AI 신뢰성 검증 비용 가이드 (2026.06)
사고 한 건에 2,500만 원
숫자부터 보겠습니다.
AI 할루시네이션 사고 1건당 비용. 고객 서비스 분야에서 약 18,000달러, 한화로 2,500만 원입니다. 의료 분야에서는 최대 240만 달러, 32억 원까지 보고되었습니다. 금융 분야는 분기당 평균 2.3건의 AI 오류가 발생하며, 건당 5만에서 210만 달러 범위입니다.
이것이 '검증하지 않은 AI 결과물'의 가격표입니다.
더 불편한 사실이 있습니다. 이 문제는 앞으로도 사라지지 않습니다. 2025년 두 편의 독립 논문이 증명했고 OpenAI도 공식 인정한 사실. AI 할루시네이션을 완전히 제거하는 것은 수학적으로 불가능합니다.
모델이 더 좋아지면 줄어들 것이라는 기대는 틀렸습니다. 줄어들긴 합니다. 그러나 0이 되지는 않습니다. 영원히.
그렇다면 남는 것은 하나뿐입니다. 검증(Test)입니다.
AI가 아무리 발전해도 할루시네이션은 0이 되지 않습니다. 검증은 임시 대바카라이 아니라, AI를 쓰는 한 영구적으로 필요한 구조입니다.
1. 왜 T가 CREST의 마지막인가 — 순서의 의미
CREST에서 T는 마지막입니다. 많은 분이 이것을 '덜 중요해서 뒤에 있다'라고 오해합니다. 사실은 정반대입니다.
T가 마지막인 이유는 두 가지입니다.
첫째, 앞의 네 요소가 완성돼야 검증이 의미를 가집니다.
맥락(C)이 없으면 무엇을 기준으로 틀렸다고 판단할지 알 수 없습니다. 역할(R)이 없으면 어떤 전문가 기준으로 검토할지 정해지지 않습니다. 기대 출력(E)이 없으면 형식이 맞는지 판단할 근거가 없습니다. 스타일(S)이 없으면 어조가 적절한지 알 수 없습니다. T는 앞의 네 가지가 있을 때 비로소 작동합니다.
둘째, T는 '마지막'이 아니라 '시작'입니다.
프롬프트 입력이 끝나면 일이 끝난 것처럼 느껴집니다. 결과물이 나왔으니까요. 그러나 실무에서 진짜 일은 그다음부터 시작됩니다. 이 결과물을 내 이름으로 내보낼 수 있는가. 이 질문에 답하는 과정이 T입니다.
AI가 결과물을 내놓은 순간은 일이 끝난 시점이 아닙니다. 검증이라는 진짜 일이 시작되는 시점입니다.
2. 검증의 세 층위 — 무엇을 무엇으로 확인하는가
검증은 단순히 '읽어보는 것'이 아닙니다. 세 개의 층위가 있고, 각 층위마다 확인 방법이 다릅니다.
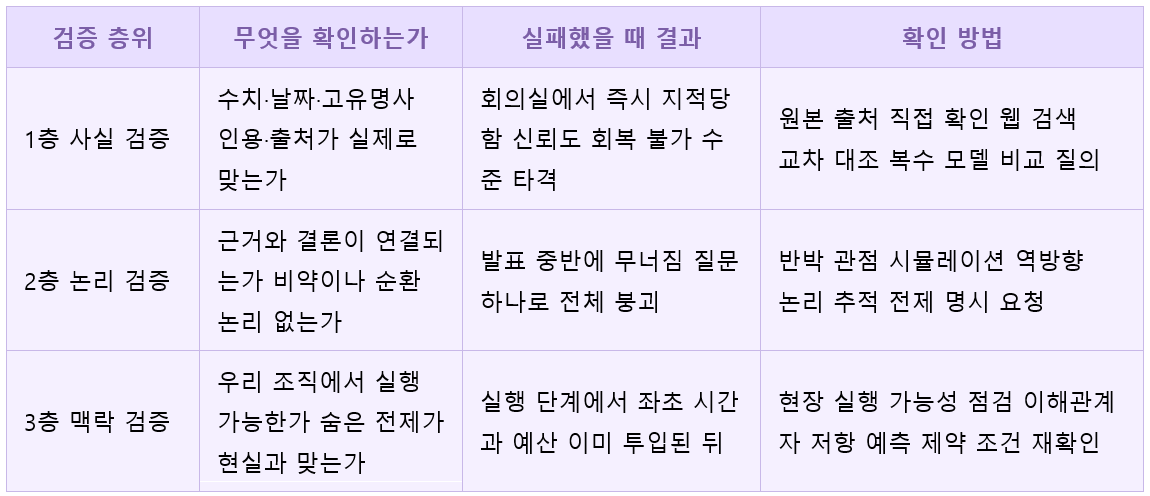
대부분의 사람은 1층만 확인합니다. 수치가 맞는지 보고 넘어갑니다. 그런데 실무에서 진짜 사고가 나는 곳은 2층과 3층입니다. 수치는 다 맞는데 논리가 비약한 보고서, 논리는 완벽한데 우리 조직에서는 실행할 수 없는 제안. 이런 것들이 회의실에서 무너집니다.
3. 결론 중심에서 근거 중심으로 — 구조를 뒤집는 한 줄
검증을 사후에 하는 것보다 좋은 방법이 있습니다. AI가 답을 쓰는 방식 자체를 바꾸는 것입니다.
ProB AI 연구소가 제안하는 방법이 특히 강력합니다. AI의 답변을 결론 중심 구조에서 근거 중심 구조로 뒤집는 것입니다.
일반적인 요청과 구조를 뒤집은 요청을 비교해 보십시오.
지금 바로 작가의 멤버십 구독자가 되어
멤버십 특별 연재 콘텐츠를 모두 만나 보세요.
현) 외국계 펀드 경영지원실 실장, 외국계 및 국내 대기업, 인수합병 및 PMI HR Professional로 25년 근무 국내 유수대학 강의 및 전) Kotra 공기업 위원
오직 멤버십 구독자만 볼 수 있는,
이 작가의 특별 연재 콘텐츠
- 최근 30일간 5개의 멤버십 콘텐츠 발행
- 총 32개의 혜택 콘텐츠